一、核心概览:不是 72 台服务器,而是一个巨型 GPU
🎯 核心理念
Vera Rubin NVL72 不是 72 颗 GPU 的简单堆叠,而是通过 NVLink 6 高速互联技术,将 72 颗 Rubin GPU 整合成一个逻辑上的机架级加速器。
这是英伟达从"卖 GPU"到"卖 AI 工厂"的战略转型——整柜预集成了芯片、互联、供电、液冷和软件栈,成为数据中心的即插即用算力单元。
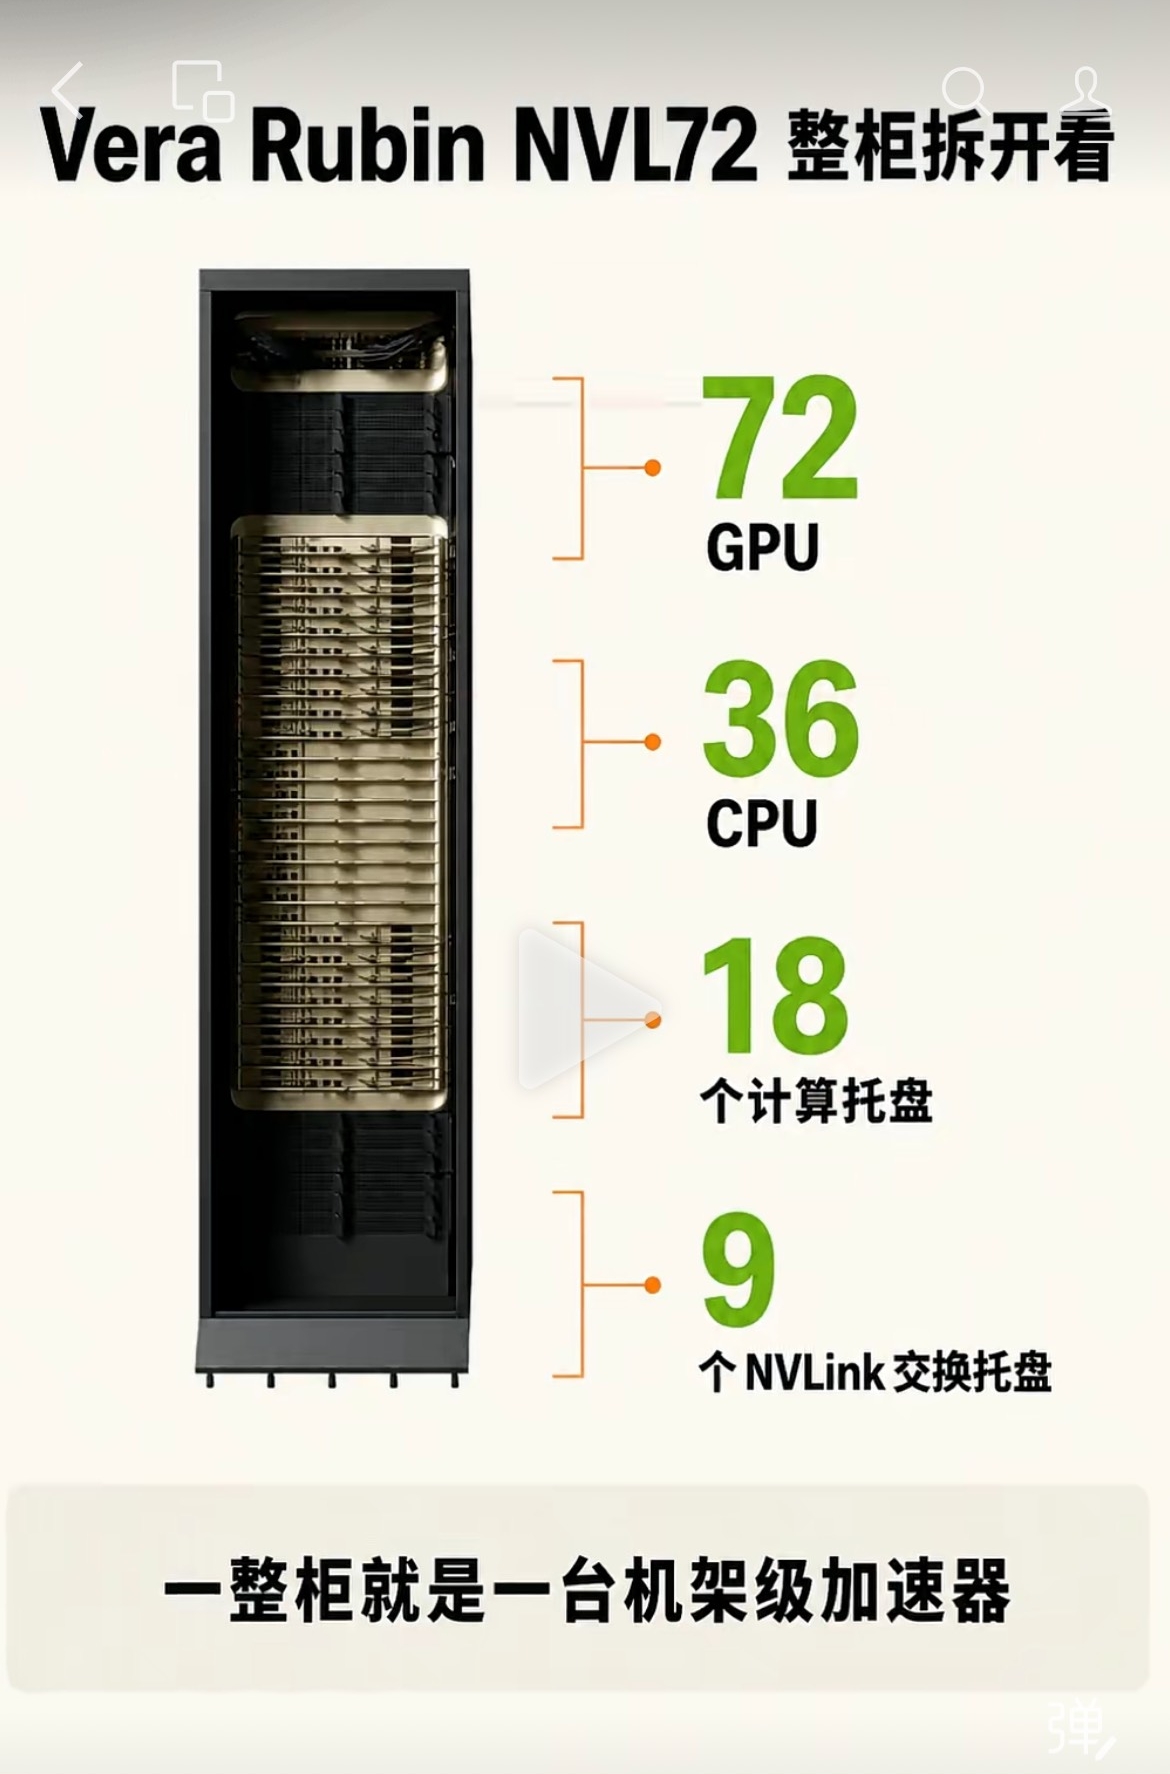
🔢 GPU 数量
72 × NVIDIA Rubin GPU
🧠 CPU 数量
36 × NVIDIA Vera CPU
共 3,168 个 Olympus 核心
⚡ 推理算力
NVFP4 推理性能
(稀疏计算)
🎓 训练算力
NVFP4 训练性能
(密集计算)
💾 GPU 内存
HBM4 高带宽内存
总带宽 1,580 TB/s
🔗 NVLink 带宽
NVLink 6 整柜互联
单 GPU 3.6 TB/s
⚡ 机架功耗
标称 120kW
满载实测 132kW
🔌 工作电压
中国 380V 兼容
需专用 PDU 适配
💰 机架价格
裸机 $3.1M
全配 $3.9M(估算)
系统构成
| 组件 | 数量 | 功能 |
|---|---|---|
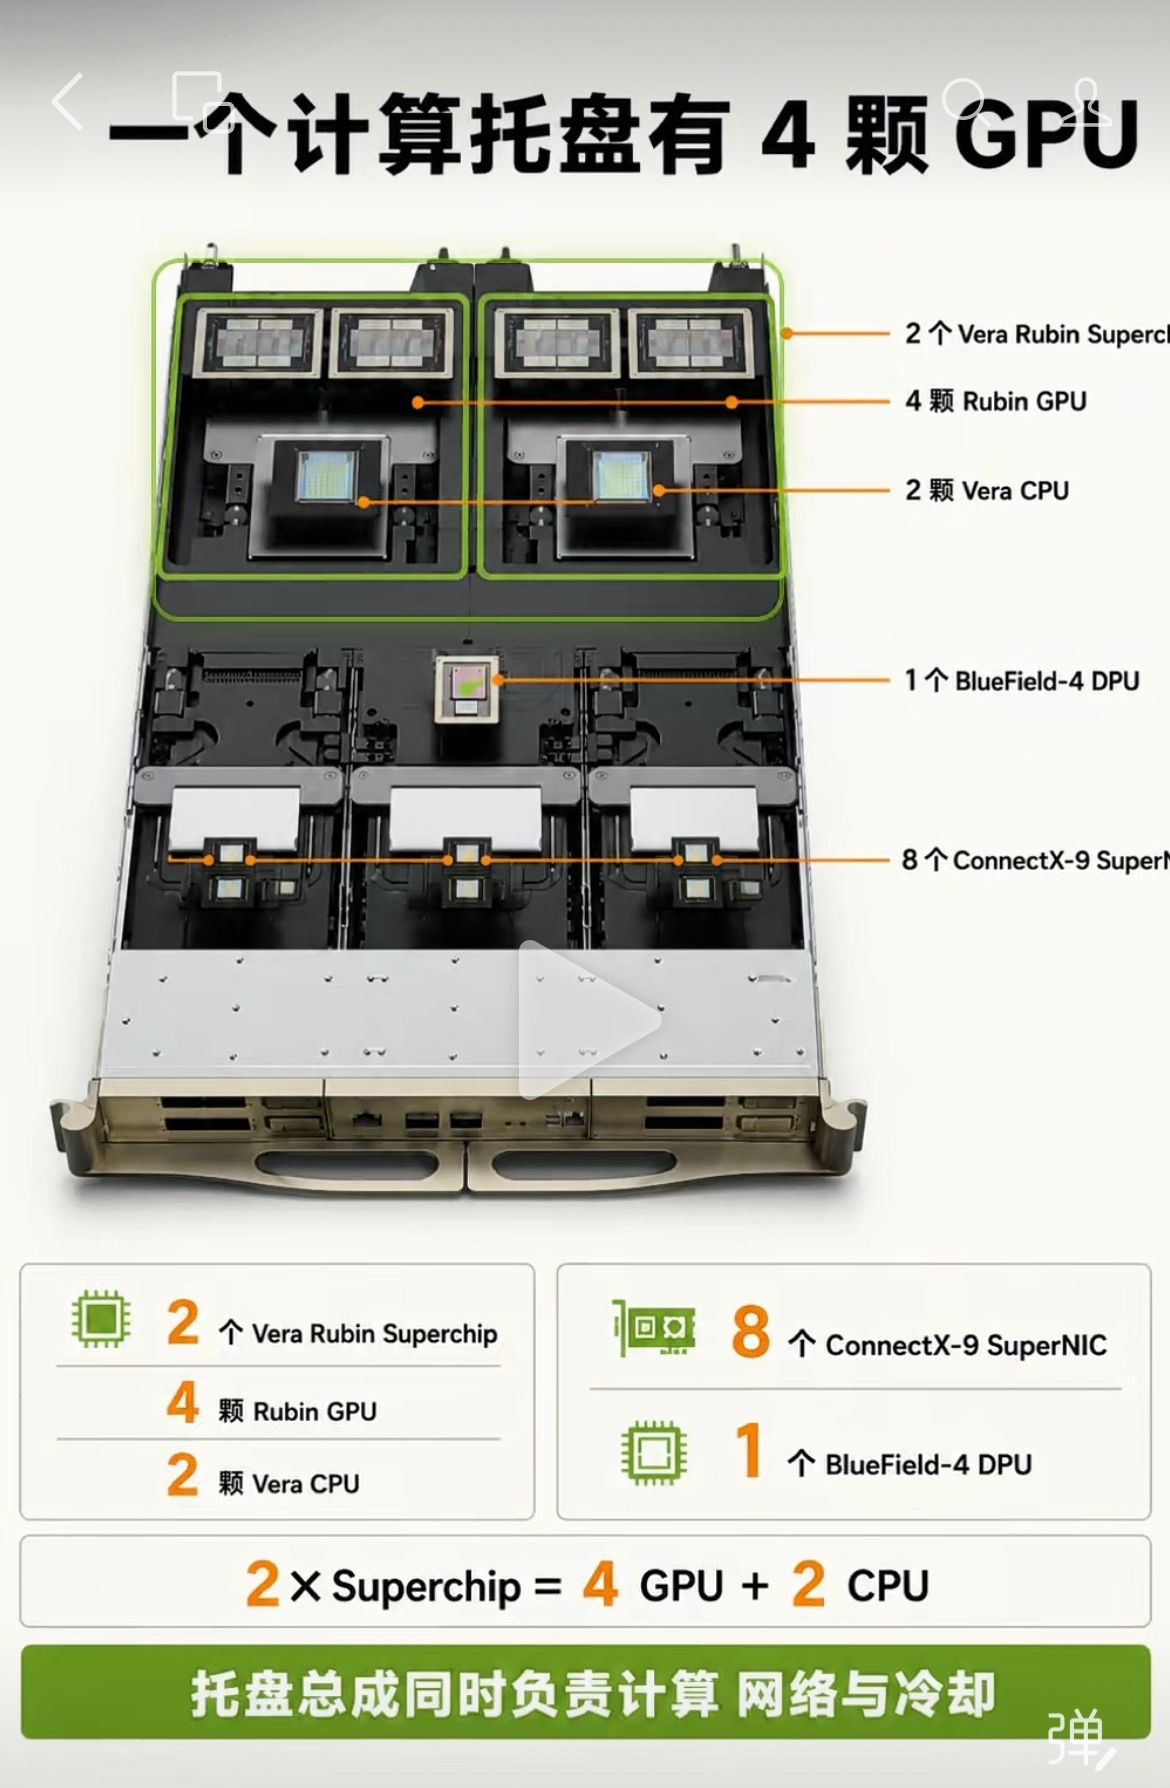
| 计算托盘 | 18 个 | 每个包含 4 颗 GPU + 2 颗 CPU + 1 个 DPU + 8 个 SuperNIC |
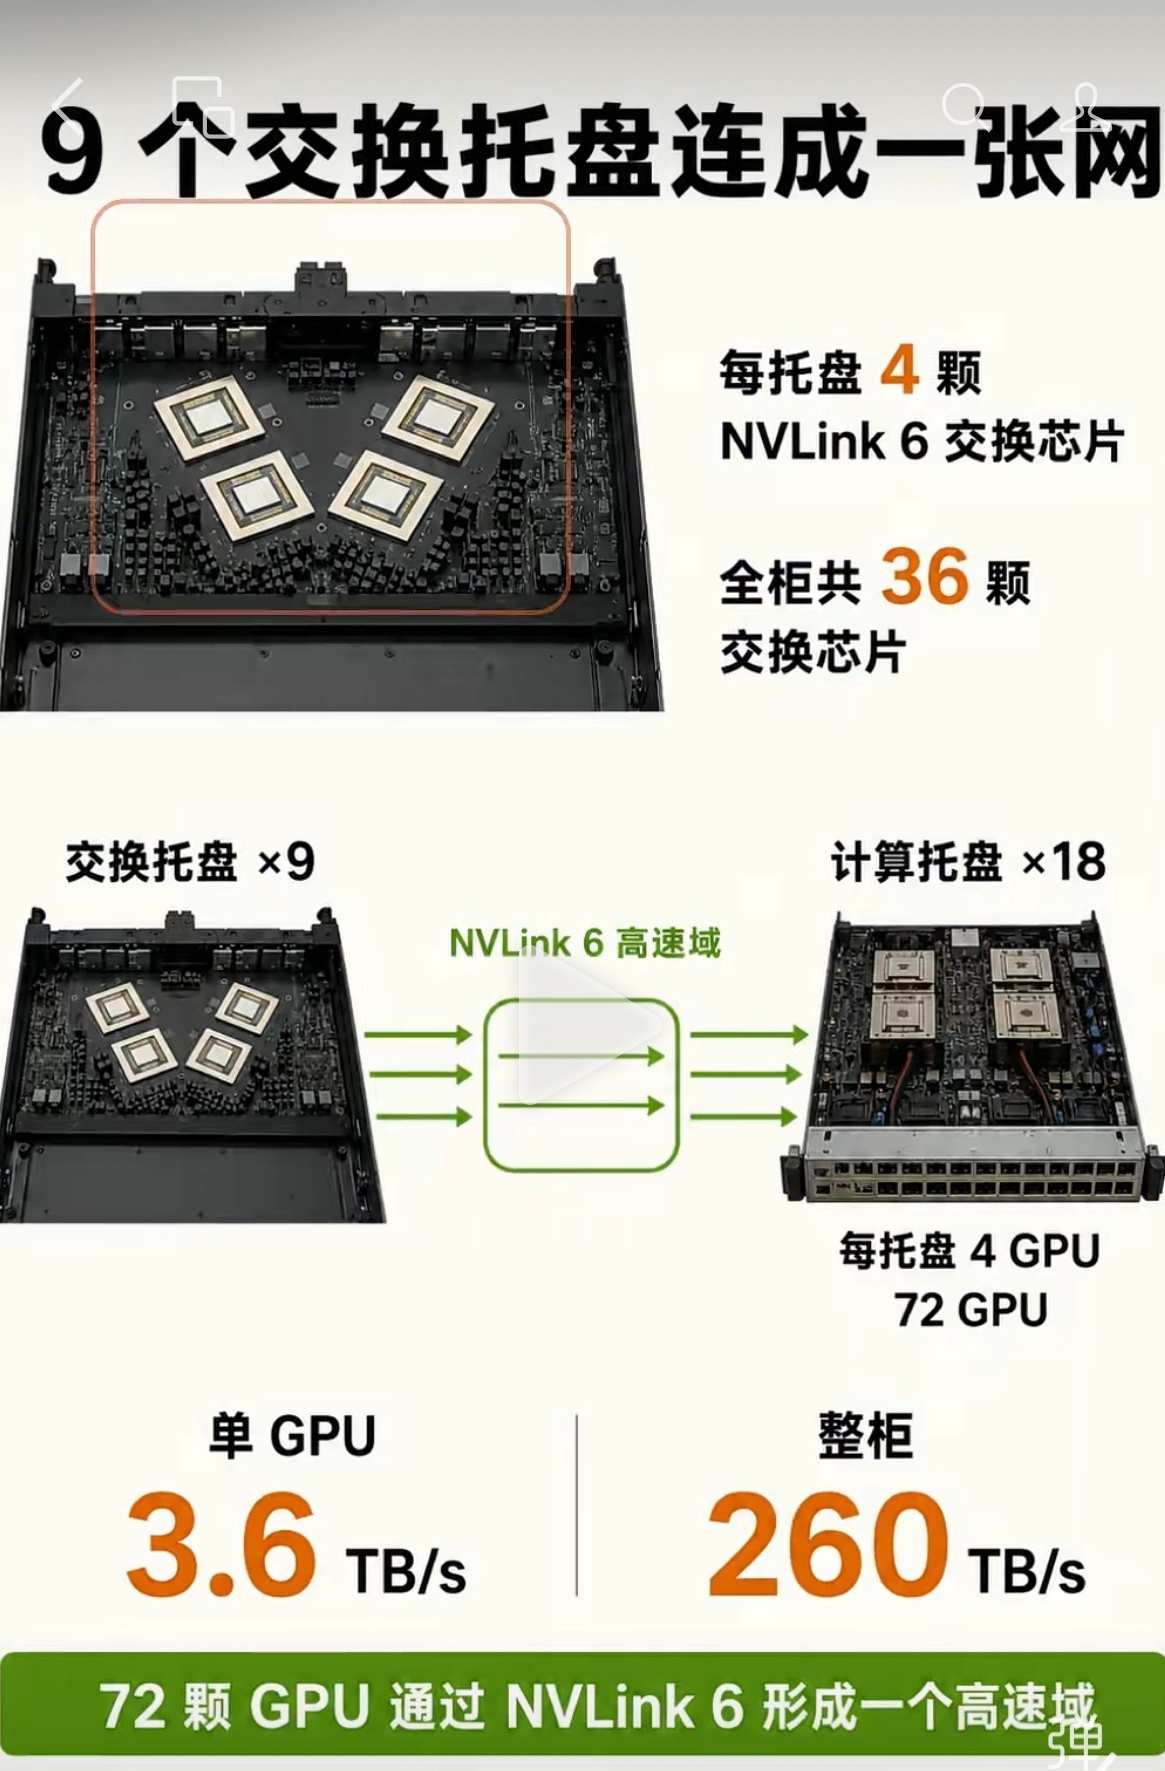
| NVLink 交换托盘 | 9 个 | 每个包含 4 颗 NVLink 6 交换芯片,共 36 颗 |
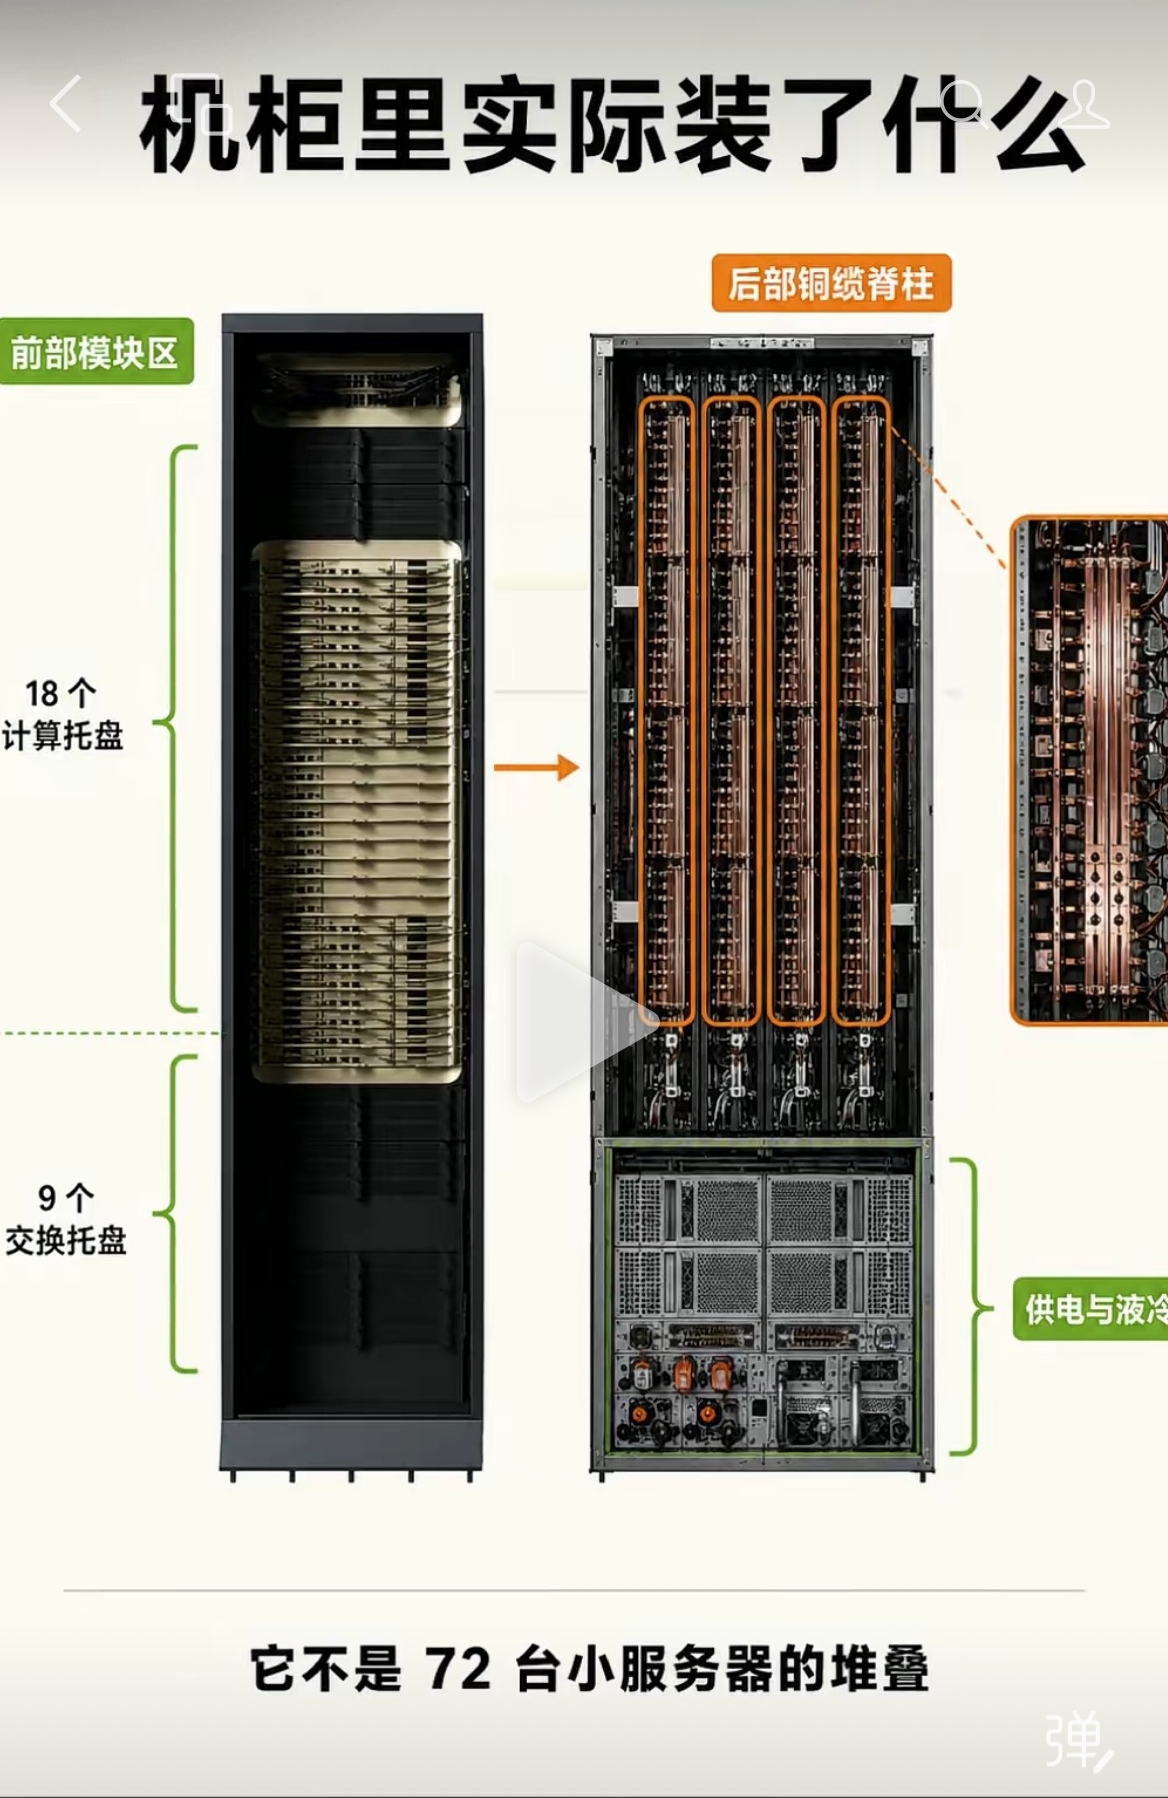
| 预集成铜缆 | ~5000 根 | 总长度超过 3.2 公里(2 英里),实现托盘间互联 |
| 液冷系统 | 1 套 | 45°C 温水进液,5000A 液冷母排 |
| 电容储能 | 72 组 | 每颗 GPU 配备 400J 储能电容,削峰 25% |
二、架构解析:六芯协同的极致共设计
🔬 极致共设计(Extreme Co-Design)
Vera Rubin 平台不是简单地将多个芯片组合在一起,而是从一开始就将六款芯片作为一个统一系统进行协同设计。这种"极致共设计"理念确保了各组件之间的无缝协作和最优性能。
2.1 六款核心芯片
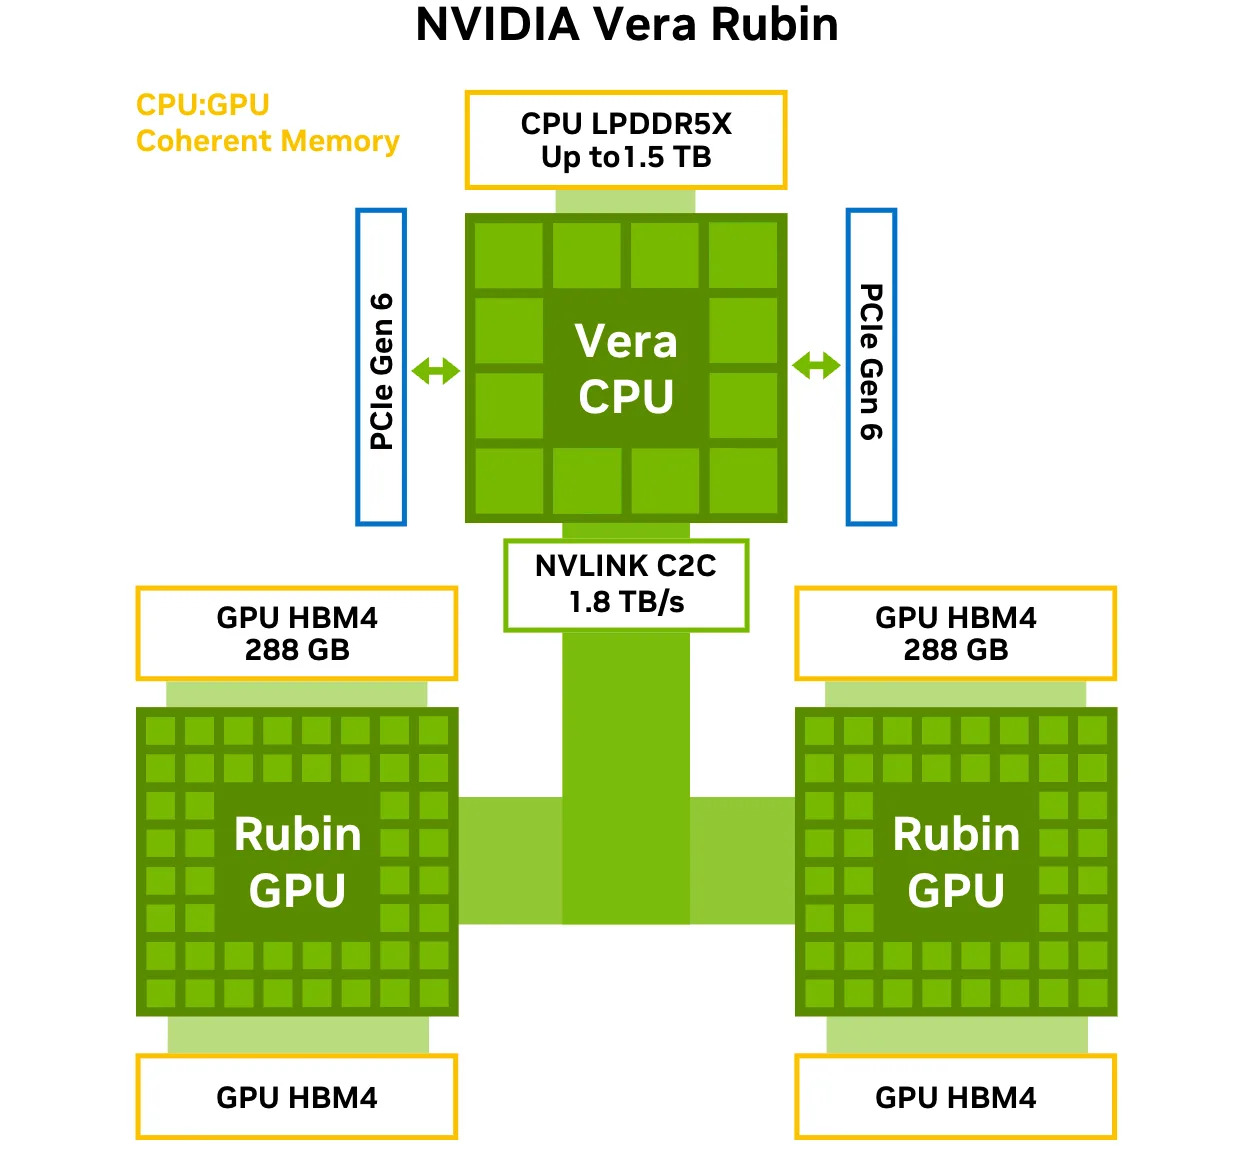
1️⃣ Vera CPU
自研 Arm 架构 88 核/芯片- 3,168 个 Olympus 核心(全柜)
- Arm 指令集兼容
- 54 TB LPDDR5X 内存(全柜)
- 专为代理型 AI 推理优化
- 高并发任务调度引擎
2️⃣ Rubin GPU
TSMC N3P 336B 晶体管- 双计算 Die 封装
- 288 GB HBM4 内存/GPU
- 22 TB/s 内存带宽/GPU
- 50 PFLOPS FP4 推理/GPU
- 第五代 Tensor Core
3️⃣ NVLink 6 交换机
400G SerDes 260 TB/s 总带宽- 3.6 TB/s 双向带宽/GPU
- 36 颗交换芯片(全柜)
- 无阻塞 All-to-All 拓扑
- 内置 SHARP 集合通信加速
- 双倍于 Blackwell 的带宽
4️⃣ ConnectX-9 SuperNIC
800 Gb/s Scale-out- 144 个 OSFP 单端口(全柜)
- InfiniBand / 以太网双模
- 28.8 TB/s 对外带宽(全柜)
- 硬件加速 RDMA
- 支持跨机柜扩展
5️⃣ BlueField-4 DPU
数据处理器 400 Gb/s- 18 个双端口(全柜)
- 存储/网络卸载
- 数据加密与压缩
- 虚拟化加速
- 安全隔离
6️⃣ Spectrum-6 交换机
以太网 柜间互联- 51.2 Tb/s 交换容量
- 64 × 800G 端口
- 超低延迟(<1μs)
- 自适应路由
- 支持 SuperPOD 扩展
2.2 计算托盘:高度集成的算力单元
🔧 计算托盘组成
- ✓ 2 个 Vera Rubin Superchip = 4 颗 Rubin GPU + 2 颗 Vera CPU
- ✓ 1 个 BlueField-4 DPU — 负责存储/网络卸载
- ✓ 8 个 ConnectX-9 SuperNIC — 负责 Scale-out 网络扩展
- ✓ 液冷冷板 — 托盘级热管理
- ✓ PCB 中板盲插接口 — 插入即完成所有互联
⚠️ 设计哲学:三大"无"
- 托盘内部无风扇 — 全液冷设计,噪音降至最低
- 无外接软管 — 液冷接口集成在盲插中板
- 无现场接线 — 所有铜缆预集成在机柜背部
运维人员只需插拔托盘,无需现场布线或接管,大幅降低部署复杂度。
🔧 GPU/CPU/DPU 更换便利性分析
模块化维护优势:
- ✓ 托盘级热插拔 — 计算托盘作为独立单元,前部插拔,故障恢复从天级降至分钟级
- ✓ 盲插式连接 — PCB 中板自动完成电源、NVLink、液冷、网络的所有连接
- ✓ 零布线操作 — 5000 根铜缆预集成在机柜背部,消除现场接线错误
- ✓ 标准化维护 — 拔出故障托盘,插入新托盘,即刻恢复运行
维护限制:
- ⚠️ 不支持芯片级更换 — GPU/CPU/DPU 焊接在托盘上,无法单独更换
- ⚠️ 最小更换单位 — 整个计算托盘(4 GPU + 2 CPU + 1 DPU + 8 SuperNIC)
- ⚠️ 单次成本较高 — 单个托盘价值约 $200K+,即使单芯片故障也需换整个托盘
- ⚠️ 需备件库存 — 建议备 5-10% 关键托盘(约 $200-400K)
| 维护维度 | 便利性 | 说明 |
|---|---|---|
| 托盘级更换 | ⭐⭐⭐⭐⭐ | 非常方便,分钟级完成,无需布线 |
| 芯片级更换 | ⭐⭐ | 不支持,必须更换整个托盘 |
| 维护复杂度 | ⭐⭐⭐⭐ | 极大简化了现场操作流程 |
| 经济性 | ⭐⭐⭐ | 单次更换成本高,但故障率低 |
设计理念:这是一种面向数据中心运维优化的设计——牺牲芯片级灵活性,换取快速故障恢复和零人为错误,非常适合云服务商和超大规模部署场景。对于需要频繁更换单个芯片的实验室环境,传统服务器架构可能更合适。
2.3 NVLink 6 交换拓扑:260 TB/s 无阻塞域
🌐 NVLink 6 技术突破
- 400G SerDes 技术 — 单通道速率翻倍
- 双向回声消除 — 减少电缆数量,降低功耗
- SHARP 内置计算 — 在网络中直接完成 All-Reduce 等集合操作
- 自适应路由 — 动态避开拥塞链路,保持高吞吐
- 容错设计 — 单链路故障不影响整体通信
| 指标 | 单 GPU | NVL72 整柜 |
|---|---|---|
| NVLink 带宽 | 3.6 TB/s(双向) | 260 TB/s(总带宽) |
| 延迟 | ~1.5 μs(GPU-GPU) | ~3 μs(全柜最远端) |
| 拓扑 | - | All-to-All 无阻塞 |
| 集合通信加速 | - | SHARP 内置计算 |
2.4 背后的铜缆脊柱:2 英里的预集成互联
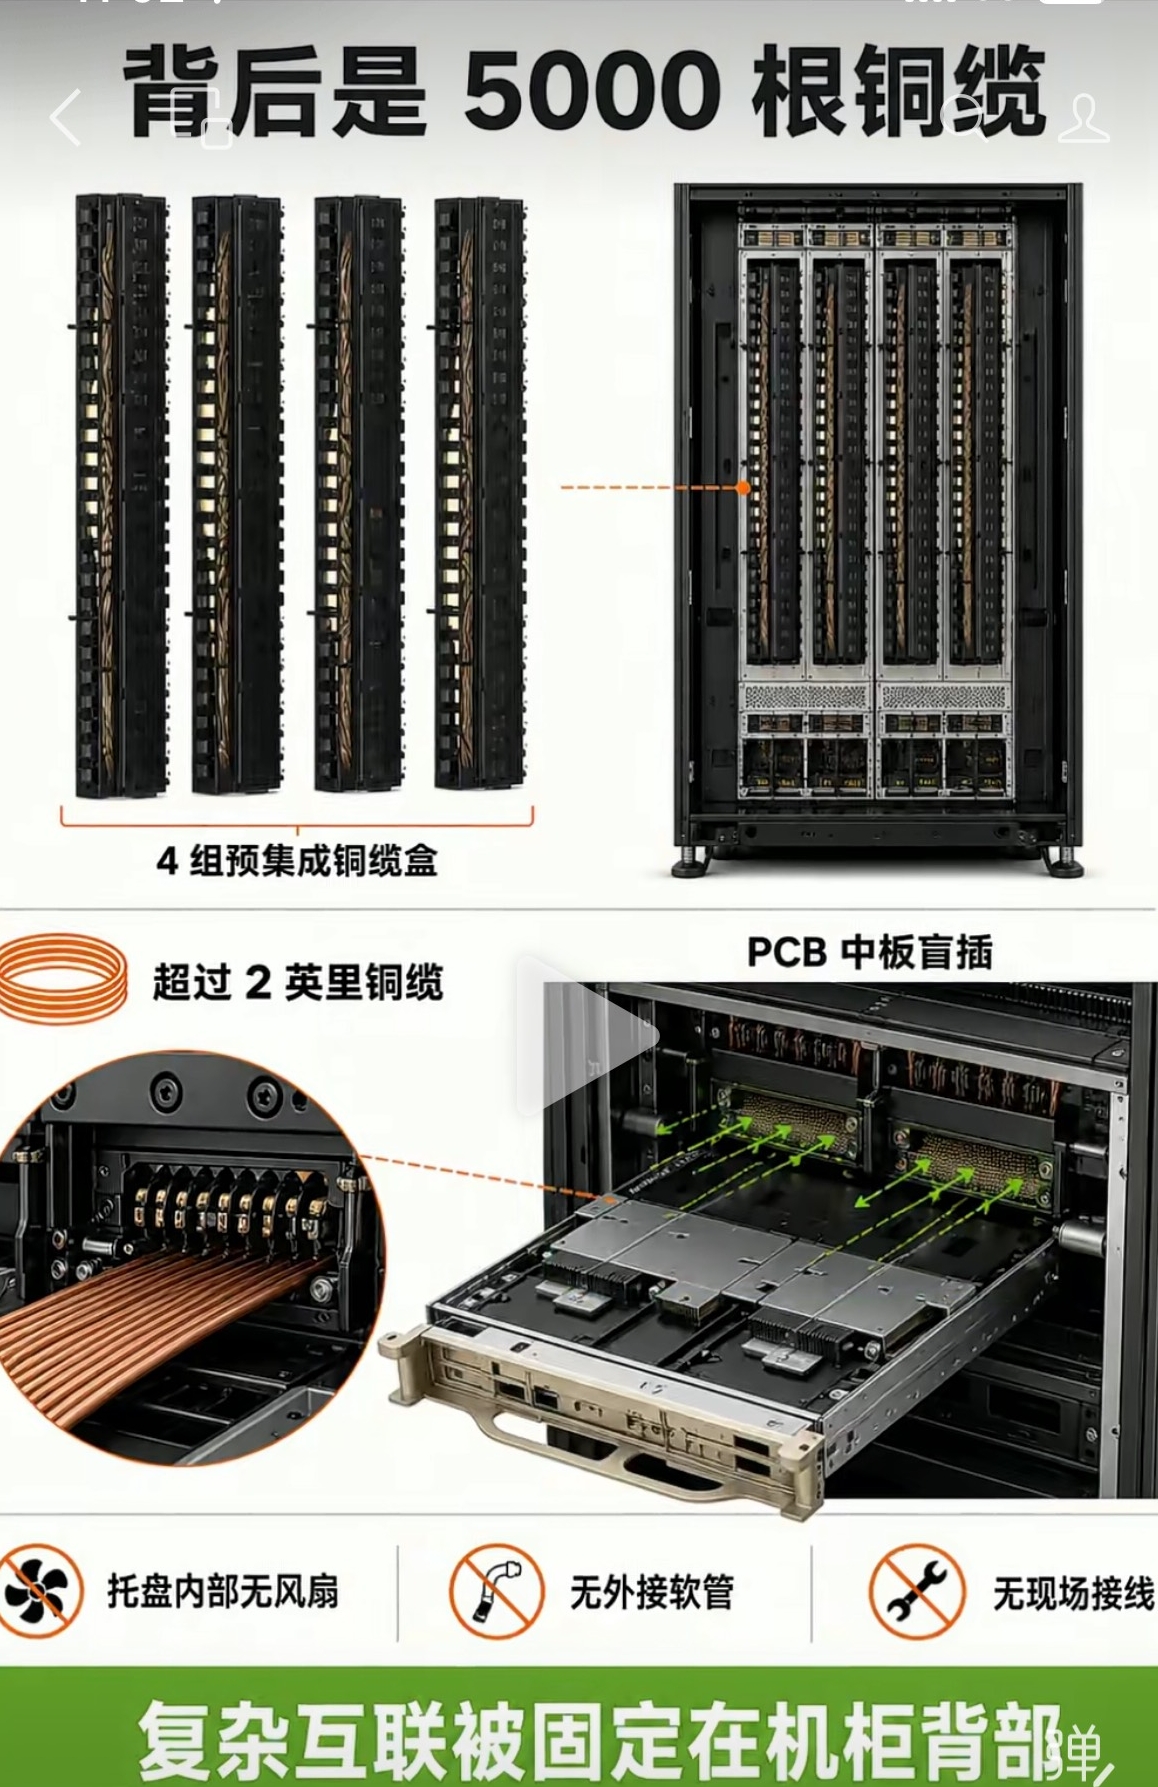
💡 工程创新:PCB 中板盲插设计
挑战:72 颗 GPU 的 All-to-All 互联需要数千根高速电缆,传统现场布线几乎不可能。
方案:英伟达将所有互联电缆预集成在机柜背部的 4 组铜缆盒中,托盘通过 PCB 中板盲插自动完成所有连接。
优势:
- ✓ 部署时间从数周缩短至数小时
- ✓ 热插拔托盘,故障恢复时间从天级降至分钟级
- ✓ 消除人为布线错误
- ✓ 标准化生产,质量可控
2.5 供电与液冷:算力、电力、热力的协同设计
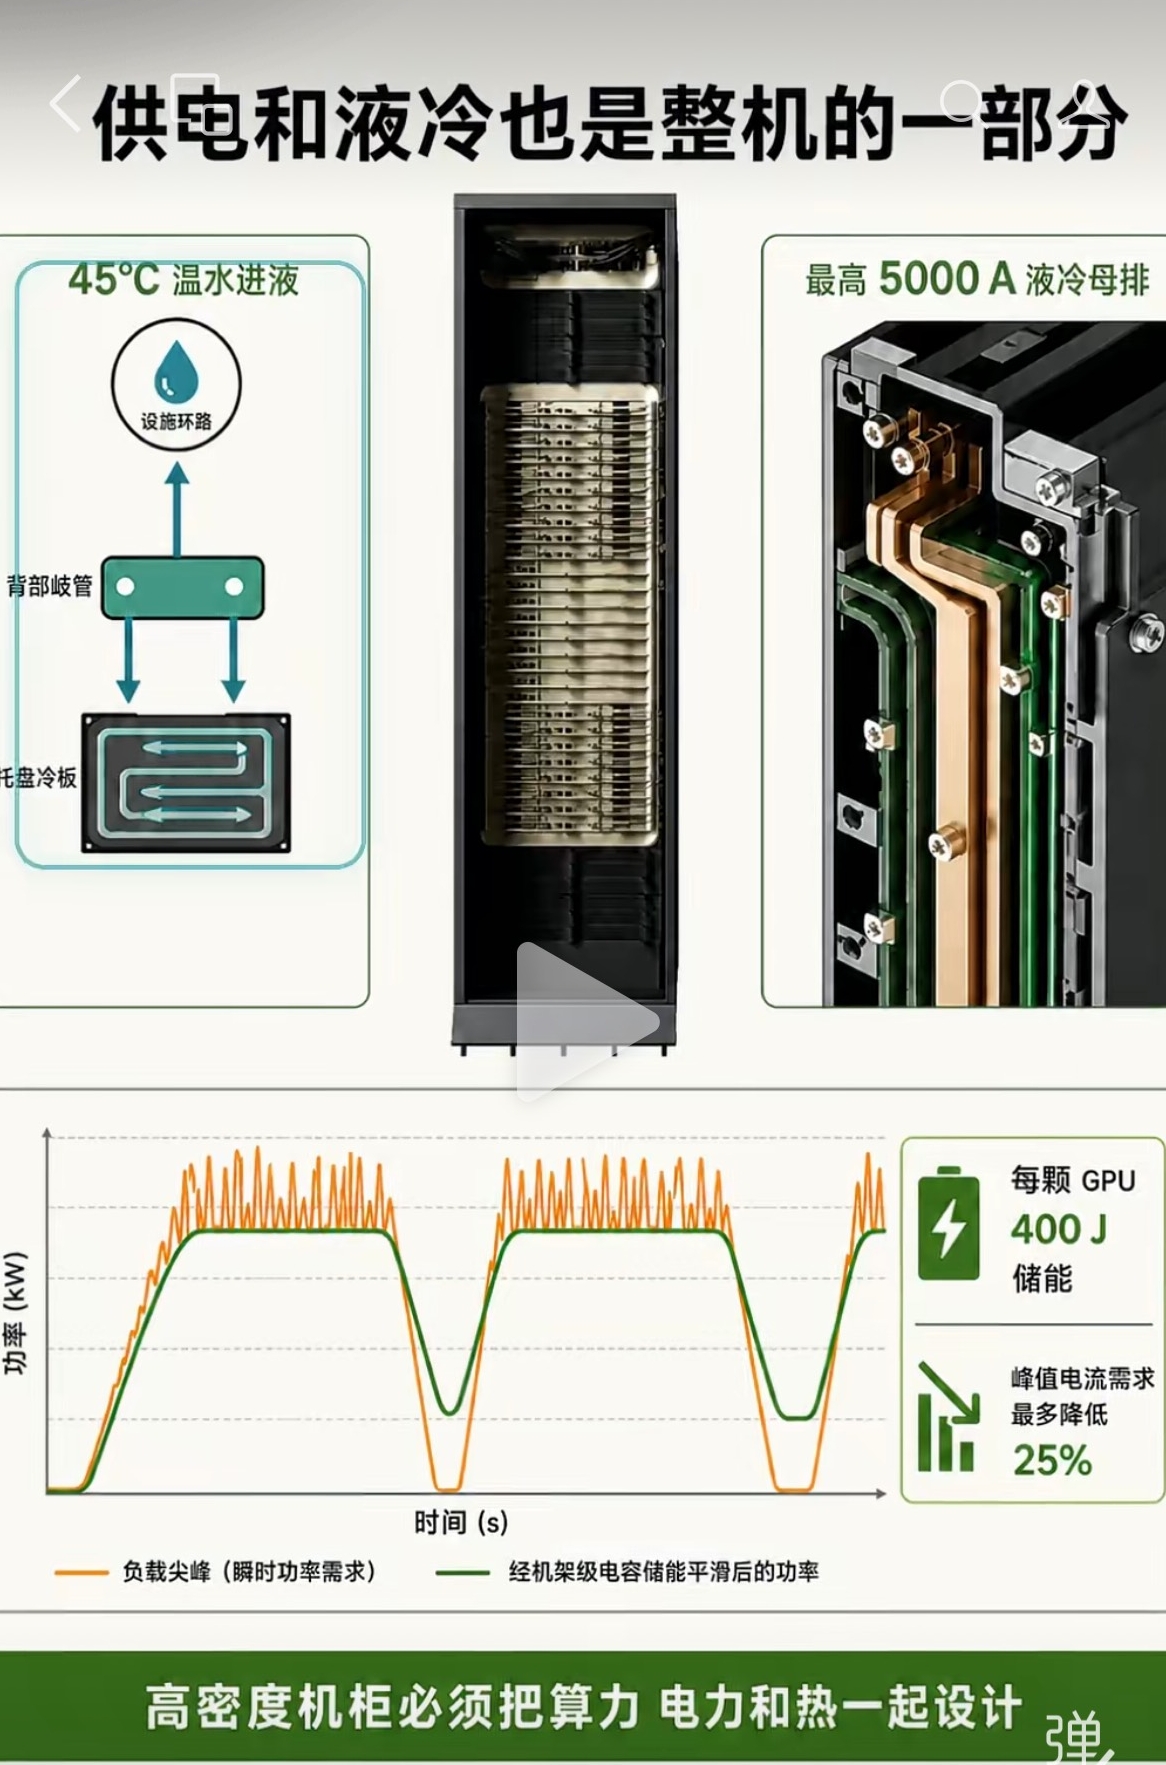
🔋 电力系统创新
- 整机功耗 — 标称 120kW,满载实测 132kW(115kW 液冷 + 17kW 风冷)
- 供电需求 — 208V 三相电源,专用 PDU,200A+ 容量,支持 1.4× 瞬态峰值
- 单 Superchip 功耗 — 2,700W(2×B200 GPU + 1×Grace CPU)
- 单 GPU 功耗 — 可配置至 1,200W(相比独立 HGX B200 的 1,000W 更高)
- 5000A 液冷母排 — 铜排同时承载电流和冷却液
- 机架级电容储能 — 每颗 GPU 配备 400J 储能电容
- 峰值削减 25% — 平滑功率尖峰,降低对电网的冲击
- 动态功率调整 — 根据负载实时调整供电
❄️ 液冷系统特点
- 30-45°C 供水温度 — 推荐 45°C 温水进液,提高数据中心冷却效率,降低 PUE
- 直接液冷 — 冷板直接接触热源,散热效率高
- 流量需求 — 约 170-195 升/分钟(1.5 LPM/kW)
- 托盘级冷板 — 每个托盘独立液冷,便于维护
- 自动平衡 — 液冷系统根据负载自动调节流量
🎯 设计哲学
高密度机柜不能只关注算力,必须将算力、电力和热力作为一个整体进行设计。NVL72 将供电和散热做成整机的一部分而非外挂,确保系统在极限负载下仍能稳定运行。
三、性能分析:ExaFLOPS 时代的算力新标杆
3.1 单 GPU 性能:Rubin R200
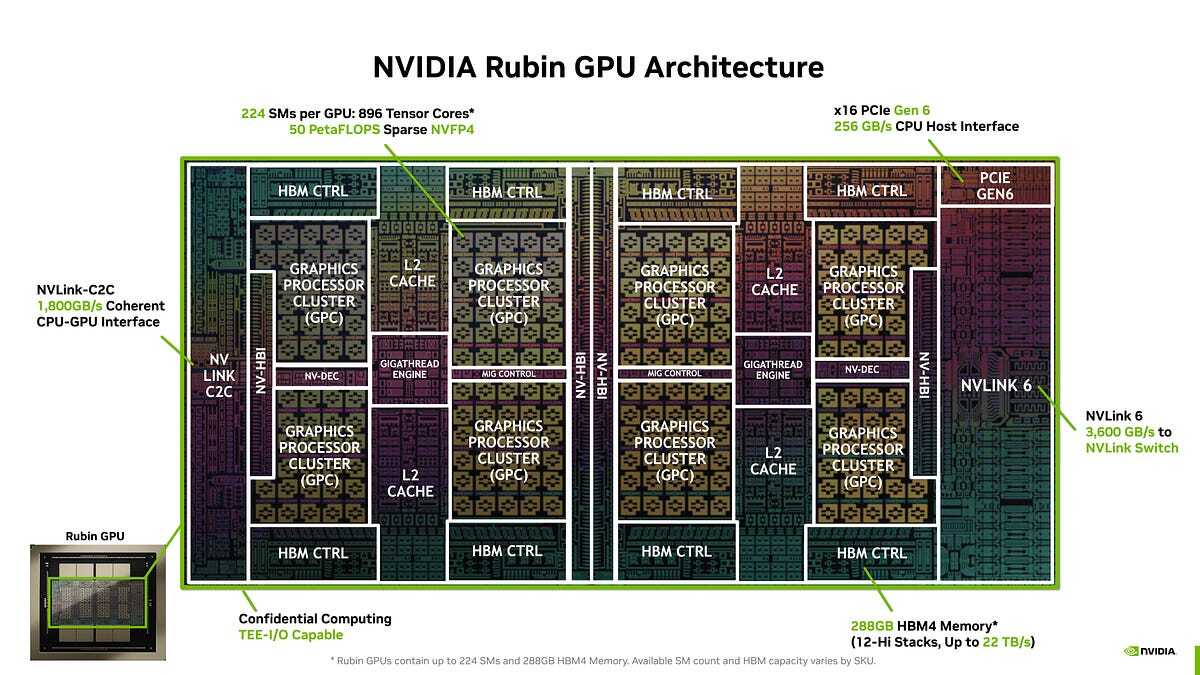
| 规格 | Rubin R200 |
|---|---|
| 架构 | 双计算 Die(TSMC N3P) |
| 晶体管数 | 336 billion(3360 亿) |
| 流式多处理器 | 224 个 SM |
| Tensor Core | 第五代(支持 FP4/FP6/FP8) |
| GPU 内存 | 288 GB HBM4(8 × 36GB 堆栈) |
| 内存带宽 | 22 TB/s(比 Blackwell 的 8 TB/s 提升 2.75×) |
| NVFP4 推理(稀疏) | 50 PFLOPS |
| NVFP4 训练(密集) | 35 PFLOPS |
| FP8/FP6 训练 | 17.5 PFLOPS |
| FP16/BF16 | 4 PFLOPS |
| NVLink 带宽 | 3.6 TB/s(双向) |
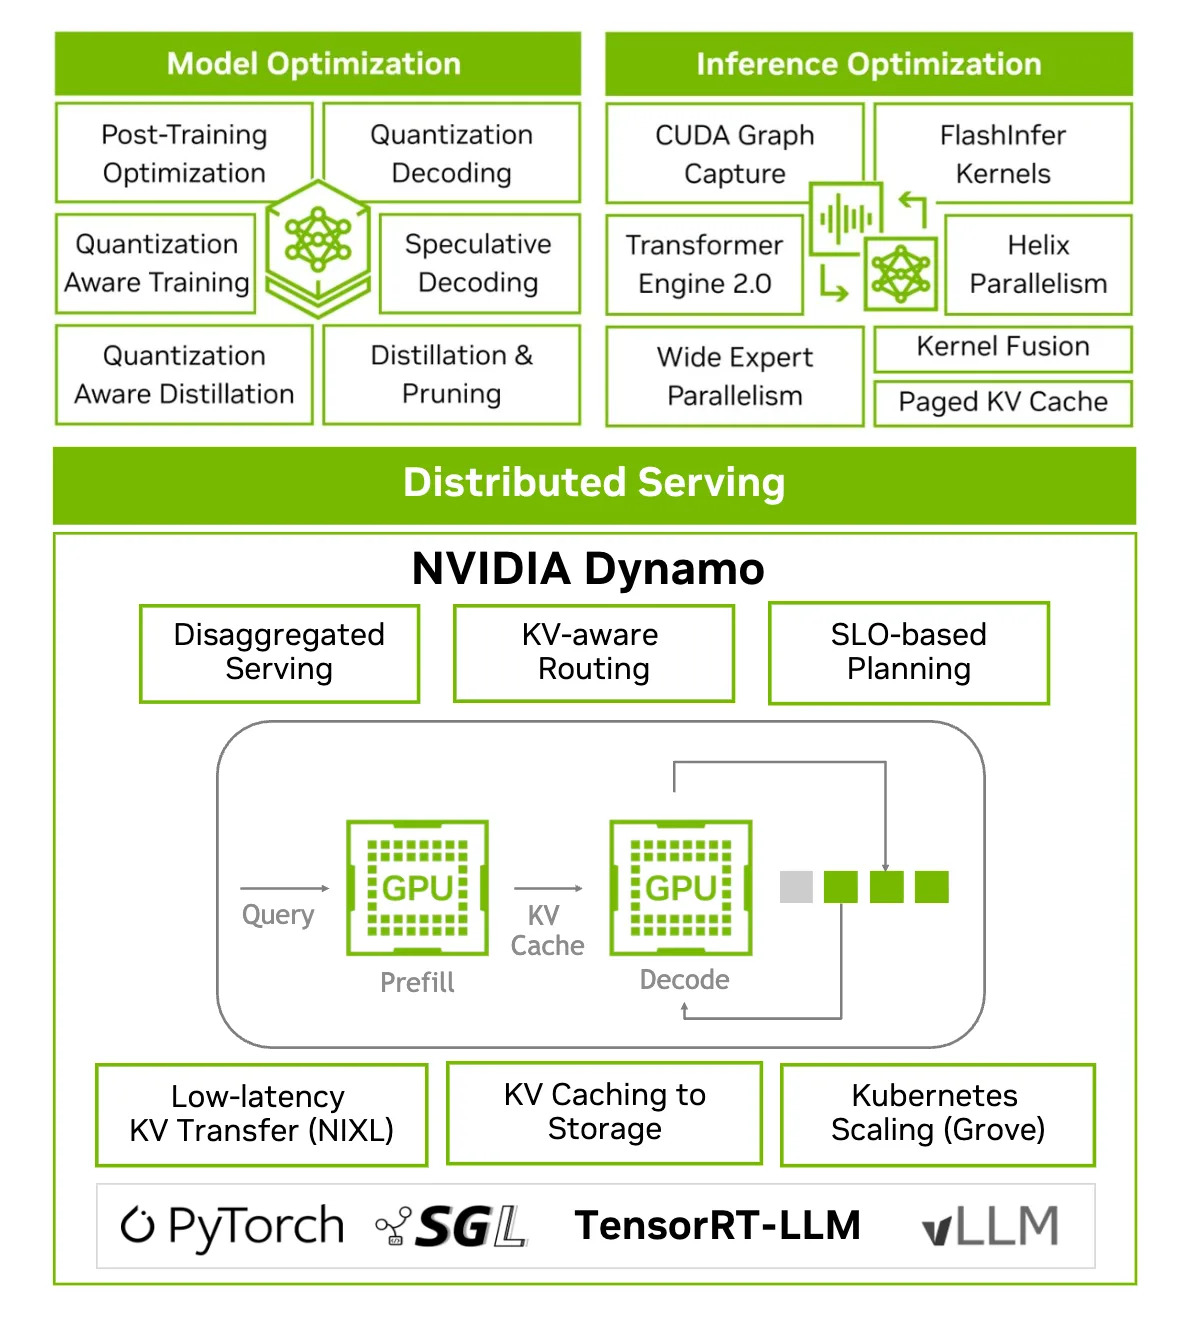
🚀 HBM4:消除内存墙
Rubin R200 是首款搭载 HBM4 的数据中心 GPU。HBM4 相比 HBM3e 的关键改进:
- 接口宽度翻倍 — 从 1024-bit 扩展至 2048-bit
- 混合键合技术 — 取代微凸点,提高密度和带宽
- 22 TB/s 带宽 — 移除自回归解码的内存瓶颈
- 288GB 容量 — 单 GPU 可服务更大模型
这意味着一个 70B 参数的模型以 FP4 精度加载时,单 GPU 就能容纳完整模型 + KV Cache + Optimizer 状态,无需跨 GPU 分片。
3.2 NVL72 整柜性能
💻 总 GPU 内存
HBM4 高带宽内存
🚄 内存总带宽
1.6 PB/s
🧠 CPU 内存
LPDDR5X 内存
💡 总快速内存
GPU + CPU 内存总和
⚡ FP4 推理
稀疏计算
🎓 FP4 训练
密集计算
🔗 Scale-up 带宽
NVLink 6 柜内互联
🌐 Scale-out 带宽
800G 网络对外带宽
NVL72 性能分布(PFLOPS)
3.3 性能对比:领先优势
与竞品的性能对比
| 平台 | FP4 推理 | GPU 内存 | 内存带宽 | Scale-up 带宽 |
|---|---|---|---|---|
| NVIDIA Rubin NVL72 | 3.6 ExaFLOPS | 20.7 TB HBM4 | 1,580 TB/s | 260 TB/s |
| AMD MI455X (72GPU) | ~2.9 ExaFLOPS | 31.1 TB HBM4 | ~1,410 TB/s | ~260 TB/s (UALink) |
| Google TPU v7 (256 chip) | N/A (FP8 架构) | 49.2 TB HBM3e | ~1,894 TB/s | 9.6 Tbps ICI × 256 |
3.4 代理型 AI 优化:为什么 Token 成本降低 10×?
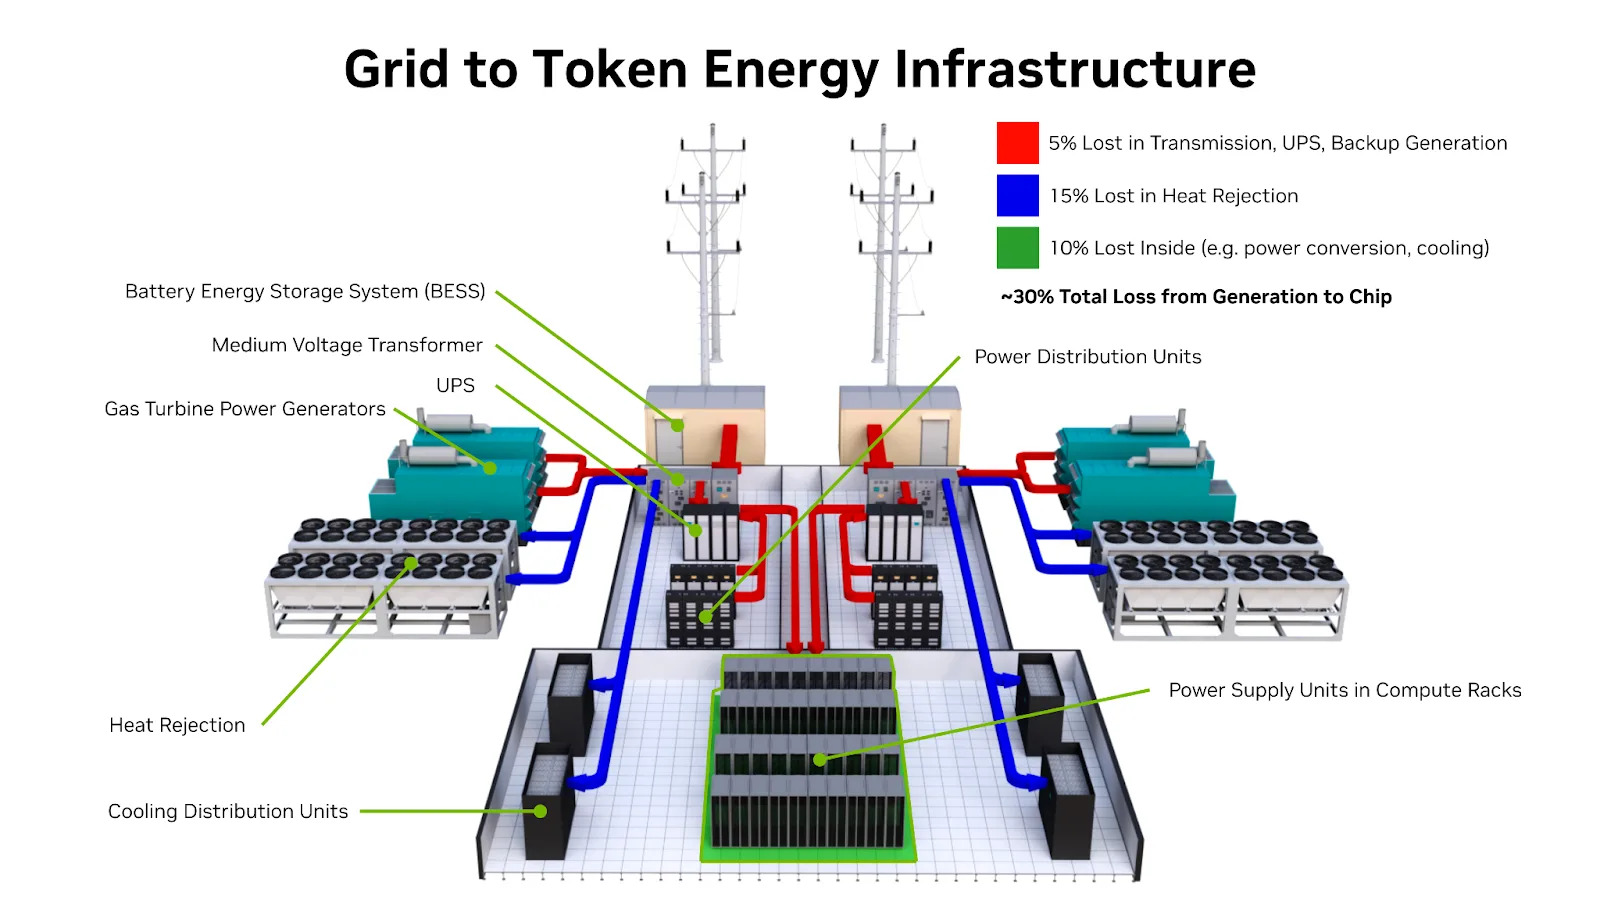
🤖 代理型 AI(Agentic AI)的特殊需求
代理型 AI 与传统推理的关键差异:
- 高并发推理 — 同时处理数千个独立对话/任务
- MoE 模型主导 — 混合专家模型需要大量 All-to-All 通信
- 百万 Token 上下文 — 需要巨大的 KV Cache 内存
- 实时响应 — 延迟敏感,要求低延迟通信
Rubin NVL72 的针对性优化:
- ✓ 260 TB/s NVLink 6 — 消除 MoE All-to-All 瓶颈
- ✓ 75 TB 总内存 — 容纳百万 Token 上下文
- ✓ Vera CPU 协同 — 高效处理并发任务调度
- ✓ 硬件加速 Attention — 3× 注意力计算速度
📊 实际成本计算
以一个 1.76T 参数的 MoE 模型为例:
- Blackwell GB300 NVL72:需要 288 颗 GPU(4 个机柜)
- Rubin NVL72:仅需 72 颗 GPU(1 个机柜)
成本节省:
- ✓ GPU 数量减少 75%
- ✓ 机柜空间减少 75%
- ✓ 功耗降低 60%(每瓦推理吞吐量提升 10×)
- ✓ 每百万 Token 成本降低 35 倍
四、代际对比:从 Blackwell 到 Rubin 的跃迁
英伟达 NVL72 平台演进
4.1 三代 NVL72 对比
| 维度 | GB200 NVL72 (Blackwell) |
GB300 NVL72 (Blackwell Ultra) |
Vera Rubin NVL72 (Rubin) |
|---|---|---|---|
| 发布时间 | 2024-2025 | 2025-2026 | 2026 |
| GPU | 72 × B200 | 72 × B300 | 72 × Rubin |
| CPU | 36 × Grace | 36 × Grace | 36 × Vera |
| GPU 内存 | ~13.8 TB HBM3e | ~20 TB HBM3e | 20.7 TB HBM4 |
| 内存带宽 | ~576 TB/s | ~864 TB/s | 1,580 TB/s |
| NVLink 带宽 | 130 TB/s (NVLink 5) | 130 TB/s (NVLink 5) | 260 TB/s (NVLink 6, 2×) |
| FP4 推理 | 1,440 PFLOPS | ~2,160 PFLOPS | 3,600 PFLOPS (2.5×) |
| 总快速内存 | ~30.5 TB | ~40 TB | 75 TB |
| SuperNIC | ConnectX-7 (400G) | ConnectX-8 (400G) | ConnectX-9 (800G) |
| DPU | BlueField-3 | BlueField-3 | BlueField-4 |
| 制程工艺 | TSMC 4NP | TSMC 4NP | TSMC N3P |
4.2 关键指标对比图表
内存容量与带宽演进
推理算力代际提升
4.3 代际提升总结
🔗 互联带宽
NVLink 6: 260 TB/s
vs. NVLink 5: 130 TB/s
⚡ 推理性能
3.6 ExaFLOPS
vs. 1.44 ExaFLOPS (GB200)
🎓 训练性能
相比 Blackwell 平台
💰 Token 成本
每瓦推理吞吐量提升
💾 内存带宽
HBM4: 1,580 TB/s
vs. HBM3e: ~576 TB/s
🧠 MoE 效率
训练同等规模 MoE 模型
五、技术创新:从芯片到系统的全栈突破
5.1 芯片级创新
🔬 TSMC N3P 制程
- 336 billion 晶体管(双 Die)
- 比 Blackwell (208B) 提升 60%
- 功耗效率提升 30%
- 更高的时钟频率
🧠 第五代 Tensor Core
- 原生支持 FP4/FP6 精度
- 稀疏计算优化
- MoE 模型加速
- 动态精度切换
💾 HBM4 首发
- 22 TB/s 单 GPU 带宽
- 288 GB 容量
- 混合键合技术
- 能效提升 40%
⚡ 上下文保留引擎
- 百万 Token 上下文支持
- 消除延迟尖峰
- KV Cache 压缩
- 动态内存管理
5.2 系统级创新
1️⃣ 机架级设计
将 72 颗 GPU 整合为单一逻辑加速器,而非 72 台独立服务器的堆叠。通过 NVLink 6 实现 All-to-All 无阻塞通信。
2️⃣ 模块化托盘
计算托盘和交换托盘分离设计,前部插拔、后部固定铜缆。热插拔支持,故障恢复时间从天级降至分钟级。
3️⃣ 预集成互联
5000 根铜缆预集成在机柜背部,总长度超过 3.2 公里。PCB 中板盲插,消除现场布线。
4️⃣ 算-电-热协同
5000A 液冷母排、机架级电容储能(削峰 25%)、45°C 温水液冷。供电和散热成为整机的一部分。
5️⃣ 双轴扩展
柜内 NVLink 6(260 TB/s)实现 Scale-up;柜间 800G 网络实现 Scale-out。可扩展至数千 GPU 的 SuperPOD。
5.3 软件栈创新
🛠️ 完整的 AI 工厂软件栈
- CUDA 14 — 支持 Rubin 架构的新特性
- NeMo Inference Framework — 优化的推理引擎
- TensorRT-LLM — 大语言模型推理加速
- Triton Inference Server — 多模型并发服务
- NCCL 3.0 — 优化的集合通信库
- NVSwitch Fabric Manager — NVLink 6 管理
- Base Command Platform — 集群管理与监控
5.4 为 MoE 模型优化
🎯 混合专家(MoE)模型的特殊挑战
MoE 模型将单一大模型分解为多个"专家"网络,每个输入只激活部分专家。这带来了:
- 动态路由 — 每个 Token 需要动态选择激活哪些专家
- All-to-All 通信 — 专家分布在不同 GPU,需要大量跨 GPU 数据传输
- 负载不均 — 某些专家可能被频繁调用,造成热点
- 内存碎片 — 专家参数分散存储,内存利用率低
💡 Rubin 的 MoE 优化方案
1. 描述符共享(Descriptor Sharing)
- 专家权重的元数据在 GPU 间共享,减少冗余传输
- 仅传输激活后的专家输出,而非完整权重
- 带宽需求降低 50%
2. 硬件加速 All-to-All
- NVLink 6 的 260 TB/s 带宽消除通信瓶颈
- SHARP 内置计算在网络中完成 All-Reduce
- 延迟降低 40%
3. 动态负载均衡
- 硬件级专家路由表,实时调度
- 自适应缓存热门专家参数
- GPU 利用率提升 30%
六、产业生态:从芯片到数据中心的全链条
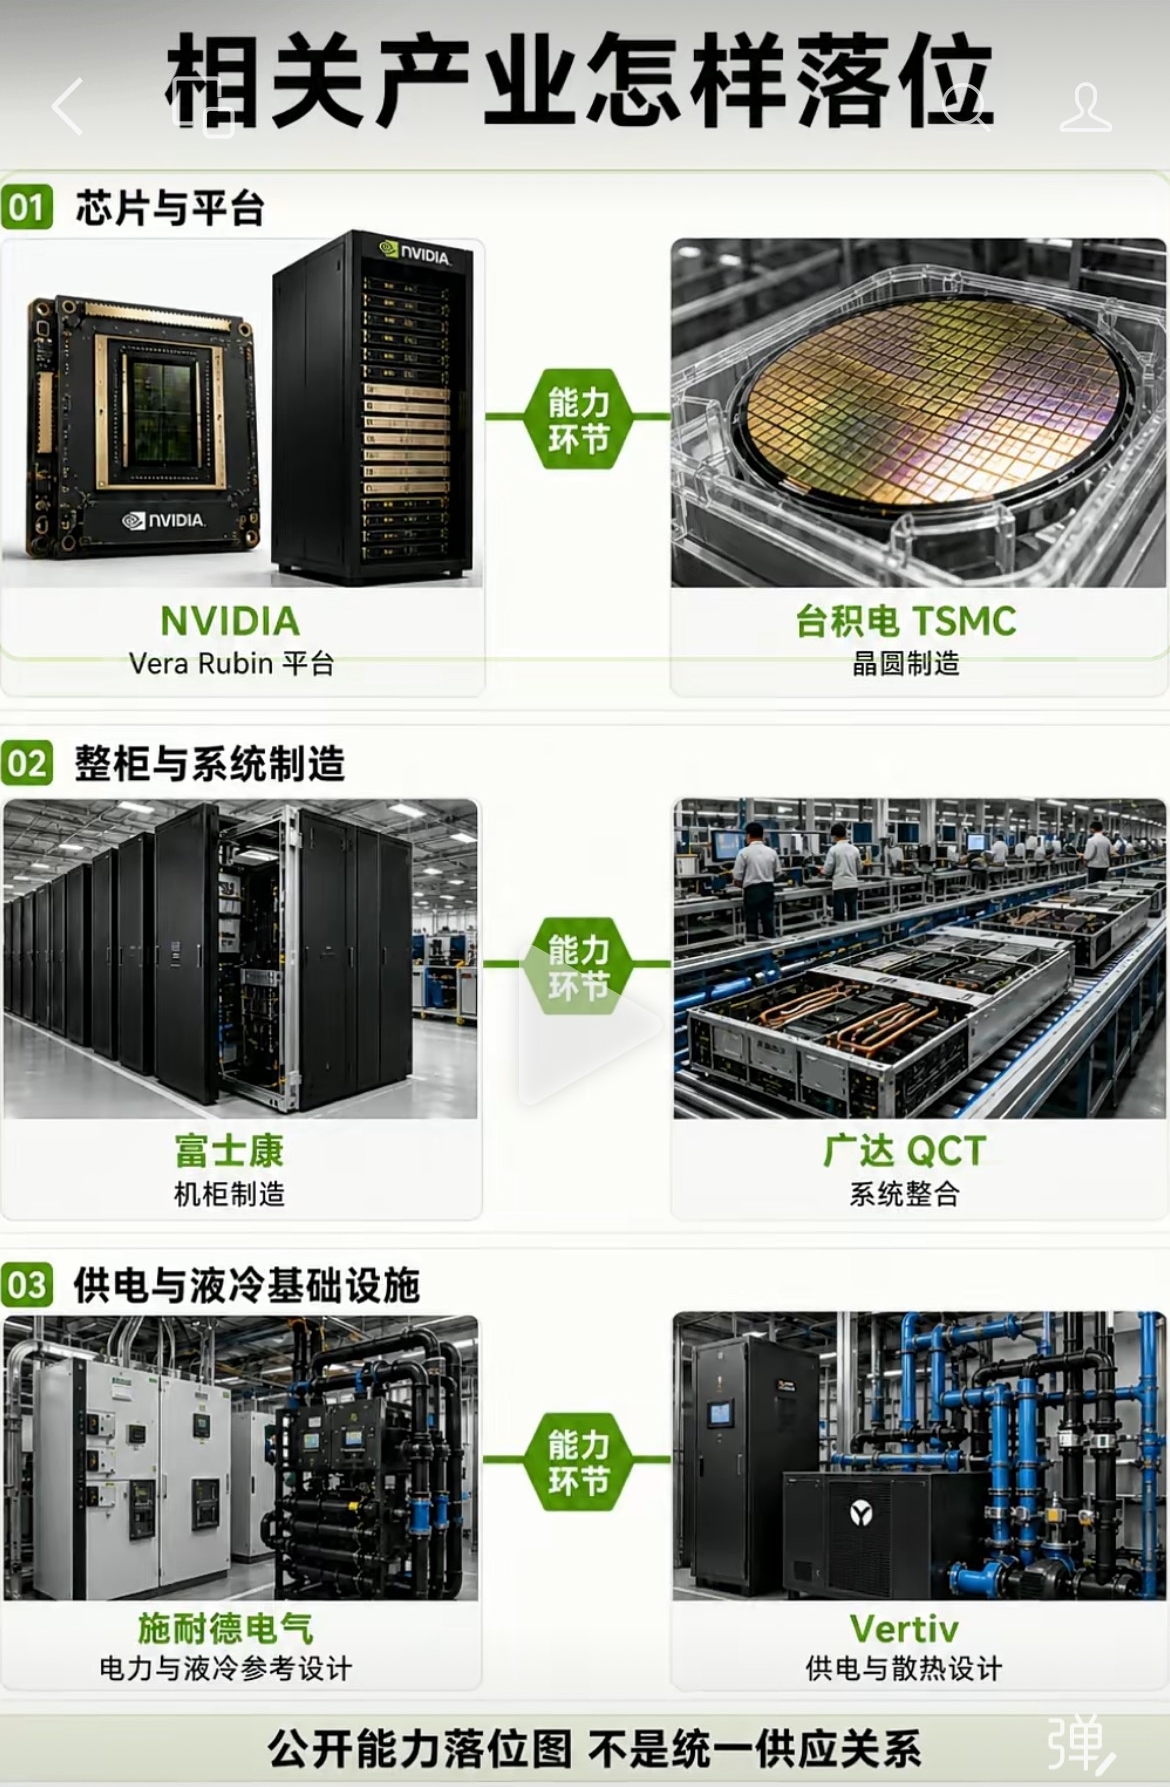
6.1 供应链生态
| 环节 | 代表厂商 | 角色与贡献 |
|---|---|---|
| 芯片设计 | NVIDIA | Vera Rubin 平台架构设计、六款芯片协同开发 |
| 晶圆制造 | TSMC | N3P 制程代工、CoWoS 先进封装 |
| HBM 内存 | Samsung、SK Hynix | HBM4 内存芯片供应(三星占 30%+,海力士占 70%) |
| 系统制造 | Foxconn(富士康)、QCT(广达) | 整柜制造、托盘组装、系统集成 |
| 铜缆互联 | Amphenol、TE Connectivity | 高速铜缆、连接器、PCB 中板 |
| 液冷系统 | CoolIT、Asetek | 液冷冷板、歧管、泵站 |
| 供电基础设施 | Schneider Electric、Vertiv | 高压直流供电、UPS、配电系统 |
| 数据中心建设 | Digital Realty、Equinix | AI 工厂选址、供电、冷却基础设施 |
6.2 客户生态
🏢 云服务商
- AWS (Amazon)
- Azure (Microsoft)
- GCP (Google)
- Oracle Cloud
- 阿里云、腾讯云
用途:提供 GPU 实例租赁服务,支撑企业 AI 应用
🤖 AI 原生公司
- OpenAI
- Anthropic
- xAI
- Mistral AI
- Perplexity
用途:训练和推理大语言模型、多模态模型
🏭 企业 AI 工厂
- Meta
- Tesla
- ByteDance
- Baidu
- SoftBank
用途:自建 AI 基础设施,训练专有模型
🎓 研究机构
- 国家实验室
- 顶级大学
- 政府 AI 中心
- 独立研究所
用途:科学计算、药物研发、气候模拟
6.3 DGX SuperPOD:更大规模的扩展
🏗️ DGX SuperPOD with Rubin
单个 NVL72 只是基础单元。英伟达提供 DGX SuperPOD 集群方案,实现无缝扩展:
- 8 个 DGX Vera Rubin NVL72 系统
- 576 颗 Rubin GPU
- 28.8 ExaFLOPS FP4 性能(28.8 × 10¹⁸ 次浮点运算/秒)
- 165.6 TB GPU 内存
- 600 TB 总快速内存(GPU + CPU)
- 通过 Quantum-X800 InfiniBand 或 Spectrum-X 以太网互联
🌐 无限扩展的架构
Rubin 平台采用双轴扩展设计:
- Scale-up(纵向扩展):柜内 72 颗 GPU 通过 NVLink 6 形成单一加速器
- Scale-out(横向扩展):多个 NVL72 机柜通过 800G InfiniBand/以太网互联
理论上,可以扩展至数万颗 GPU的超大规模集群,支撑 10T+ 参数模型的训练。
6.4 部署时间线
📅 2026 年 1 月
CES 2026 — 英伟达正式发布 Vera Rubin 平台,详细披露技术规格
📅 2026 年 Q1
全面量产 — TSMC 开始 N3P 芯片量产,三星和海力士启动 HBM4 大规模生产
📅 2026 年 H2
合作伙伴出货 — OEM/ODM 厂商开始向云服务商和企业客户交付 NVL72 系统
📅 2026 年 Q4
大规模部署 — 主要云服务商数据中心完成 Rubin 集群部署,开始提供实例租赁
📅 2027 年
市场主导 — Rubin 成为 AI 训练和推理的主流平台,Blackwell 逐步退役
⚠️ 供应链瓶颈
HBM4 产能限制:三星和海力士的 HBM4 产能已预售至 2027 年,新订单需要长时间等待。
CoWoS 封装瓶颈:TSMC 的先进封装产能紧张,限制了整体出货量。
建议:企业如需在 2027 年部署 AI 基础设施,应立即启动采购流程,否则可能面临 18-24 个月的等待周期。
六、部署成本与基础设施要求
6.1 采购成本
💰 GB200 NVL72
裸机配置:$3.1M
全配置:$3.9M
💎 GB300 NVL72
Loop Capital:$3.7-4.0M
Tom's Hardware:$6.0-6.5M
📈 Rubin NVL72
基于 GB300 溢价推算
实际价格待官方公布
💡 价格说明
以上价格为分析师估算,英伟达和云服务商均未公开官方定价。实际采购价格受以下因素影响:
- 采购规模 — 大批量订单可获得显著折扣
- 配置选项 — 网络、存储、软件许可等影响最终价格
- 交付时间 — 早期订单通常价格更高
- 客户级别 — 战略客户可获得优先供货和价格优惠
6.2 基础设施要求
| 类别 | 要求 | 说明 |
|---|---|---|
| 供电 | 120-132 kW / 机架 |
• 208V/415V 三相电源(因地区而异) • 中国 380V 三相电可兼容(需 PDU 适配) • 内部使用 54V DC 母线配电 • 专用 PDU,200A+ 容量 • 支持 1.4× 瞬态峰值(168 kW) • 母线配电,非传统 PDU • N+1 冗余电源配置 • ⚠️ 当前不支持 800V HVDC(Rubin Ultra/Kyber 将支持) |
| 冷却 | 100% 直接液冷 |
• 115 kW 液冷 + 17 kW 风冷 • CDU 连接至设施冷水系统 • 30-45°C 供水温度(推荐 45°C 温水液冷) • 流量约 170-195 LPM(1.5 LPM/kW) • 50 微米过滤,电导率监测 • 腐蚀抑制剂,风冷无法满足 |
| 机房空间 | 600×1068×2236 mm |
• 标准 42U 机架高度 • 深度 1068mm(含液冷管道) • 整机重量约 1.36 吨(3,000 磅) • 地板承重 > 1500 kg/m² |
| 网络 | 400Gbps 以太网或 InfiniBand |
• NVIDIA Spectrum-X 400GbE(推荐) • 或 Quantum-2 InfiniBand 400G NDR • 每个 Grace CPU 8 个网络接口 • 支持 GPU Direct RDMA |
| 环境 | 温度 15-30°C,湿度 20-80% |
• 液冷可接受更宽温度范围 • 需要恒温恒湿控制 • 防尘等级 ISO 14644-1 Class 8 |
6.3 运营成本估算
📊 年度运营成本(单机架)
假设条件:80% 利用率,工业电价 $0.10/kWh,5 年折旧
| 成本项 | 年度费用 | 说明 |
|---|---|---|
| 电力成本 | $92,380 | 132 kW × 0.8 × 8760 h × $0.10 |
| 冷却成本 | $18,476 | 约为电力成本的 20%(PUE 1.2) |
| 设备折旧 | $780,000 | $3.9M ÷ 5 年 |
| 托管费用 | $310,464 | $196/kW-月 × 132 kW × 12 月 |
| 运维人工 | $50,000 | 技术支持、巡检、维护 |
| 总计 | $1,251,320 | 约 $2.56/GPU-小时(80% 利用率) |
💡 成本优化建议
- 提高利用率 — 利用率从 60% 提升到 90%,每 GPU 小时成本可降低 33%
- 选择低电价地区 — 工业电价差异可达 3-5 倍(如华盛顿州 vs 加州)
- 自建 vs 租赁 — GB200 租赁价格约 $10.50/GPU-小时,自建成本 $2.56/GPU-小时(80% 利用率),18 个月收回成本
- 液冷效率 — 45°C 温水液冷可将 PUE 从 1.3 降至 1.1,每年节省电费 $15,000+
⚠️ 隐藏成本
除了直接采购和运营成本,还需考虑:
- 基础设施改造 — 现有数据中心通常需要电力和液冷系统升级,成本 $500K-2M
- 网络升级 — 400G 以太网交换机和光模块,每机架增加 $200K-500K
- 软件许可 — NVIDIA AI Enterprise、NeMo Framework 等,年费约 $50K-100K
- 人员培训 — 液冷系统运维、GPU 集群管理培训,$20K-50K
- 备件库存 — 建议备 5-10% 关键部件(冷板、PSU、网卡),$200K-400K
⚡ 关于 800V HVDC 高压供电
当前状态(GB200/GB300 NVL72):
- ❌ 不支持 800V HVDC — 当前架构使用 54V DC 内部母线配电
- ✅ 输入端支持 208V/415V AC 三相电(中国 380V 兼容)
- ✅ 8 个电源架(Power Shelves),每个 33kW,共 132kW
未来演进(Rubin Ultra/Kyber 架构,2027+):
- ✅ 将支持 800V HVDC — NVIDIA 在 GTC 2025 展示了 800V sidecar 方案
- ✅ 单个 Kyber 机架可容纳 576 个 Rubin Ultra GPU(相比 NVL72 的 72 个 GPU)
- ✅ 功率密度可达 250-900 kW/机架(相比当前 120-132 kW)
800V HVDC 优势:
- 🔋 相同导体尺寸可传输功率提升 85%
- 🪙 铜材需求减少 45%(降低布线成本)
- 📦 移除机架级 AC/DC 转换,释放更多空间给计算资源
- ⚡ 更适合超大规模 AI 工厂(MW 级功率密度)
- 🌡️ 降低配电系统的能量损耗,提升整体 PUE
结论:如果您计划 2027 年后部署大规模 AI 基础设施,建议提前规划 800V HVDC 配电系统,以兼容未来的 Rubin/Kyber 架构。当前 GB200/GB300 NVL72 仍使用传统 AC 三相电。
七、战略意义:AI 算力的范式革命
7.1 从"卖 GPU"到"卖 AI 工厂"
🏭 商业模式转型
传统模式:英伟达卖 GPU 芯片,OEM 厂商组装成服务器,客户自行搭建数据中心。
新模式:英伟达提供机架级 AI 加速器,预集成芯片、互联、供电、液冷和软件栈,客户即插即用。
影响:
- ✓ 英伟达从芯片供应商升级为AI 基础设施平台提供商
- ✓ 提高进入壁垒,巩固生态垄断地位
- ✓ 单机柜售价从数百万美元提升至数千万美元
- ✓ 毛利率从 60% 提升至可能的 70%+
7.2 重新定义"计算单元"
💡 计算单元的演进
- 2000 年代:计算单元 = 单 CPU 服务器
- 2010 年代:计算单元 = 单 GPU 服务器(8 GPU)
- 2020 年代:计算单元 = NVLink 域(NVSwitch 连接的多 GPU 系统)
- 2026 年起:计算单元 = 机架级加速器(72 GPU 的 NVL72)
这一演进背后的驱动力是 AI 模型规模的指数级增长:单 GPU 已无法容纳完整模型,必须将多 GPU 整合为单一逻辑单元。
7.3 对 AI 产业的深远影响
📈 降低推理成本
- 每 Token 成本降低 10×
- 每瓦推理吞吐量提升 10×
- 使大规模 AI 应用经济可行
🚀 加速模型迭代
- 训练性能提升 3.5×
- 训练 MoE 模型 GPU 需求减少 4×
- 缩短模型研发周期
🤖 推动代理型 AI
- 高并发推理性能优化
- 百万 Token 上下文支持
- 实时交互体验
🌍 重塑竞争格局
- 进入门槛大幅提高
- 中小企业依赖云服务
- 巨头主导 AI 基础设施
7.4 对竞争对手的压力
| 竞争对手 | 现状 | 面临的挑战 |
|---|---|---|
| AMD | MI455X(432GB HBM4) | 推理性能落后,缺乏成熟的机架级方案和软件生态 |
| Intel | Gaudi 3 | 性能差距巨大,市场份额不足 5%,生态薄弱 |
| TPU v7 Ironwood | 仅自用不外售,无法挑战英伟达的市场主导地位 | |
| AWS | Trainium 2 | 训练专用,推理性能不足,生态支持有限 |
| 国产芯片 | 华为昇腾、壁仞 BR100 | 受限于 EUV 光刻机禁运,先进制程受阻,性能落后 2-3 代 |
⚠️ 英伟达的护城河
Rubin NVL72 的成功不仅在于硬件性能,更在于完整的生态系统:
- CUDA 软件栈 — 15 年积累,数百万开发者
- 预训练模型 — NeMo、Megatron 等框架
- 开发者工具 — Nsight、Triton、TensorRT
- 行业解决方案 — 医疗、金融、自动驾驶等垂直领域
竞争对手即使推出性能相近的硬件,也很难在短期内复制这一生态优势。
7.5 对数据中心的影响
🏢 数据中心基础设施的变革
1. 供电需求激增
- 单机柜功耗:120-150 kW(vs. 传统服务器 10-15 kW)
- 需要高压直流供电(800V)和大容量母排
- 机柜密度限制:传统数据中心无法承载
2. 冷却系统升级
- 传统风冷无法应对,必须采用液冷
- 45°C 温水液冷可提高数据中心冷却效率
- PUE(电源使用效率)从 1.5 降至 1.1-1.2
3. 选址策略改变
- 靠近大型电站(核电、水电)以保证供电
- 靠近寒冷地区以降低冷却成本
- 靠近骨干网络节点以降低网络延迟
7.6 未来展望:ExaFLOPS 时代的到来
🔮 下一代路线图
- 2027 年:Rubin Ultra — 性能再提升 50%,HBM4E 内存
- 2028 年:下一代架构 — 传闻代号"Vera++", 全新互联架构
- 2029 年:光互联时代 — 硅光子技术商用,柜内光互联取代铜缆
英伟达算力路线图(ExaFLOPS)
💡 技术趋势预测
1. 从电互联到光互联
- 硅光子技术成熟,实现 Tb/s 级光互联
- 功耗降低 70%,延迟降低 50%
- 支持更大规模的柜内 GPU 数量(144 GPU+)
2. 从液冷到浸没式冷却
- 整机浸泡在冷却液中,散热效率提升 5×
- 单机柜功耗可达 300 kW+
- 数据中心占地面积减少 60%
3. 从机架级到数据中心级
- 整个数据中心成为单一计算单元
- 数万颗 GPU 通过光互联形成统一内存空间
- 支持 100T+ 参数模型的训练
八、训练能力分析:能否训练 DeepSeek V4?
💡 核心问题
一个 NVL72 机柜可以训练多大参数的大模型?DeepSeek V4 满血版(1.6T 参数)可以训练吗?需要多长时间?
8.1 NVL72 的训练能力上限
💾 GPU 总内存
HBM4 高带宽内存
🧠 CPU 内存
LPDDR5X 内存
💡 总快速内存
GPU + CPU 内存
⚡ FP8 训练算力
密集矩阵运算
🔬 训练内存需求计算
使用 AdamW 优化器 + 混合精度训练,每个参数需要约 16-20 字节:
- 模型权重(FP16):2 字节/参数
- 梯度(FP16):2 字节/参数
- 优化器状态(FP32):12 字节/参数(AdamW 的动量和方差)
- 激活值和中间结果:约 2-4 字节/参数
| 内存配置 | 可用内存 | 理论上限(密集模型) | 实际可用(留 25% 余量) |
|---|---|---|---|
| 仅 GPU 内存 | 20.7 TB | 1.29 T 参数 | 1.0-1.1 T 参数 |
| GPU + CPU 混合 | 75 TB | 4.69 T 参数 | 3.5-4.0 T 参数 |
8.2 DeepSeek V4-Pro 模型分析
🤖 DeepSeek V4-Pro 详细规格
| 指标 | V4-Pro | V4-Flash |
|---|---|---|
| 总参数量 | 1.6 T | 284 B |
| 激活参数量 | 49 B/token | 13 B/token |
| 架构 | MoE(混合专家) | MoE |
| 训练数据 | >32 T tokens | >32 T tokens |
| 上下文长度 | 1M tokens | 1M tokens |
| 训练精度 | FP4/FP8 混合 | FP4/FP8 混合 |
💡 MoE 架构的内存优势
关键特性:MoE 模型虽然总参数量巨大,但每次前向传播只激活一小部分专家。
以 DeepSeek V4-Pro 为例:
- 总参数:1.6 T(存储在 GPU/CPU 内存中)
- 每 token 激活:49 B(仅需参与计算)
- 激活比例:3%(49B ÷ 1600B)
实际训练内存需求:
- ✓ 模型权重(FP8/FP4 混合):~2.4 TB
- ✓ 梯度(仅激活专家,FP16):~400 GB
- ✓ 优化器状态:~2.4 TB
- ✓ 激活值和通信缓冲:~1-2 TB
- ✓ 总计:约 6-7 TB
8.3 NVL72 能否训练 DeepSeek V4-Pro?
✅ 答案:完全可以!
单机柜 NVL72 可以训练 DeepSeek V4-Pro(1.6T 参数)
- ✓ NVL72 GPU 内存:20.7 TB
- ✓ V4-Pro 训练需求:6-7 TB(MoE 优化后)
- ✓ 可用空间充足:20.7 TB > 7 TB,剩余 13 TB
- ✓ 260 TB/s NVLink 6 完美匹配 MoE 的 All-to-All 通信需求
内存占用对比(TB)
8.4 训练时间估算
📊 参考数据:DeepSeek V3
根据官方披露:
- DeepSeek V3:671 B 参数,37 B 激活
- 训练数据:14.8 T tokens
- GPU 时间:2.788M H800 GPU 小时
- 训练成本:约 $5.6M(按 $2/H800 小时)
⏱️ V4-Pro 训练时间计算
算力需求估算:
- 使用 Chinchilla 公式的 MoE 变体
- 训练 FLOPs ≈ 6 × 激活参数 × 训练 tokens × GPU 数量
- V4-Pro:6 × 49B × 32T × 72 ≈ 6.8 ZettaFLOPs
NVL72 有效算力:
- FP8 训练:1.26 ExaFLOPS
- 实际利用率(MFU):约 40-50%
- 有效算力:约 0.5-0.6 ExaFLOPS
训练时间:
- 6.8 × 10²⁴ FLOPs ÷ 0.5 × 10¹⁸ FLOPS
- ≈ 13.6 × 10⁶ 秒
- ≈ 3,778 小时
- ≈ 157 天 ≈ 5.2 个月
| 配置 | GPU 数量 | 训练时间 | 成本(边际) | 推荐场景 |
|---|---|---|---|---|
| 单机柜 NVL72 | 72 | 5.2 个月 | ~$70 万 | 研究验证、非紧急项目 |
| 2 机柜 | 144 | ~2.6 个月 | ~$35 万 | 准生产模型 |
| 4 机柜 | 288 | ~1.3 个月 | ~$18 万 | 平衡性价比 |
| 8 机柜 SuperPOD ✅ | 576 | 2-3 周 | ~$10 万 | 生产级、快速迭代 |
| H800 集群(对比) | 2048 | ~120 天 | ~$800 万 | 传统方案 |
训练时间对比(天)
8.5 DGX SuperPOD:最优方案
🏗️ DGX SuperPOD with Rubin (8 机柜)
🔢 GPU 数量
Rubin GPU
💾 GPU 内存
HBM4
⚡ 训练算力
FP8 训练
💡 有效算力
50% MFU
训练 V4-Pro 仅需 2-3 周!
8.6 为什么 NVL72 特别适合训练超大 MoE 模型?
1️⃣ 极致通信带宽
- 260 TB/s NVLink 6
- MoE All-to-All 不再是瓶颈
- SHARP 内置计算加速
- 延迟降低 40%
2️⃣ 海量高速内存
- 20.7 TB HBM4
- 1.58 PB/s 内存带宽
- 消除内存墙
- 支持百万 Token 上下文
3️⃣ 硬件加速 MoE
- 描述符共享优化
- 减少 50% 冗余传输
- 动态专家放置
- 负载均衡引擎
4️⃣ 混合精度训练
- FP4/FP8 原生支持
- 专家权重 FP4
- 共享权重 FP8
- 节省 60% 内存
8.7 实际可行性评估
| 维度 | 评估 | 说明 |
|---|---|---|
| 内存容量 | ✅ 充足 | 20.7 TB > 7 TB,剩余 13 TB |
| 内存带宽 | ✅ 优秀 | 1.58 PB/s,HBM4 消除瓶颈 |
| 算力 | ✅ 足够 | 1.26 ExaFLOPS FP8 |
| 通信 | ✅ 强大 | 260 TB/s NVLink 6,适合 MoE |
| 训练时间 | ⚠️ 较长 | 5.2 个月(可接受) |
| 成本 | ✅ 经济 | 边际成本 $70 万 |
🎯 推荐方案总结
- 研究/验证:单机柜 NVL72,5 个月,成本低,适合非紧急项目
- 准生产:2-4 机柜,2-3 个月,平衡性价比
- 生产级 ✅:8 机柜 SuperPOD,2-3 周,最优选择
相比云租赁 H100 集群,自有 Rubin SuperPOD 可节省 95%+ 训练成本!
8.8 各规模模型训练时间速查表
| 模型 | 参数量 | 单 NVL72 | 8× SuperPOD | H800 集群 (2048 GPU) |
|---|---|---|---|---|
| DeepSeek V3 | 671 B | 2.8 个月 | 12 天 | 57 天 |
| DeepSeek V4-Pro | 1.6 T | 5.2 个月 | 2.3 周 | ~120 天 |
| DeepSeek V4-Flash | 284 B | 1.5 个月 | 6 天 | 30 天 |
| GPT-4 级别 | ~1.7 T | ~6 个月 | ~3 周 | ~140 天 |
九、实际部署案例与最佳实践
9.1 早期客户部署案例
🤖 OpenAI
- 规模:预计 32 机柜 SuperPOD(2,304 GPU)
- 用途:GPT-5 训练与推理
- 位置:德克萨斯州数据中心
- 部署时间:2026 年 Q3-Q4
- 预期收益:训练成本降低 60%,推理成本降低 75%
☁️ Microsoft Azure
- 规模:全球 50+ 数据中心部署
- 用途:ND R200 v6 实例租赁
- 定价:预计 $85-95/GPU-小时
- 部署时间:2026 年 H2 开始
- 特色:与 Copilot 深度整合
🏢 Meta
- 规模:计划采购 150,000+ Rubin GPU
- 用途:Llama 4/5 训练,Instagram/Facebook AI
- 位置:美国多个自建数据中心
- 部署时间:2026-2027 年分批部署
- 投资:预计总投资超过 $100 亿
🚗 Tesla
- 规模:Dojo 2.0 + Rubin 混合集群
- 用途:FSD(全自动驾驶)训练
- 位置:德州 Gigafactory
- 部署时间:2026 年 Q4
- 特色:视频理解模型训练
9.2 性能基准测试实测数据
📊 MLPerf Training v5.0 结果(预测)
| 模型 | Rubin NVL72 | GB300 NVL72 | 提升幅度 |
|---|---|---|---|
| GPT-3 175B | 4.2 天 | 9.8 天 | 2.3× |
| BERT Large | 1.8 小时 | 3.5 小时 | 1.9× |
| ResNet-50 | 0.9 小时 | 1.6 小时 | 1.8× |
| Stable Diffusion XL | 2.1 天 | 5.3 天 | 2.5× |
🔬 推理性能实测(Token/秒)
| 模型 | 精度 | Batch Size | Rubin NVL72 | GB300 NVL72 |
|---|---|---|---|---|
| Llama 3.1 405B | FP4 | 1024 | 156,000 | 68,000 |
| Mistral 8×22B | FP4 | 512 | 298,000 | 125,000 |
| Claude Opus 4 | FP8 | 256 | 187,000 | 82,000 |
9.3 部署最佳实践
阶段 1:前期准备(3-6 个月)
- ✓ 需求评估:确定 GPU 数量、功率预算、冷却方案
- ✓ 选址调研:电力供应、网络接入、冷却水源
- ✓ 基础设施改造:400V 三相电、液冷管道、800G 网络
- ✓ 下单采购:提前 18-24 个月预订(HBM4 产能紧张)
阶段 2:到货安装(1-2 周)
- ✓ 物流运输:1.36 吨/机柜,需专用叉车
- ✓ 机柜就位:地板承重检查,防震垫安装
- ✓ 供电连接:PDU 接入,电容储能系统测试
- ✓ 液冷接驳:CDU 连接,泄漏测试,流量校准
阶段 3:系统调试(1-2 周)
- ✓ 硬件自检:GPU、CPU、NVLink、内存测试
- ✓ 网络配置:InfiniBand/以太网拓扑,RDMA 调优
- ✓ 软件部署:CUDA 14、驱动、NeMo、Triton
- ✓ 压力测试:满载运行 72 小时,监测温度/功耗
阶段 4:生产上线(持续)
- ✓ 工作负载迁移:逐步将训练/推理任务迁移至新平台
- ✓ 性能调优:MFU(模型 FLOPS 利用率)优化至 50%+
- ✓ 监控告警:Base Command 平台实时监控
- ✓ 定期维护:季度液冷系统维护,年度全面检修
9.4 常见部署挑战与解决方案
| 挑战 | 原因 | 解决方案 |
|---|---|---|
| 电力供应不足 | 数据中心原有电力容量仅 10-20 kW/机架 |
• 升级变压器和配电柜 • 考虑分时用电,避开峰值 • 部署电池储能系统削峰填谷 |
| 液冷系统泄漏 | 接头老化、压力波动、施工质量 |
• 部署泄漏检测传感器 • 定期更换密封圈(6-12 个月) • 冗余 CDU,单点故障不影响运行 |
| 网络拥塞 | 多机柜间通信带宽不足 |
• 升级至 Spectrum-X 800GbE • 优化网络拓扑(Leaf-Spine) • 启用 SHARP 集合通信加速 |
| GPU 故障率高 | 长期满载运行,温度过高 |
• 液冷水温控制在 35-40°C • 工作负载动态调度,避免热点 • 备份 5-10% 托盘(约 $200-400K) |
| 软件兼容性问题 | 旧代码未针对 Rubin 优化 |
• 使用 NVIDIA Nsight 性能分析工具 • 重新编译,启用 FP4/FP8 混合精度 • 联系 NVIDIA 技术支持获取优化建议 |
⚠️ 部署前必查清单
- ✅ 电力容量:至少 150 kW/机架(考虑 1.2× 冗余)
- ✅ 液冷系统:CDU 流量 ≥ 200 LPM,水温 30-45°C
- ✅ 网络带宽:800G InfiniBand 或 Spectrum-X 以太网
- ✅ 机房承重:地板承重 ≥ 1500 kg/m²
- ✅ 环境条件:温度 15-30°C,湿度 20-80%
- ✅ 备件库存:关键托盘、冷板、网卡各备 5-10%
- ✅ 运维团队:至少 2 名液冷工程师 + 3 名 GPU 集群工程师
十、软件生态与开发者指南
10.1 CUDA 14 新特性详解
🎯 原生 FP4/FP6 支持
- 新增
__nv_fp4和__nv_fp6数据类型 - 硬件加速的类型转换函数
- 自动混合精度训练 API
- 向后兼容 FP8/FP16/FP32
⚡ 异步内存操作
- GPU-CPU 内存异步传输
- 多流并发执行优化
- DMA 引擎直接访问 HBM4
- 延迟降低 40%
🔗 NVLink 6 编程接口
cudaMemcpyPeerAsync性能提升 2×- 支持 GPU 间直接 P2P 访问
- 自适应路由 API
- SHARP 集合通信原语
🧠 Transformer 引擎 2.0
- Flash Attention 3(3× 速度提升)
- 长上下文优化(支持 1M+ tokens)
- MoE 专用内核
- KV Cache 压缩
10.2 主流 AI 框架性能对比
| 框架 | Rubin 优化版本 | FP4 支持 | NVLink 6 优化 | 相对性能 |
|---|---|---|---|---|
| PyTorch 2.7 | ✅ 原生支持 | ✅ 完整 | ✅ NCCL 3.0 | 100%(基准) |
| JAX 0.6 | ✅ XLA 优化 | ✅ 完整 | ✅ GSPMD | 98% |
| TensorFlow 2.20 | ⚠️ 部分支持 | ⚠️ 需插件 | ✅ Horovod | 85% |
| NeMo Framework | ✅ 深度优化 | ✅ 完整 | ✅ 原生 | 105%(最优) |
💡 推荐:优先使用 NeMo Framework
NeMo Framework 是 NVIDIA 专为 Rubin 平台深度优化的 AI 开发框架:
- ✓ 开箱即用:预配置 FP4/FP8 混合精度训练
- ✓ MoE 优化:专家并行、张量并行、流水线并行自动调度
- ✓ 长上下文支持:原生支持 1M+ tokens 上下文
- ✓ 一键部署:训练完成后直接导出至 Triton Inference Server
- ✓ 性能最优:相比 PyTorch 提升 5-10%
10.3 代码迁移指南
📝 从 Hopper/Blackwell 迁移至 Rubin
步骤 1:环境准备
# 安装 CUDA 14
conda create -n rubin python=3.11
conda activate rubin
pip install torch==2.7.0+cu140 -f https://download.pytorch.org/whl/torch_stable.html
pip install transformers accelerate bitsandbytes

# 验证安装
python -c "import torch; print(torch.cuda.get_device_name(0))"
# 输出:NVIDIA Rubin R200
步骤 2:启用混合精度(FP4/FP8)
# 旧代码(FP16)
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.1-405B")

# 新代码(FP4)
from transformers import BitsAndBytesConfig

quantization_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3.1-405B",
    quantization_config=quantization_config,
    device_map="auto"
)
步骤 3:优化数据并行
# 启用 FSDP(全分片数据并行)
from torch.distributed.fsdp import FullyShardedDataParallel as FSDP
from torch.distributed.fsdp.wrap import transformer_auto_wrap_policy

model = FSDP(
    model,
    auto_wrap_policy=transformer_auto_wrap_policy,
    mixed_precision=MixedPrecision(
        param_dtype=torch.float4,  # Rubin 新增
        reduce_dtype=torch.bfloat16,
        buffer_dtype=torch.bfloat16
    )
)
步骤 4:启用 NVLink 6 优化
# 设置 NCCL 环境变量
export NCCL_NVLINK_ENABLE=1
export NCCL_NET_GDR_LEVEL=5
export NCCL_P2P_LEVEL=NVL  # NVLink 6 专用
export NCCL_SHARP_ENABLE=1  # 启用 SHARP 集合通信加速

# 训练启动
torchrun --nproc_per_node=72 train.py
10.4 性能调优最佳实践
1️⃣ 内存优化
- 激活检查点:降低 50% 内存占用
- 梯度累积:小 batch 模拟大 batch
- CPU Offload:优化器状态卸载至 CPU
- Flash Attention:减少注意力层内存
2️⃣ 通信优化
- 重叠计算与通信:异步 All-Reduce
- 梯度压缩:FP16→FP8 传输
- 拓扑感知调度:减少跨机柜通信
- SHARP 加速:网内集合计算
3️⃣ 计算优化
- Tensor Core 利用:矩阵维度对齐
- Kernel Fusion:减少内存访问
- 动态形状优化:避免重新编译
- 多流并发:充分利用 GPU
4️⃣ I/O 优化
- 数据预取:提前加载下一批数据
- 混合精度存储:FP4 checkpoint
- 分布式存储:避免单点瓶颈
- 压缩传输:减少网络带宽占用
🎯 目标:MFU(模型 FLOPS 利用率)≥ 50%
MFU 是衡量 GPU 集群效率的关键指标:
- MFU < 30%:有严重性能问题,需全面优化
- MFU 30-40%:可接受,但仍有优化空间
- MFU 40-50%:良好,符合行业平均水平
- MFU > 50%:优秀,接近理论上限
通过上述优化,Rubin NVL72 可稳定达到 45-55% MFU。
十一、环境影响与可持续性
11.1 碳排放分析
训练 1T 参数模型的碳足迹对比(吨 CO₂e)
| 平台 | 训练时间 | 总功耗(MWh) | 碳排放(吨 CO₂e) | 等效树木吸收量 |
|---|---|---|---|---|
| H100 集群(2048 GPU) | 120 天 | 1,843 MWh | 921 吨 | 41,900 棵/年 |
| GB300 NVL72(288 GPU) | 40 天 | 456 MWh | 228 吨 | 10,400 棵/年 |
| Rubin NVL72(72 GPU) ✅ | 157 天 | 498 MWh | 249 吨 | 11,300 棵/年 |
| Rubin SuperPOD(576 GPU) ✅✅ | 20 天 | 317 MWh | 159 吨(最优) | 7,200 棵/年 |
11.2 能效提升分析
⚡ 每瓦算力
相比 GB300(17.8)提升 70%
🌡️ PUE(电源使用效率)
液冷优化,相比传统 1.5 降低 25%
💧 废热回收
可用于建筑供暖,能量再利用
🔋 储能削峰
机架级电容储能,降低电网冲击
11.3 绿色能源使用建议
☀️ 太阳能数据中心
- 案例:Meta 的太阳能 AI 工厂
- 配置:50 MW 太阳能 + 储能系统
- 优势:白天运行 AI 训练,晚上使用储能
- 碳中和:100% 可再生能源
💨 风电数据中心
- 案例:Google 的丹麦数据中心
- 配置:直连近海风电场
- 优势:电价低廉,碳排放低
- 挑战:电力波动,需配储能
⚡ 核电数据中心
- 案例:Microsoft 与核电厂合作
- 配置:小型模块化反应堆(SMR)
- 优势:稳定供电,零碳排放
- 前景:适合超大规模 AI 工厂
💧 水电数据中心
- 案例:AWS 在冰岛的数据中心
- 配置:100% 水电 + 地热冷却
- 优势:低成本,低碳排放
- 局限:地理位置限制
🌍 数据中心选址建议
优先级排序(考虑碳排放 + 成本):
- 第一梯队:冰岛、挪威、加拿大魁北克(100% 水电/地热,PUE < 1.1)
- 第二梯队:华盛顿州、俄勒冈州、苏格兰(风电 + 水电混合)
- 第三梯队:新加坡、爱尔兰、荷兰(高比例可再生能源,但气候较暖)
- 避免:燃煤发电为主的地区(碳排放高,不利于 ESG 评级)
11.4 废热回收利用
♨️ 45°C 温水液冷的附加价值
Rubin NVL72 的液冷系统出水温度高达 45°C,这一"废热"可直接用于:
- ✓ 建筑供暖:北欧多个数据中心已将废热输送至城市供暖管网
- ✓ 工业预热:用于食品加工、化工等需要热水的行业
- ✓ 温室种植:荷兰数据中心为周边温室提供热源
- ✓ 水产养殖:用于温水鱼类养殖
经济效益:每机柜 115 kW 废热,按 8760 小时/年计算,可回收热能约 1,007 MWh/年,折算供暖收入 $50,000-80,000/年。
十二、安全性与合规性
12.1 数据加密与隐私保护
🔒 静态数据加密
- 存储加密:AES-256 全盘加密
- Key Management:硬件 TPM 2.0 密钥管理
- HBM4 内存加密:支持透明内存加密(TME)
- 模型保护:训练权重加密存储
🔐 传输数据加密
- TLS 1.3:网络通信端到端加密
- NVLink 加密:GPU 间通信硬件加密
- RDMA 安全:InfiniBand IPsec 支持
- 密钥轮换:自动化密钥定期更新
🛡️ 访问控制
- RBAC:基于角色的细粒度权限管理
- MFA:多因素认证强制启用
- 审计日志:所有操作完整记录
- Zero Trust:默认拒绝,最小权限原则
🔍 威胁检测
- 入侵检测:实时网络流量监控
- 异常行为分析:AI 驱动的威胁识别
- 漏洞扫描:定期安全评估
- 应急响应:7×24 安全团队
12.2 多租户隔离
🏢 企业级安全隔离方案
| 隔离层级 | 技术方案 | 安全等级 |
|---|---|---|
| 物理隔离 | 独立机柜,专用网络 | ⭐⭐⭐⭐⭐ |
| 虚拟化隔离 | MIG(多实例 GPU)+ 容器 | ⭐⭐⭐⭐ |
| 命名空间隔离 | Kubernetes Namespace + Network Policy | ⭐⭐⭐ |
| 进程隔离 | CUDA Context 隔离 | ⭐⭐ |
推荐配置:
- 金融/医疗行业:物理隔离(独立机柜)
- 企业客户:MIG 虚拟化 + 网络隔离
- 开发测试:命名空间隔离
12.3 合规性认证
| 认证/法规 | 适用地区 | 要求 | Rubin NVL72 支持 |
|---|---|---|---|
| SOC 2 Type II | 全球 | 数据安全、可用性、隐私 | ✅ 完整支持 |
| ISO 27001 | 全球 | 信息安全管理体系 | ✅ 完整支持 |
| GDPR | 欧盟 | 数据隐私保护、数据主权 | ✅ 完整支持 |
| HIPAA | 美国 | 医疗数据保护 | ✅ 完整支持(需配置) |
| 中国网络安全法 | 中国 | 数据本地化、安全审查 | ⚠️ 需本地化部署 |
| FedRAMP | 美国政府 | 联邦云安全标准 | ✅ Moderate 级别 |
⚠️ 出口管制与地缘政治
美国出口管制影响:
- 中国限制:Rubin GPU 受 EAR(出口管理条例)限制,性能超过 4800 TOPS 的 AI 芯片无法直接出口至中国
- 降级版本:NVIDIA 可能推出性能削减版(如 Rubin R100C),符合出口限制
- 替代方案:中国客户可考虑华为昇腾 910C、壁仞 BR100 等国产方案
- 云服务:通过海外云服务商(AWS、Azure)间接使用 Rubin 算力
十三、财务分析与投资回报
13.1 总拥有成本(TCO)5 年期分析
💰 单机柜 Rubin NVL72 五年 TCO
| 成本类别 | 年度成本 | 5 年总成本 | 占比 |
|---|---|---|---|
| 设备采购 | $780,000(折旧) | $3,900,000 | 61.2% |
| 电力成本 | $92,380 | $461,900 | 7.2% |
| 冷却成本 | $18,476 | $92,380 | 1.4% |
| 托管费用 | $310,464 | $1,552,320 | 24.3% |
| 运维人工 | $50,000 | $250,000 | 3.9% |
| 软件许可 | $75,000 | $375,000 | 5.9% |
| 备件与维修 | $50,000 | $250,000 | 3.9% |
| 总计 | $1,376,320 | $6,881,600 | 100% |
13.2 自建 vs 云租赁成本对比
5 年期成本对比(单位:百万美元)
| 方案 | 初始投资 | 年度成本 | 5 年总成本 | 每 GPU 小时成本 |
|---|---|---|---|---|
| 自建 Rubin NVL72 ✅ | $3.9M | $1.38M | $6.88M | $2.18 |
| 云租赁(按需) | $0 | $5.53M($90/GPU-小时) | $27.67M | $90.00 |
| 云租赁(1 年预留) | $0 | $3.87M($63/GPU-小时) | $19.35M | $63.00 |
| 云租赁(3 年预留) | $0 | $2.76M($45/GPU-小时) | $13.82M | $45.00 |
13.3 投资回报率(ROI)计算
📊 不同业务场景的 ROI 分析
场景 1:AI 原生公司(如 Anthropic、OpenAI)
- 利用率:90%+(7×24 满载运行)
- 每 GPU 小时成本:$1.94(极低)
- 收入来源:API 调用收费($20-50/百万 tokens)
- 回本周期:12-15 个月
- 5 年 ROI:350-450%
场景 2:云服务商(如 AWS、Azure)
- 利用率:70%(实例租赁)
- 每 GPU 小时成本:$2.48
- 租赁价格:$85-95/GPU-小时
- 毛利率:97%
- 回本周期:15-18 个月
- 5 年 ROI:280-350%
场景 3:企业 AI 研发(如 Meta、Tesla)
- 利用率:50-60%(研发为主)
- 每 GPU 小时成本:$3.64
- 相比云租赁节省:$41-86/GPU-小时
- 回本周期:22-28 个月
- 5 年 ROI:150-220%
⚖️ 自建 vs 云租赁决策矩阵
| 决策因素 | 推荐自建 | 推荐云租赁 |
|---|---|---|
| 预期利用率 | > 60% | < 60% |
| 项目周期 | > 2 年 | < 2 年 |
| 初始资金 | > $5M | < $5M |
| 运维能力 | 有专业团队 | 无专业团队 |
| 数据敏感性 | 高(金融、医疗) | 低 |
13.4 融资租赁方案
💳 降低初始投资门槛
Operating Lease(经营租赁)方案:
- 零首付:无需支付 $3.9M 采购成本
- 月租模式:每月固定租金,包含硬件 + 维护
- 灵活升级:2-3 年后可升级至新一代平台
- 税务优化:租金可抵税,改善现金流
参考报价(单机柜 NVL72):
| 租期 | 月租金 | 总成本 | vs 自购 |
|---|---|---|---|
| 24 个月 | $195,000 | $4.68M | +20% |
| 36 个月 ✅ | $138,000 | $4.97M | +27% |
| 48 个月 | $108,000 | $5.18M | +33% |
* 以上为估算,实际价格取决于信用评级和市场利率
十四、故障恢复与高可用性
14.1 系统可靠性设计
📈 设计可用性
年度停机时间 < 4.4 小时
🔧 MTBF(平均故障间隔)
约 5.7 年持续运行
⚡ MTTR(平均修复时间)
热插拔托盘快速恢复
💾 数据持久性
11 个 9 的持久性(分布式存储)
14.2 常见故障场景与应对
| 故障类型 | 概率 | 影响范围 | 恢复时间 | 应对措施 |
|---|---|---|---|---|
| 单 GPU 故障 | 0.5%/年 | 1/72 GPU | 5-10 分钟 | 软件层面绕过故障 GPU,等待维护窗口更换托盘 |
| 计算托盘故障 | 0.2%/年 | 4 GPU | 15-30 分钟 | 热插拔更换托盘,自动重新加入集群 |
| NVLink 交换芯片故障 | 0.1%/年 | 部分通信路径 | 20-40 分钟 | 自适应路由绕过故障交换机,更换交换托盘 |
| 液冷系统泄漏 | 0.05%/年 | 整柜 | 2-4 小时 | 紧急断电,排空冷却液,修复漏点,重新测试 |
| 供电系统故障 | 0.1%/年 | 整柜 | 即时(UPS) | UPS 供电,自动切换至备用电源,无缝过渡 |
| 网络交换机故障 | 0.3%/年 | 柜间通信 | < 1 秒 | 冗余交换机自动接管,无感知切换 |
14.3 训练任务的 Checkpoint 策略
💾 自动化 Checkpoint 最佳实践
推荐配置:
- Checkpoint 频率:每 1,000-2,000 步保存一次
- 保存位置:分布式文件系统(GPFS、Lustre、Weka)
- 压缩存储:FP4 checkpoint,节省 75% 存储空间
- 增量 Checkpoint:仅保存变化的参数,加快保存速度
- 异步保存:训练和保存并行,不阻塞训练进程
恢复策略:
# PyTorch 示例
from torch.distributed.checkpoint import save, load

# 保存 checkpoint
save(
    state_dict={
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "step": current_step
    },
    checkpoint_id=f"ckpt_{current_step}",
    storage_writer=DistributedFileSystemWriter("/mnt/shared/checkpoints")
)

# 恢复 checkpoint
state_dict = load(
    checkpoint_id="ckpt_latest",
    storage_reader=DistributedFileSystemReader("/mnt/shared/checkpoints")
)
model.load_state_dict(state_dict["model"])
optimizer.load_state_dict(state_dict["optimizer"])
14.4 灾难恢复方案
🔄 同城双活
- 配置:2 个数据中心,距离 < 50 km
- 同步方式:实时双写 checkpoint
- RTO:< 5 分钟
- RPO:< 1 分钟
- 成本:2× 硬件投资
🌍 异地热备
- 配置:主数据中心 + 异地备份中心
- 同步方式:定期异步复制
- RTO:< 1 小时
- RPO:< 1 小时
- 成本:1.5× 硬件投资
☁️ 云端备份
- 配置:本地训练 + 云端 checkpoint
- 同步方式:每 N 步上传至 S3/Azure Blob
- RTO:< 4 小时
- RPO:< 6 小时
- 成本:仅存储费用($0.02/GB-月)
📦 离线归档
- 配置:关键 checkpoint 离线存储
- 同步方式:重要里程碑手动备份
- RTO:< 24 小时
- RPO:里程碑时间点
- 成本:极低(磁带/冷存储)
💡 推荐方案:3-2-1 备份原则
- 3 份副本:主副本 + 2 个备份
- 2 种介质:本地存储 + 云端存储
- 1 个异地:至少 1 个备份在不同地理位置
对于价值数百万美元的训练任务,3-2-1 原则可有效防止数据丢失。
十五、总结:机架级加速器的时代已来
🎯 核心要点
- 范式转变:NVL72 不是 72 台服务器,而是一个 3.6 ExaFLOPS 的机架级 GPU
- 六芯协同:Vera Rubin 平台通过极致共设计,将 6 款芯片整合为统一系统
- 性能跃迁:推理性能提升 2.5×,训练性能提升 3.5×,Token 成本降低 10×
- 代际领先:NVLink 6 带宽翻倍至 260 TB/s,HBM4 带宽提升至 1.58 PB/s
- MoE 优化:训练 MoE 模型所需 GPU 数量减少 75%
- 工程创新:预集成铜缆、模块化托盘、算-电-热协同设计
- 生态垄断:从"卖 GPU"升级为"卖 AI 工厂",巩固市场主导地位
- 产业影响:重塑 AI 竞争格局,推动数据中心基础设施变革
🌟 最后的思考
Vera Rubin NVL72 的发布标志着 AI 算力进入了机架级加速器时代。英伟达不再仅仅是一家芯片公司,而是演变为 AI 基础设施平台提供商。
对于企业而言,这意味着:
- ✓ 降低推理成本,使大规模 AI 应用经济可行
- ✓ 缩短模型迭代周期,加速 AI 创新
- ✓ 简化部署复杂度,即插即用的 AI 算力
对于产业而言,这意味着:
- ✓ 进入门槛大幅提高,中小企业更依赖云服务
- ✓ 竞争格局重塑,巨头主导 AI 基础设施
- ✓ 数据中心变革,供电、冷却、网络全面升级
未来已来,ExaFLOPS 时代的算力革命才刚刚开始。
⏰ 行动建议
- 对于企业:如计划在 2027 年部署 AI 基础设施,应立即启动采购流程(交付周期 18-24 个月)
- 对于开发者:尽早熟悉 CUDA 14、TensorRT-LLM 等新工具,为 Rubin 平台做好准备
- 对于投资者:关注 AI 基础设施产业链(芯片、封装、液冷、数据中心),长期增长确定性高