📋 摘要
本报告全面深入地分析华为超节点的市场现状、技术竞争力、应用生态及未来发展趋势。华为凭借"集群即计算机"的系统级创新理念推出的超节点解决方案,正在重塑中国乃至全球高性能计算市场格局。
研究发现,华为超节点通过光电融合、通信驱动架构,在系统级算力、吞吐量和可扩展性方面展现出与国际顶尖水平(Nvidia)相抗衡甚至在部分指标上超越的潜力。CloudMatrix 384系统和规划中的Atlas 950/960 SuperPoD系列产品,标志着华为正从单点芯片性能追赶转向通过系统工程优势实现整体领先。
市场层面,国产超节点市场正迎来爆发式增长,2025至2028年间将实现高达194%的复合年均增长率,华为作为绝对领导者已部署300+套超节点(乐观估计达550套),销售额突破200亿元,广泛服务于互联网、金融、运营商、能源等20+行业。
主要挑战:单芯片能效方面与Nvidia最新解决方案相比仍存在差距(单位算力功耗高出约2-3倍,系统级高出约4倍),构建能与CUDA生态相媲美的软硬件生态仍是长期战略任务。
📖 引言:AI大模型时代对算力的需求
自2020年代初,以GPT系列、盘古、文心一言等为代表的千亿、万亿参数级别大模型相继问世,标志着AI进入"炼大模型"和"用大模型"的全新阶段。大模型训练需要数千乃至上万个高性能GPU连续运行数周甚至数月,形成了对"万卡集群"的刚性需求。
传统数据中心架构和单机性能提升模式已难以为继。算力瓶颈不仅体现在芯片本身,更体现在连接数千个计算单元的系统互联、内存协同、存储访问和集群管理等多个层面。因此,能够提供极致规模、极致效率和极致可靠性的新一代AI算力基础设施——"超节点"及其集群,应运而生。
1战略与产品体系解析
1.1 超节点概念与技术演进
"超节点"(Super Node)并非严格行业标准术语,而是华为等厂商提出的面向AI大模型时代的数据中心级计算架构理念。其核心思想是打破服务器机柜物理边界,将成百上千个AI处理器、海量内存、高速网络和存储资源进行池化和统一管理,构建逻辑上单一、可无限扩展的"超级计算机"。
| 特征 | 超节点(Scale-Up) | 传统集群(Scale-Out) |
|---|---|---|
| 带宽 | Tbps级别(如NVL72单GPU 7.2Tbps) | 通常400Gbps级别 |
| 时延 | 百纳秒级(0.1微秒) | 微秒级(10微秒以上) |
| 内存 | 统一内存编址,跨GPU直接访问 | 独立内存,网络传输 |
| 适用场景 | 张量并行、专家并行等高通信量任务 | 流水线并行、数据并行等低通信量任务 |
1.2 "集群即计算机"战略
面对美国技术制裁导致获取最先进单芯片制程受限,华为制定以系统级创新弥补单点性能差距的非对称竞争战略——"集群即计算机"(Cluster as a Computer)。
通信驱动设计(Communication-Driven Design)
传统计算以计算为中心,通信为辅。华为反其道而行之,将高速、无阻塞的通信网络作为整个架构的基石,确保在大规模并行计算中,数据交换不会成为瓶颈,实现"计算不等待通信"。
系统级工程突破
整合计算、网络、存储、能源等全栈技术能力,对超节点的硬件形态、散热系统(如先进液冷技术)、供电模块、管理软件等进行一体化设计,追求整体效率最大化。
软件定义与生态构建
通过自研CANN(异构计算架构)软件平台和MindSpore AI框架,实现对底层硬件的极致优化和高效调度,同时积极构建昇腾计算产业生态,以对抗Nvidia CUDA的生态壁垒。
1.3 华为超节点产品矩阵
Atlas 900 / CloudMatrix 384
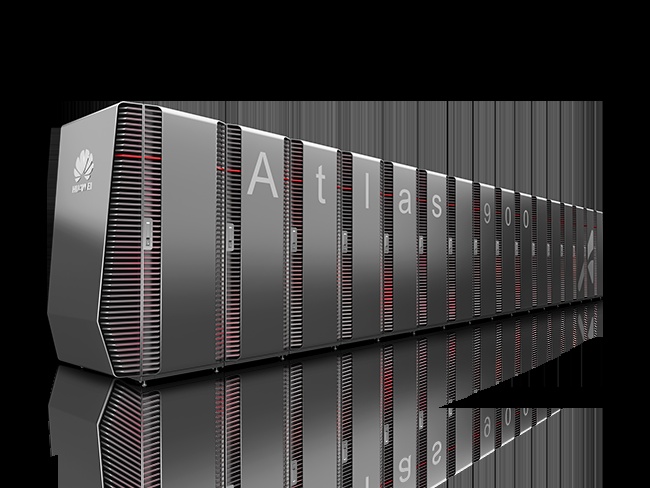
- 发布时间:2025年3月(CloudMatrix 384)
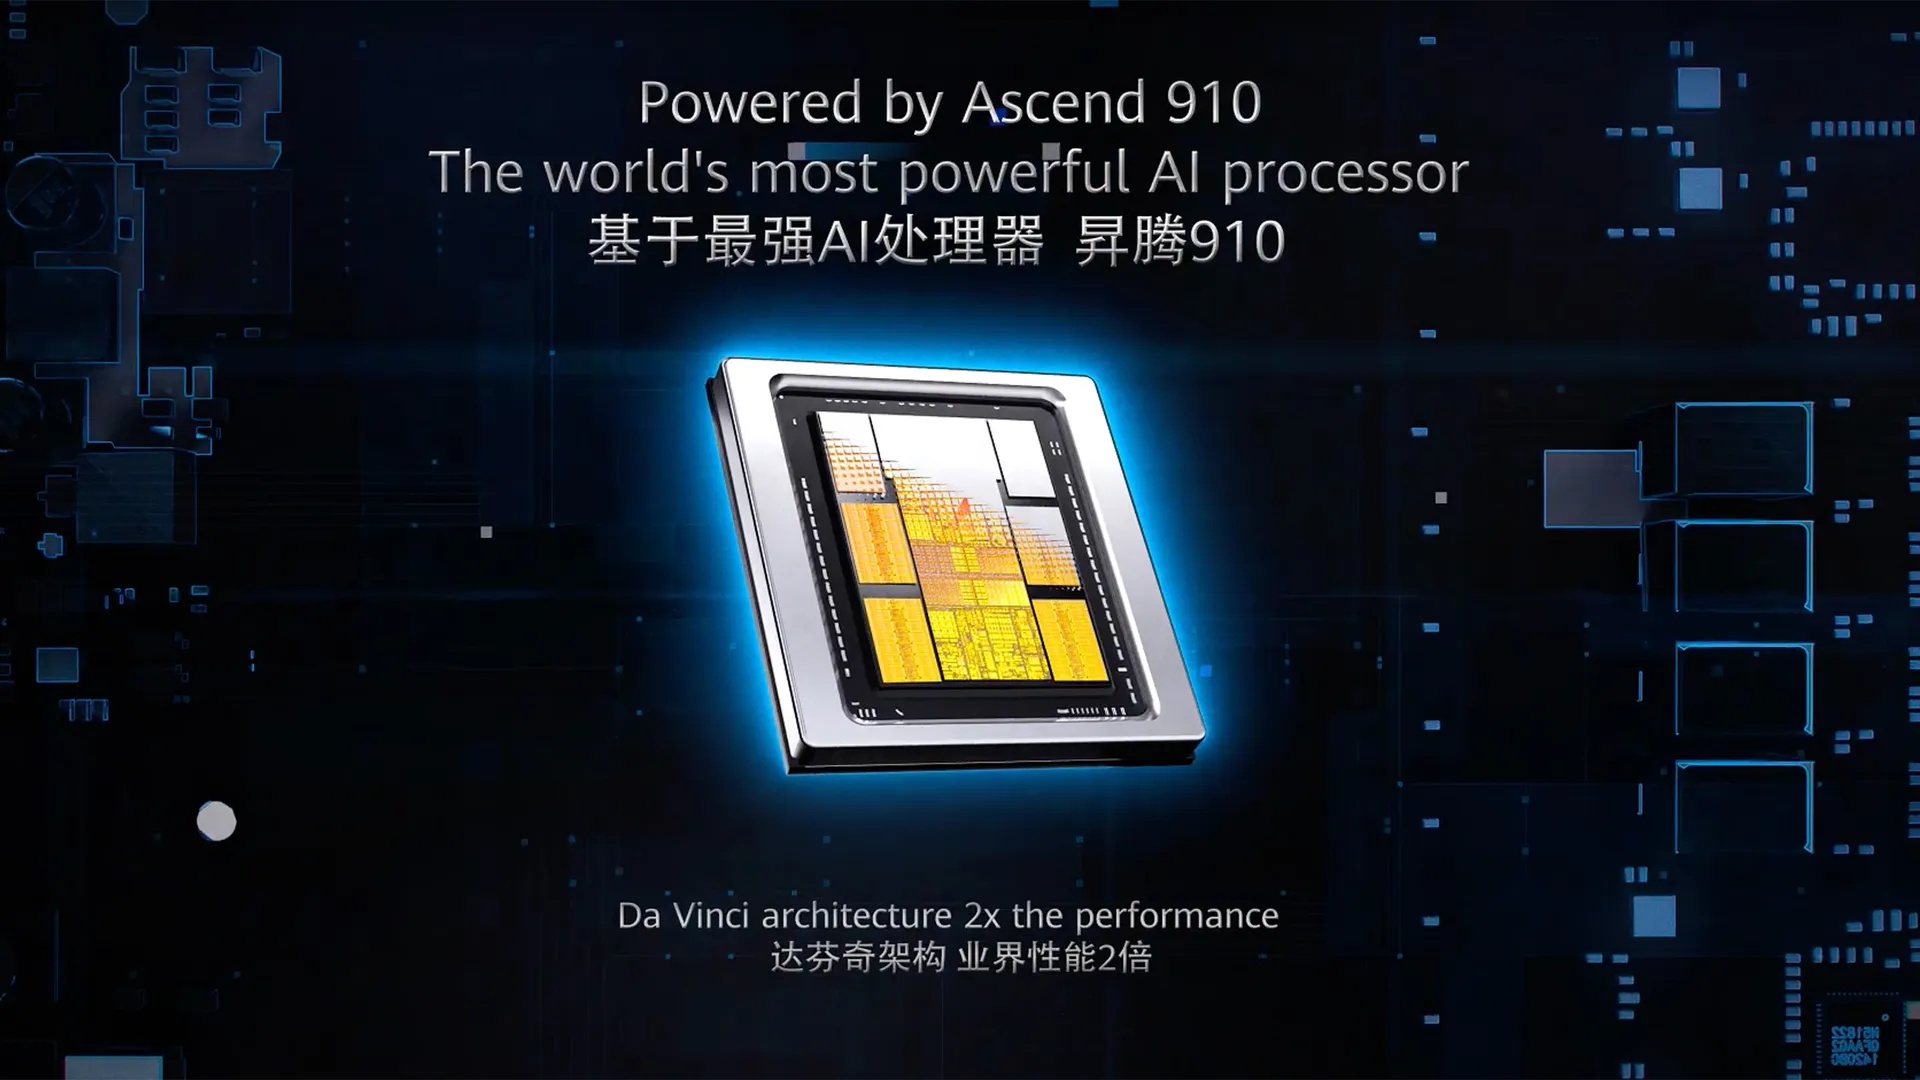
- 核心配置:基于384个昇腾910系列AI处理器,分布在12个计算机箱和4个总线机箱
- 算力:高达300 PFLOPS(FP16),48 TB HBM内存
- 市场表现:累计部署300+套,服务互联网、金融、运营商、电力等20+行业
Atlas 950 SuperPoD
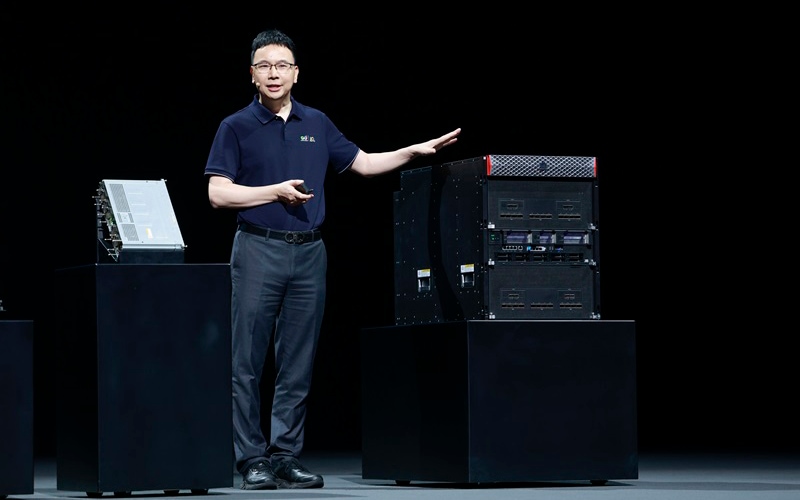
- 发布时间:2025年9月,2026年Q4正式上市
- 核心芯片:昇腾950DT
- 规模:支持8,192张昇腾950DT卡高速互联
- 算力:约8 EFLOPS(FP8)/ 16 EFLOPS(FP4)
- 定位:超大规模AI训练与推理,万亿参数级别超大模型
Atlas 960 SuperPoD
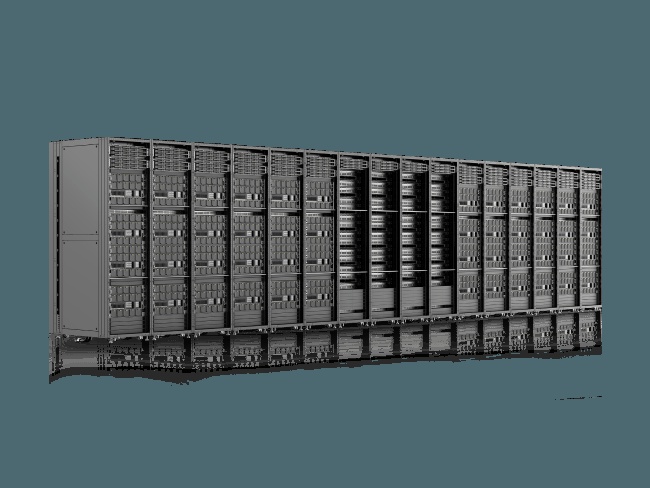
- 发布时间:2025年9月,预计2027年Q4上市
- 核心芯片:昇腾960
- 规模:支持15,488张昇腾960卡,全球最大规模
- 目标算力:30 EFLOPS(FP16)
- 定位:面向AGI级别的模型研究与开发
TaiShan 950 SuperPoD(通算超节点)
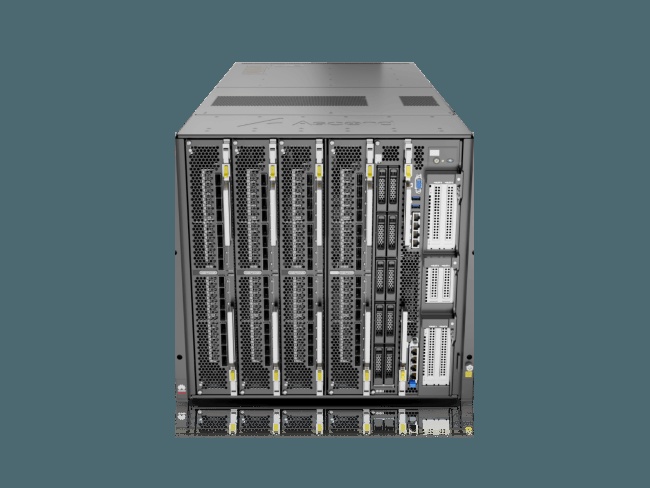
- 定位:业界首款通算超节点
- 特点:解决通算场景时延高、数据搬移开销大、协同效率低的难题
- 应用:搜索推广、数据库等通用计算场景
1.4 核心技术——灵衢协议
华为开创了面向超节点的互联协议"灵衢"(UnifiedBus),该协议基础协议文本达600页,已获得近24000份下载,完全开放给所有开发者,支持万卡级超节点互联。
1.5 产品路线图
2技术架构与竞品对比
2.1 核心技术架构
星河(Cetus)网络架构
华为自研的"星河"互联架构,通过光电融合技术实现极致性能:
统一内存编址
通过高速网络实现整个集群内存空间的统一编址,任何计算单元都可像访问本地内存一样直接访问其他单元的内存,极大简化大规模并行编程复杂性。
2.2 关键性能指标对比
| 产品 | 芯片 | 规模 | 峰值算力 | HBM内存 | 网络架构 | 年份 |
|---|---|---|---|---|---|---|
| Atlas 900 (CloudMatrix 384) | 昇腾910C | 384卡 | 300 PFLOPS (FP16) | 48 TB | 早期架构 | 2025 |
| Atlas 950 SuperPoD | 昇腾950DT | 8,192卡 | 8 EFLOPS (FP8) | — | 星河互联 | 2026预计 |
| Atlas 960 SuperPoD | 昇腾960 | 15,488卡 | 30 EFLOPS (FP16) | — | 星河互联 | 2027/28规划 |
| Nvidia GB200 NVL72 | Blackwell | 72卡 | 720 PFLOPS (FP8) | — | NVLink 5 | 量产 |
2.3 与主要竞品横向对比
vs Nvidia(NVL72, H100)
✓ 华为优势
- 系统规模:可构建更大单一集群(15488卡 vs NVL72的72卡)
- 吞吐量:宣称达NVL72系统的166%
- 网络时延:光电融合星河网络,150ns超低延迟
- 本土化:自主可控,战略优势明显
✗ 华为劣势
- 单芯片性能:昇腾910与H100存在代差
- 能效比:单芯片能效落后约20-30%,系统级每Petaflop能耗高出约2.3倍
- CUDA生态:十多年积累,护城河深厚
- 全球市场:受制裁影响,仅限特定市场
vs AMD(Instinct MI300X)
AMD MI300X在FP32/FP64浮点性能、内存容量(192GB HBM3)和内存带宽(5.3 TB/s)方面相较H100有明显优势。华为与AMD共同目标是打破Nvidia垄断地位,AMD优势在于ROCm开放平台和高性价比,华为优势在于端到端解决方案能力。
Atlas 950 vs Nvidia NVL576
| 指标 | Atlas 950 SuperPoD | Nvidia NVL576(2027年计划) |
|---|---|---|
| 规模 | 8192卡 | 576卡 |
| 互联带宽 | 16.3 PB/s | — |
| FP8算力 | 8 EFLOPS | — |
| 定位 | 万卡级超节点 | 中等规模集群 |
即便与英伟达计划2027年上市的NVL576相比,Atlas 950超节点在规模上依然大幅领先。
Atlas 950 性能提升(对比昇腾384)
2.4 灵衢互联协议关键技术指标
| 指标 | 数值 | 行业对比 |
|---|---|---|
| 灵衢全光互联带宽 | 16.3 PB/s | 业界水平的 62倍 |
| RTT通信时延 | 3微秒 | 较传统以太网优化 50% |
| 共享内存池 | 1152 TB | 内存统一编址 |
| FP8算力 | 8 EFLOPS | 业界水平的 6.7倍 |
| FP4算力 | 16 EFLOPS | 业界水平的 6.7倍 |
华为提出的"超大带宽、超低时延、内存统一编址"三大核心要素,为行业提供了重要的技术参考框架。
2.5 MLPerf性能验证
- 训练环节:超节点系统可保全0.97~1.11x性能表现
- 推理环节:可实现1.23~1.50x的大幅效率增益
- 计算资源利用率:从行业平均30%提升至45%以上
3成本效益与能效评估
3.1 每PFLOPS成本分析
竞品单卡成本
华为超节点以"整机柜交付"的SuperPoD形式,虽然初始投资可能较高,但可能为客户节省大量的系统集成和调试成本。在评估成本时,必须采用总拥有成本(TCO)视角。
3.2 能效指标(FLOPS/Watt)评估
单芯片能效对比
系统级能效对比
关键数据:
- 华为超节点机架总功耗是Nvidia机架的 3.9倍(因规模更大,384卡 vs 72卡)
- 单位算力(每Petaflop)能耗是Nvidia的 2.3倍(当前系统级对比)
- 每TB/s内存带宽的能耗高 1.8倍
- 有分析预测,若对比2026年Nvidia Rubin架构,差距可能扩大至 6-10倍(悲观情景)
能效差距原因分析
3.3 综合性价比分析
尽管在能效和可能存在的硬件成本上处于劣势,但评估华为超节点综合性价比时,必须考虑以下关键因素:
- 电力成本差异:在中国西部等电力成本较低地区,较高能耗带来的电费增长可能被性能优势抵消
- 自主可控溢价:对政府、金融、军工等关键行业客户,"安全溢价"使客户愿意接受更高TCO
- 时间成本价值:如果华为超节点能缩短大模型训练时间20-30%,节省的时间成本可能远超增加的电费
综合来看,华为超节点并非"廉价"选项,而是一个面向特定市场、具有高度战略价值的高性能解决方案。其性价比不能仅从单一维度衡量,而应结合其在中国市场的独特地位和系统级性能优势进行综合评估。
4市场规模与增长预测
4.1 全球AI算力市场概览
全球AI算力市场正经历前所未有繁荣。IDC预测,到2025年仅中国AI芯片市场规模就将达到178亿美元,其中国产芯片复合增长率高达42%。大模型的出现,将算力需求重心从通用计算转向以AI加速器为核心的智能计算。
4.2 国产超节点市场规模预测(2025-2028年)
4.3 华为市场地位与份额
在国产超节点细分市场,华为是毫无疑问的开创者和领导者。凭借技术代差和生态优势,在2025-2027年间仍将占据70%以上的绝对主导市场份额。
4.4 核心增量环节
| 增量环节 | 2028年预测 | CAGR |
|---|---|---|
| Scale Up交换芯片 | 172亿元 | 231% |
| 超节点Switch Tray | 277亿元 | 204% |
| AI高速铜连接 | 309亿元 | 46% |
4.5 国际市场拓展
MWC 2026 首次海外亮相
2026年3月2日,华为在巴塞罗那世界移动通信大会(MWC 2026)上首次面向全球市场展示超节点算力集群,标志着华为将其超算技术从国内的"国产领跑"阶段正式推向国际舞台。华为计算产品线总裁张熙伟表示,将坚持开源开放,打造坚实算力底座,为世界提供新选择。
海外发布核心产品
目标应用场景
| 场景 | 产品 | 核心价值 |
|---|---|---|
| 混合负载 | TaiShan 950 SuperPoD | 同一硬件同时处理传统数据库事务(OLTP)和AI推理(LLM),适合金融、通信、云服务商 |
| 大型AI训练 | Atlas 950 SuperPoD | 万卡级AI模型训练,解决万亿参数模型激增带来的算力瓶颈 |
| 千卡级推理 | Atlas 950 SuperPoD | 高吞吐量推理服务,支持大规模并发AI应用 |
技术标准输出
华为在国际市场不仅展示硬件,更强调全栈技术能力。通过发布 Atlas 350 加速卡和全光互联技术(如光跃 LightSphere X),华为试图在国际市场推广其软硬件一体的算力解决方案体系,建立技术标准和生态。
华为全球区域收入(2025年)
目标市场与客户
| 区域 | 状态 | 关键驱动因素 |
|---|---|---|
| 中东(UAE、沙特) | 早期接触/洽谈中 | 沙特"Vision 2030"数字转型计划 |
| 东南亚(泰国) | 潜在客户接触 | 政府支持的创新园区和AI产业应用 |
| 拉美 | 电信基础设施合作 | 绿色站点改造、算力服务需求 |
| 非洲 | 机房改造与算力服务 | 老旧机房升级、网络韧性建设 |
出口产品策略
- 昇腾910C芯片:优先保供国内,暂未有计划单独向海外出口
- 昇腾910B芯片:可向中东、东南亚等地区少量出口(低千片级别),用于测试市场反应
- CloudMatrix 384超节点:作为系统级产品向海外推销,但供应规模有限
华为云全球布局(KooVerse)
华为云通过 KooVerse 全球存算网提供弹性云服务,在MWC期间面向全球市场推出数据中心云迁移、企业IT上云、灾备与业务连续性等解决方案,以"服务"形式突破硬件出口限制。
KooVerse 三层架构
30ms时延覆盖圈
贵州/内蒙古/安徽等
10ms时延覆盖圈
全球主要城市
5ms以内超低时延
工业制造/无人驾驶
全球覆盖规模
全球数据中心分布
区域详情
| 区域 | 节点 | 可用区 | 时延级别 | 架构层级 |
|---|---|---|---|---|
| 中国 | 华北-北京、华东-上海、华南-广州、华南-深圳、西南-贵阳、华北-乌兰察布等 | 多AZ | — | CloudOcean |
| 亚太 | 中国香港、新加坡、曼谷、雅加达、马尼拉、东京、首尔等 | 2-3 AZ | <10ms | CloudSea/CloudLake |
| 欧洲 | 爱尔兰、伦敦、巴黎、法兰克福、阿姆斯特丹等 | 2-3 AZ | <10ms | CloudSea |
| 中东 | 利雅得、迪拜、伊斯坦布尔等 | 2 AZ | <10ms | CloudSea |
| 非洲 | 约翰内斯堡、开罗等 | 1-2 AZ | <10ms | CloudSea |
| 拉美 | 墨西哥城、圣保罗、圣地亚哥、布宜诺斯艾利斯、利马等 | 1-2 AZ | <10ms | CloudSea |
绿色数据中心
安全与合规
华为云已获得140+安全合规认证,覆盖全球主要市场的数据安全与隐私保护要求,包括GDPR、等保2.0等。
国际竞争与挑战
✗ 主要障碍
- 美国出口管制:2025年5月,美国商务部明确全球任何地方使用华为昇腾系列AI芯片均违反美国出口管制
- 软件生态差距:NVIDIA CUDA平台仍是行业标准,MindSpore和CANN生态仍在追赶
- 能效劣势:CloudMatrix 384总功耗达559kW(384卡),NVL72为136kW(72卡);标准化后每FLOP功耗高出约2.3倍
- 制程限制:无法使用台积电3nm/5nm先进制程,单芯片性能落后一代
✓ 竞争优势
- 地缘政治中立方案:为寻求非美国AI硬件替代方案的国家提供选择
- 混合负载创新:TaiShan 950一机多用,填补传统服务器与AI服务器之间的技术空白
- 系统级性能:通过架构创新,系统层面实现对标甚至超越英伟达GB200 NVL72
- 云服务模式:通过华为云KooVerse提供弹性算力,降低客户upfront投资
部署现状与前景
未来展望
- 短期目标(2026-2027):在至少一个海湾或东南亚主要市场获得出口订单,验证海外推广策略
- 生态建设:通过全面开源CANN异构计算架构,吸引全球开发者
- 云服务扩展:依托华为云全球基础设施,以服务形式突破硬件出口限制
- 长期战略:华为超节点国际化是中国科技主权战略的体现,为Global South国家提供地缘政治中立的AI基础设施选择
5行业应用与客户案例
5.1 主要应用场景
5.2 重点行业应用
| 行业 | 应用场景 | 业务价值 |
|---|---|---|
| 互联网 | 基础大模型训练与推理、AIGC、搜索广告 | 加速AI竞赛,抢占市场先机 |
| 金融 | 反电诈风控、量化交易(时延要求<10ms) | 实时拦截电诈,纳秒级时延为风控争取宝贵反应时间 |
| 运营商 | 网络优化、智能客服 | 全面赋能运营商AI基础设施升级 |
| 能源 | 电网调度、故障预测 | 实时分析电网数据,提升能源利用效率 |
| 制造 | 智能质检、研发设计仿真 | 降低次品率,加速新产品研发 |
5.3 智能体互联网时代需求
大模型参数规模已迈入万亿级时代,智能体(Agentic AI)深度融入各行各业生产核心环节:
华为三层注智方案(全球运营商)
5.4 集群规模与业务价值
- 单个集群规模可从384卡基础超节点扩展至8,192卡、乃至16万卡(由432个超节点组成)的超级集群
- 支持千卡级集群分布式训练,通信开销控制在5%以内
- 提升系统可靠性,支持长达数周不中断的连续训练
- "计算不等待通信、训练不中断"——更短训练时间帮助企业在AI竞赛中抢占先机
6生态系统与合作伙伴
6.1 昇腾计算产业生态
昇腾生态核心是CANN(Compute Architecture for Neural Networks)——专为昇腾处理器设计的异构计算架构,类似于Nvidia的CUDA,为上层AI框架和应用提供统一编程接口。
6.2 硬件与软件合作伙伴
华为AI云服务已支持超过1,300个客户,共同加速各行各业的智能化升级。
6.3 开源生态体系
CANN异构计算架构通过全栈解耦策略,将算子库、加速引擎等核心组件全面开源,支持开发者根据项目需求灵活调用。目前已与 Triton、PyTorch 等主流开源框架实现深度对接,显著降低了AI开发的技术门槛。
6.4 生态建设挑战与机遇
✗ 主要挑战
- CUDA惯性:Nvidia CUDA十多年发展,已成为事实标准,迁移成本巨大
- 人才短缺:熟悉昇腾架构和CANN/MindSpore的专业人才仍然稀少
- 工具链差距:在应用广度、开发者社区成熟度上仍有较大差距
✓ 发展机遇
- 本土市场保护:中国信创市场,昇腾是唯一可规模化获得的高端AI计算平台
- 行业样板间:与行业龙头客户深度绑定,打造可复制推广的"杀手级"解决方案
- 开放兼容:积极拥抱开源社区,持续优化PyTorch等主流框架兼容性
7结论与战略建议
7.1 核心研究结论
- 技术路径清晰且有效:通过光电融合、通信驱动的架构设计,在系统级算力、可扩展性和网络性能上构建核心竞争力。
- 市场地位稳固且增长迅猛:凭借技术领先和先发优势,占据国产超节点市场绝对主导地位,2025-2028年194%CAGR的高速增长赛道前景极为广阔。
- 应用广泛且价值显著:已渗透到互联网、金融、能源、制造等20+关键行业,实现从"可用"到"好用"的跨越。
- 短板与挑战并存:能源效率是当前最显著短板;与CUDA生态相比,昇腾软件生态建设仍任重道远。
7.2 全球战略意义
华为超节点在MWC 2026的海外首秀,标志着国产算力技术正式进入全球竞争舞台。尽管面临制程限制和地缘政治挑战,华为通过系统级创新实现了整体算力的跨越式发展,为全球市场提供了差异化选择。
7.3 市场机遇与风险
- 技术迭代压力:Nvidia等竞争对手仍在快速创新,如华为无法有效改善能效问题,TCO劣势可能被放大
- 生态固化风险:昇腾生态无法吸引足够开发者,可能被边缘化为"小众"高性能计算平台
- 供应链不确定性:在全球地缘政治高度不确定的背景下,供应链的任何波动仍是潜在风险
7.4 战略建议
对华为
- 攻关能效瓶颈:将提升能源效率作为下一代昇腾芯片和超节点系统设计的核心目标
- 加倍投入生态:投入更多资源用于CANN和MindSpore的工具链完善、开发者社区运营和高校人才培养
- 深化行业方案:从卖产品转向卖"能力",与行业龙头客户成立联合创新实验室,打造可复制推广的"杀手级"行业解决方案
对产业链合作伙伴(硬件商、ISV)
- 坚定拥抱昇腾生态:认识到昇腾在中国市场的战略必然性,尽早投入资源进行产品适配和技术整合
- 寻求差异化发展:在华为提供的基础平台之上,开发具有自身行业特色的硬件产品或软件应用
对政策制定者与投资机构
- 保持长期战略耐心:认识到构建成熟计算生态需要时间和持续投入,给予稳定的政策支持和市场环境
- 关注生态型投资:投资目光不应仅局限于华为本身,更应关注昇腾生态链上的各类合作伙伴