摘要:950 超节点的战略含义
Atlas 950 SuperPoD 是华为面向大模型训练与高并发推理发布的旗舰 AI 超节点方案。其核心不是单颗芯片参数,而是试图通过 UnifiedBus/灵衢互联、全光连接、统一内存编址和液冷高密工程,把数千颗 Ascend NPU 组织成“逻辑一台计算机”。
第一章 行业背景与算力架构变革
1.1 大模型把瓶颈从“单卡峰值”推向“系统组织能力”
Agentic AI、MoE 混合专家、强化学习和超长上下文推理对 AI 基础设施提出三类刚性要求:第一,All-to-All 与专家路由需要更低通信时延;第二,长上下文推理带来巨量 KV Cache,对跨卡内存池化有强需求;第三,万亿乃至十万亿参数训练的故障恢复与调度复杂度急剧上升。
传统 Scale-out 集群主要依赖以太网/RoCE/IB 把服务器连接起来,优势是开放、可扩展、生态成熟;但当模型并行度上升时,通信、内存复制、同步等待会侵蚀模型 FLOPS 利用率。超节点路线试图在更大范围内构造 Scale-up 语义,使更多加速器以近似单机方式协同。
1.2 超节点的三大核心特征
- 超大带宽:面向张量并行、MoE All-to-All、KV Cache 访问的高频通信。
- 超低时延:减少分布式协议栈、交换层级和同步等待。
- 统一内存编址:让远端内存访问接近 Load/Store 语义,缓解显存孤岛。
1.3 全球路线:NVIDIA 与华为的差异
NVIDIA 依托 NVLink/NVSwitch、CUDA、DGX/NVL 生态形成端到端壁垒;华为的选择是在单芯片受制于先进制程和生态迁移压力的背景下,强化系统互联、内存架构与国产化全栈。二者竞争并非简单“谁的卡更多”,而是单芯片性能、系统扩展、软件生态、供应链可获得性、总拥有成本的综合较量。
第二章 产品概况与硬件规格
2.1 发布历程与定位
- HC2025:华为披露 Ascend 950/960/970 路线图、Atlas 950/960 SuperPoD 与 SuperCluster,并发布 UnifiedBus 2.0 技术规范开放计划。
- MWC Barcelona 2026:Atlas 950 SuperPoD、TaiShan 950 SuperPoD 面向全球市场亮相,华为强调“cluster + SuperPoD”架构。
- WAIC 2026:媒体报道称 1024 卡昇腾 950 超节点真机首次线下公开展示,并获得较高关注。
- 预计商用:华为官方演讲口径为 Ascend 950DT 与 Atlas 950 SuperPoD 在 2026 年第四季度可用/上市。
2.2 满配规格表(以官方/社区公开口径为主)
| 维度 | Atlas 950 SuperPoD 满配口径 | 置信度 | 说明 |
|---|---|---|---|
| 核心芯片 | Ascend 950DT | 高 | 华为 HC2025 明确称 Atlas 950 SuperPoD built with Ascend 950DT。 |
| 芯片数/卡数 | 最多 8192 颗/张 Ascend 950DT NPU | 高 | 华为官网 MWC/HC 页面均提及 up to / scale up to 8,192 NPUs。 |
| 单柜基础单元 | 64 NPU/计算柜 | 高 | 华为 MWC 新闻与 Ascend 社区页一致。 |
| 机柜与占地 | 160 机柜:128 计算柜 + 32 通信柜;约 1000㎡ | 高 | 来自华为 HC2025 演讲。 |
| 聚合算力 | 8 EFLOPS FP8;16 EFLOPS FP4 | 高 | 华为 HC2025 演讲与多家媒体转述一致。 |
| 互联带宽 | 16 PB/s(另有媒体写作 16.3 PB/s) | 高/中 | 官方演讲为 16 PB/s;16.3 PB/s 多见于媒体或展会报道。 |
| 统一内存 | 官方强调 unified memory addressing;满配共享内存 1152TB 为媒体推算/报道口径 | 中 | Ascend 950DT 单芯片 144GB,8192×144GB≈1152TB;需区分“理论容量”和“可用池”。 |
| 展示形态 | WAIC 2026:1024 卡、1 EFLOPS FP8、2 EFLOPS FP4、256TB 统一内存编址 | 中 | 主要来自媒体/展会报道;与 8192 卡满配口径为不同形态。 |
| 上市时间 | 2026 年第四季度 | 高 | 华为 HC2025 演讲明确。 |
2.3 Ascend 950DT 芯片架构详解
Ascend 950DT 采用多芯片封装 (MCM) 设计,集成 2 个 AI Die + 10 层 HBM 堆叠,是 Atlas 950 SuperPoD 的核心计算单元。
芯片架构关键特性
- 双 AI Die 设计:2 个 AI Die 通过高速互联并行工作,提升整体计算吞吐。每个 Die 集成 DaVinci 架构核心,支持 SIMD/SIMT 双模式,优化矩阵计算和向量运算。
- HiZQ 2.0 HBM:华为自研高带宽内存,10 层堆叠提供 144GB 容量和 4TB/s 访存带宽,专为 Decode 推理和训练场景优化,解决长上下文推理的 KV Cache 访问瓶颈。
- 低精度支持:原生支持 FP8、MXFP8、MXFP4、HiF8 等格式,在保证模型精度的前提下降低 HBM 占用、减少互联传输量、提升计算吞吐。
- 高效访存优化:128B Sector-Cache 颗粒度(相比前代 512B 大幅降低),配合 NDDMA 高效数据搬运,改善 LLM 中不连续内存访问模式的效率。
- 2TB/s 芯片互联:每颗芯片提供 2TB/s 的 UnifiedBus 互联带宽,支持片间、卡间、柜间的统一互联协议。
950PR vs 950DT 架构差异
| 型号 | HBM | 带宽 | 主要场景 |
|---|---|---|---|
| 950PR | 128GB HiBL 1.0 | 1.6TB/s | Prefill 推理、推荐系统 |
| 950DT | 144GB HiZQ 2.0 | 4TB/s | Decode 推理、训练 |
同一代 950 Die,通过不同 HBM 封装适配不同负载特性。Prefill 算力密集,Decode 访存密集。
Atlas 350 加速卡亮点:
- 搭载 Ascend 950PR,1.56 PFLOPS FP4 算力
- 华为声称性能达 NVIDIA H20 的 2.87 倍
- 字节跳动等头部企业大规模采购
- 功耗 600W,约为 H20 的 1.5 倍

2.5 WAIC 2026 实物展示详解
2026年7月17-20日,Atlas 950 SuperPoD 在上海世博中心举行的世界人工智能大会(WAIC)上首次公开展示真机,成为本届大会最受关注的展品之一。据现场观众反馈,"机柜背面比正面更震撼"——华为特意将机柜背面开放展示,观众可以上手触摸 StarMatrix 800G LPO 光模块,近距离观察高密度光纤布线和液冷系统细节。
WAIC 2026 现场六大观察亮点
1. 机柜背面开放展示
- 首次允许观众上手触摸 StarMatrix 800G LPO 光模块
- 型号:OM3887S0100 (OSFP-RHS-LPO-8×100G3-50m-MM)
- 供应商:华工科技(华工正源)独家代工
- 现场挂出长条形光模块样品供参观
2. 液冷系统细节展示
- 浮动盲插接头设计,防止漏液
- 冷却液入口温度 ~20°C,出口 ~35°C
- 单柜液冷流量 ≥ 50 L/min
- 官方数据:可靠性提升一倍
3. 从铜缆到光纤的跨越
- 2025年384超节点:使用粗壮的高速铜缆
- 2026年950超节点:全光纤互联
- 重量减少 > 60%,延迟降低 10 倍
- 机柜背面布线更加整洁美观
4. 展示规模与视觉冲击
- 16 个计算柜一字排开,像一堵黑色的"算力墙"
- 1024 张昇腾卡同时运行
- 4096 个 800G 光模块密集排布
- 展台占据整面展墙,视觉震撼
5. 正交零线缆设计
- 前部计算托盘垂直插入机柜
- 后部背板自动连接电源和网络
- 免工具插拔,部署周期缩短 70%
- 维护时可单独抽出托盘,不影响其他单元
6. 获得 WAIC 2026 SAIL 奖
- SAIL 奖是 WAIC 最高奖项
- Atlas 950 SuperPoD 被评为国产算力分水岭产品
- 首次在系统级超越海外同类方案
- 代表中国 AI 算力从"追赶"到"并跑"
华工科技:800G LPO 光模块独家供应商
根据 WAIC 现场展示的光模块追溯码(HSC 036FLQNMS4100662)和序列号前缀(341B0451),确认 Atlas 950 SuperPoD 使用的 StarMatrix 800G LPO 光模块由华工科技(子公司华工正源)独家代工。华工正源是华为 OPEN NPO/LPO 技术路线的联合发起方和唯一批量交付供应商。
LPO(Linear-drive Pluggable Optics,线性直驱可插拔光学器件)是华为 Hi-ONE 全光互联架构的核心技术,相比传统 DSP 光模块:
- 功耗降低 ~50%:去除 DSP 芯片,单模块功耗从 ~15W 降至 ~8W
- 延迟降低 ~30%:光-电-光直通,无 DSP 处理延迟
- 成本降低 ~40%:减少高端 DSP 芯片采购成本
- 可靠性提升:器件数量减少,故障点更少
注:LPO 技术适用于数据中心内部短距离(< 500m)互联场景,Atlas 950 SuperPoD 的柜间距离完全满足。
2.6 LightCounting WAIC 2026 深度分析:全光互联架构详解
光通信行业权威研究机构 LightCounting 在 WAIC 2026 现场对 Atlas 950 SuperPoD 进行了深度技术分析,发表了题为《Atlas 950 SuperPoD: Achieves All-Optical Interconnection with Superior Cost and Power Efficiency》的专业报告。以下是报告核心内容:
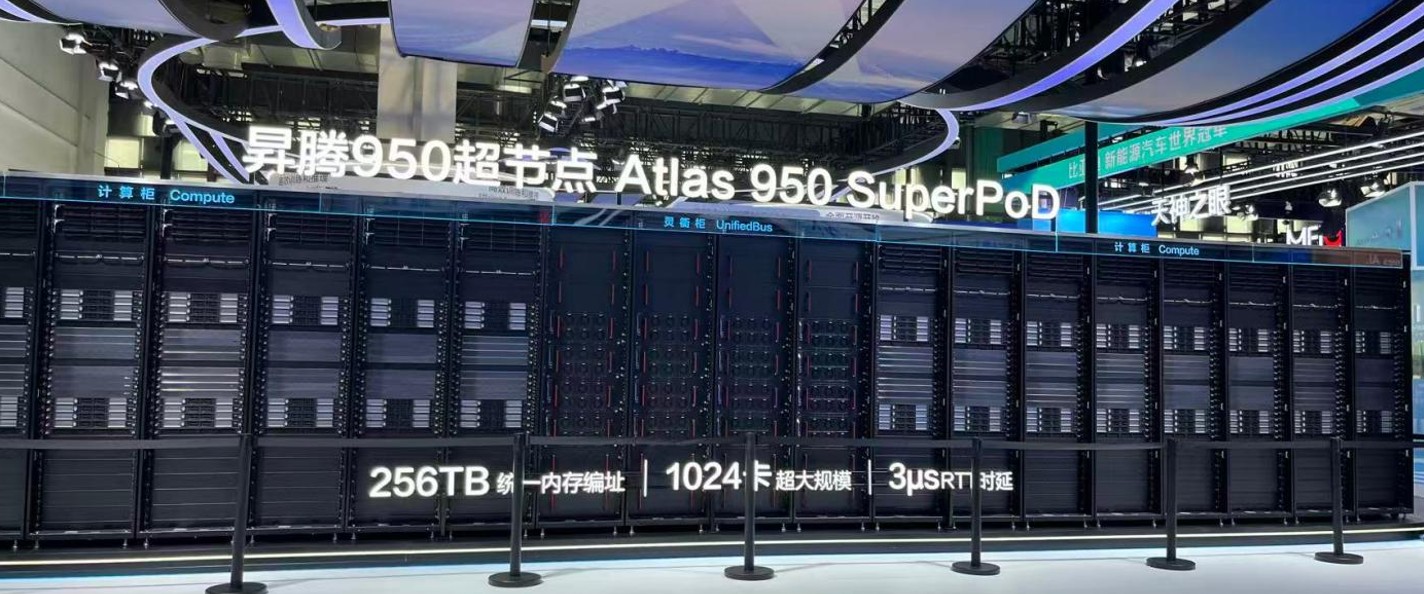
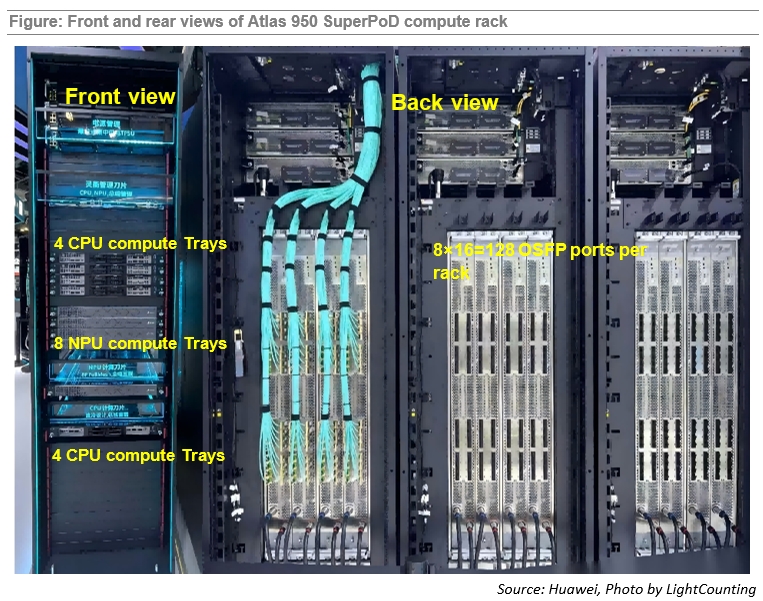
LightCounting 分析:三层混合互联架构
Atlas 950 SuperPoD 采用铜缆 + 光纤混合互联架构,根据不同层级的距离和带宽需求选择最优方案:
第一层:计算托盘内(8 NPU)
- 互联方式:高速电互联(PCB 走线 + 铜线)
- 拓扑结构:全网状(Full Mesh)
- 优势:短距离(< 30cm),低成本,低延迟
第二层:机柜内(8 托盘,64 NPU)
- 互联方式:正交电互联背板
- 拓扑结构:Clos 拓扑
- 创新点:零线缆设计,托盘垂直插入即自动连接
- 优势:免工具插拔,部署维护效率提升 70%
第三层:跨机柜(16 计算柜 + 4 交换柜,1024 NPU)
- 互联方式:800G 光模块 + 光纤
- 拓扑结构:全局 Clos 拓扑
- 模块配置:每个计算柜 128 个 800G OSFP 模块(8 列排布)
- 总计:1024 NPU 系统需要 4096 个 800G 光模块
- NPU 侧配置:平均每颗 NPU 关联 4 个 800G OSFP 模块
与上一代 CloudMatrix 384 的对比演进
LightCounting 详细对比了 2025 年发布的 CloudMatrix 384(昇腾 384 超节点)和 2026 年的 Atlas 950 SuperPoD:
| 对比项 | CloudMatrix 384 (2025) | Atlas 950 SuperPoD (2026) | 改进说明 |
|---|---|---|---|
| NPU 芯片 | Ascend 910C | Ascend 950DT | 新一代架构 |
| 系统规模 | 384 NPU | 1024 NPU (展示配置) 8192 NPU (满配) |
规模扩大 2.67 倍 / 21 倍 |
| 机柜配置 | 12 计算柜 + 4 交换柜 每柜 32 NPU (4节点×8) |
16 计算柜 + 4 交换柜 每柜 64 NPU (8托盘×8) |
单柜密度翻倍 |
| 光模块配置 | 256 个 QSFP-DD (400G) 4 列垂直排布 每 NPU 8×400G |
128 个 OSFP (800G) 8 列排布 每 NPU 2×800G |
单模块带宽翻倍 数量减半,布局优化 |
| NPU 互联带宽 | 392 GB/s (单向) | 2 TB/s (双向) | 带宽提升 5 倍 |
| 统一内存空间 | 48 TB | 256 TB (1024 卡) 1152 TB (8192 卡满配) |
容量提升 5.3 倍 / 24 倍 |
| 端到端延迟 | ~10 μs | ~3 μs | 延迟降低 70% |
| 光模块技术 | 传统 DSP 方案 | LPO 方案(首个) | 功耗降低 50%,成本降低 40% |
| 机柜布局 | 常规节点式 | 紧凑托盘式 | 空间利用率提升 |
LightCounting 技术评价:三大突破
1. 首个 LPO 超节点
Atlas 950 SuperPoD 是全球首个采用 LPO 光模块的超节点设计。基于华为 100G VCSEL 技术和光电协同设计能力,相比传统 DSP 方案在成本、延迟和功耗上实现三重优化。
2. 正交背板创新
前部计算托盘与后部背板垂直插接,实现零线缆电互联。托盘可免工具快速插拔,部署和维护效率大幅提升,是数据中心工程设计的重大创新。
3. 紧凑机柜设计
采用更紧凑的机柜布局,单柜从 32 NPU 提升至 64 NPU,密度翻倍。配合优化的光模块布局(8 列 vs 4 列),空间利用率和散热效率均显著提升。
系统性能指标(1024 NPU 展示配置)
- 峰值算力:1 EFLOPS (FP8) / 2 EFLOPS (FP4)
- 统一内存:256 TB 全局地址编址空间
- 互联带宽:TB 级 NPU 间带宽
- 端到端延迟:低至 3 μs RTT
- 光模块总数:4096 个 800G OSFP (LPO)
- 计算柜:16 个,每柜 64 NPU
- 交换柜:4 个中央 UB 交换柜
- 拓扑架构:Mesh (托盘内) + Clos (全局)
来源:LightCounting Research Note, "July 2026 Atlas 950 SuperPoD: Achieves All-Optical Interconnection with Superior Cost and Power Efficiency", by Carol Cao, July 21, 2026
2.4 机柜架构与全光互联
Atlas 950 SuperPoD 以 64 NPU/计算柜 为基础单元,满配由 128 个计算柜 + 32 个通信柜 构成,总计 160 机柜,占地约 1000 平方米。
机柜工程创新
- 正交盲插设计:前部计算托盘与后部背板垂直插接,实现零线缆电互联,降低插拔复杂度、信号干扰和维护难度。
- 800G LPO 光模块:采用 Linear-drive Pluggable Optics 方案,相比传统光模块降低功耗、成本和延迟。单个 1024 卡展示系统使用 4096 个 800G 光模块。
- 液冷高密部署:浮动盲插液冷接头,降低漏液风险;液冷直接带走芯片热量,支持更高功率密度,降低数据中心 PUE。
- UB-Mesh 互联拓扑:通过通信柜中的 UnifiedBus 光交换矩阵,实现计算柜间的全互联,支持 64 NPU 为步长的递归扩展,最大 8192 NPU 无收敛互联。
- 100ns 级故障检测:从物理层到网络层的多层可靠性设计,支持光路百纳秒级故障检测和保护倒换,对应用层尽量无感。
第三章 Atlas 950 超节点核心技术深度拆解(扩充版)
Atlas 950 SuperPoD 的技术路线可以概括为:在单芯片先进制程受限、单卡性能难以完全依赖摩尔定律推进的情况下,用“芯片 + HBM + 总线级互联 + 统一内存 + 编译器/通信库 + 算法切分”共同提升系统级有效算力。因此,第三章不只看芯片参数,而要看它为什么这样设计、每一层解决什么瓶颈,以及软件和算法如何把硬件能力真正用起来。
3.1 为什么要做超节点:从“网络连接服务器”转向“总线级连接资源”
问题根源:大模型训练和推理的瓶颈已经从“单卡算力够不够”扩展到“数千张卡能否像一台机器一样协同”。传统 Scale-out 集群用以太网/RoCE/IB 把服务器连起来,适合横向扩展,但对 MoE All-to-All、张量并行、长上下文 KV Cache 这类强同步、高频通信任务,会产生协议栈、交换层级、数据副本和尾延迟开销。
华为这样做的原因:华为在 HC2025 官方演讲中明确提到,在无法完全依赖最先进制程节点的现实条件下,需要通过连接更多计算资源来满足算力需求。SuperPoD 的目标是让 10,000+ NPU “work like a computer”。因此 Atlas 950 的技术重点不是单卡孤立性能,而是让更多 NPU 以更低时延、更高带宽和统一资源视图协同。
亮点:华为把超节点定义为“单一逻辑机器”,并提出六个关键特征:bus-grade interconnect(总线级互联)、peer-to-peer coordination(点对点协同)、all-resource pooling(全资源池化)、unified protocol(统一协议)、large-scale networking(大规模组网)、high availability(高可用)。这使 Atlas 950 更接近“系统架构创新”而不是“服务器堆叠”。
3.2 芯片与存储:Ascend 950DT 为什么强调 HiZQ 2.0、低精度和互联带宽
3.2.1 950PR 与 950DT 的任务分工
公开资料显示,Ascend 950 系列采用同一代 950 Die,但根据不同负载封装为 950PR 与 950DT:950PR 面向推理 Prefill 与推荐系统,强调性价比和大块计算;950DT 面向 Decode 推理和训练,强调内存容量、访存带宽和互联带宽。这样做的原因是 LLM 推理两个阶段的资源需求完全不同:Prefill 阶段一次性处理长输入,算力密集;Decode 阶段逐 token 生成,访存和 KV Cache 访问更敏感。
3.2.2 HiZQ 2.0 HBM:为 Decode 和训练补带宽短板
华为官方演讲披露,Ascend 950DT 使用 HiZQ 2.0 HBM,容量 144GB、内存访问带宽 4TB/s,芯片总互联带宽 2TB/s。为什么要这样做?因为长上下文推理和大模型训练常常是 memory-bound:每生成一个 token 都要访问大量权重和 KV Cache,访存带宽不足会让计算单元等待。HBM 靠近计算芯片,能缩短信号路径、降低数据搬运能耗,并提升高带宽访问能力。
3.2.3 低精度格式:用 FP8/FP4/MXFP8/HiF8 降低带宽和内存压力
Ascend 950DT 支持 FP8、MXFP8、MXFP4、HiF8 等格式。低精度不是简单“牺牲精度换速度”,而是大模型训练/推理的系统工程:更低 bit 宽可降低 HBM 占用、提升有效缓存容量、降低互联传输量,并提高矩阵计算吞吐。HiF8 等自研格式的意义在于尝试在低精度效率和模型收敛/推理精度之间取得平衡。
3.2.4 计算核心与访存颗粒度:具体做了什么
围绕 Ascend 950 的架构报道提到几项关键变化:支持 SIMD/SIMT 双模式,提升规则向量任务与不规则并行任务的编程适配;提升 Vector 算力并增加 Cube-Vector 融合通路,改善归一化、激活函数、稀疏/碎片算子等非纯矩阵任务;将内存访问颗粒度从 512B 优化到 128B Sector-Cache,减少离散访问浪费;支持 NDDMA 高效数据访问,提升数据搬运效率。这些工作都是为了让芯片更适配 LLM 中“矩阵计算 + 大量非矩阵算子 + 不连续内存访问”的混合负载。
3.3 UnifiedBus/灵衢 2.0:亮点不只是带宽,而是把网络语义变成内存/总线语义
UnifiedBus 的关键价值在于弥合“总线”和“网络”的矛盾:总线低时延、支持共享地址,但距离短、规模小;网络可扩展,但协议栈重、延迟高。Atlas 950 试图通过 UB2.0 在跨机柜规模实现接近总线的资源访问和通信语义。
3.3.1 UB-Mesh 与全光互联:为什么要做全光
在机柜内部,铜互联可提供很低时延,但距离受限、线缆复杂;跨机柜时,光互联具有距离长、带宽高、抗干扰和布线密度优势。华为官方 SuperPoD architecture 页面称 Atlas 950 采用 UB-Mesh 递归直连拓扑,支持单板内、板间、机架间 NPU 全互联,以 64 NPU 为步长扩展,最高支持 8192 NPU 无收敛互联。LightCounting 对 WAIC 展示系统的拆解还提到:1024 NPU 展示形态包含 16 个计算柜和 4 个中心 UB 交换柜,使用 800G 光模块,采用 LPO(Linear-drive Pluggable Optics)以降低成本、时延和功耗。
3.3.2 可靠性:光路百纳秒级故障检测的意义
万卡级集群的难点不是“正常时跑得快”,而是“异常时不拖垮全局”。华为公开材料强调从物理层、链路层到网络/传输层构建可靠性,并提到 100ns 级故障检测和保护倒换,使光模块瞬时故障对应用层尽量无感。对长周期训练而言,故障检测、隔离、重路由和恢复效率直接决定训练成本。
3.3.3 UBoE 与 RoCE:为什么还要兼容以太网
Atlas 950 SuperCluster 层面支持 UBoE 和 RoCE。UBoE 可理解为 UnifiedBus over Ethernet,让客户复用既有以太网交换设备,同时获得比传统 RoCE 更低静态时延和更高可靠性的目标收益。这样做的商业意义是降低从单个 SuperPoD 扩展到 SuperCluster 的改造门槛。
3.4 全域统一内存编址:为 MoE 和长上下文解决“数据在哪里”的问题
传统多卡训练中,每张卡有自己的 HBM,模型参数、激活、KV Cache 在不同设备间复制和搬运。随着上下文长度和 MoE 专家数量增加,数据搬运可能比计算更耗时。统一内存编址要解决的不是“内存变大”这么简单,而是让跨设备数据访问从网络消息转向更接近内存语义。
MoE、长上下文和 Agent 负载把瓶颈从算力推向“数据在哪里、怎么搬、搬几次”。统一编址降低跨卡数据管理复杂度。
把参数、激活和 KV Cache 放入统一地址管理框架,通过灵衢内存语义减少传统网络报文式搬运。
统一内存不代表所有内存访问速度一样,也不等于无限显存;热/冷数据仍需要运行时和算法策略分级放置。
统一内存带来的三类直接收益
- 更大的“有效显存”:统一地址空间使系统可以把多张 NPU 的 HBM、节点内存或分级内存资源作为统一资源池来调度。对大模型而言,这等价于突破单卡 HBM 容量墙,使更大参数模型、更多专家参数或更长 KV Cache 有机会被加载和管理。需要注意的是,这并不意味着远端内存和本地 HBM 一样快,而是让系统可以把热数据放近、冷数据放远。
- 减少 CPU/加速器、主机内存/显存之间的数据拷贝:传统 CPU+GPU/NPU 架构中,数据经常需要在系统内存和显存之间显式搬运。统一内存/统一编址的目标,是让参数、激活、KV Cache 等数据在同一地址体系下被访问和迁移,减少“打包、拷贝、同步、解包”的重复开销,从而提升训练和推理效率。
- 编程、运维和调试更简单:在 NVIDIA CUDA 语境中,Unified Memory 让开发者少写甚至不写
cudaMemcpy、cudaHostAlloc、cudaMemAdvise等显式内存管理代码,一个托管指针可在 CPU/GPU 侧访问。类比到 Atlas 950,目标是通过 CANN、UB OS Component 和灵衢内存语义,减少开发者对“数据此刻在哪张卡、哪块内存”的显式管理,让模型并行、缓存管理、故障恢复和运维调试更自动化。
3.4.1 具体做了什么
- 统一地址空间:跨芯片、跨节点内存/显存统一寻址,应用和运行时可按统一“门牌号”管理参数、激活和 KV Cache。
- Load/Store 同步语义:公开材料提到 UB 支持 Load/Store 同步通信语义,让部分远程访问更接近内存读写,而不是传统网络报文。
- URMA 异步消息语义:对不适合同步 Load/Store 的通信,提供异步消息/远程内存访问能力,兼顾性能和灵活性。
- 内存池化与借用:通过跨设备借用、共享和分级缓存减少碎片化,提升大模型部署容量。
3.4.2 对算法的实际价值
MoE:专家路由会产生 All-to-All,统一内存可降低专家参数/激活在设备间的副本和迁移成本;长上下文:KV Cache 可做分级池化,减少重复加载;RL/Agent:多任务、多副本、多轮推理需要频繁上下文切换,共享内存可降低镜像拉取和缓存重建开销;多模态:高维输入和中间特征更依赖流水线并行与缓存复用。
3.4A 统一内存寻址概念核实:NVIDIA Vera/Rubin 与华为 Atlas 950 的异同
用户补充的“统一内存寻址”框架非常适合作为理解 Atlas 950 的参照:传统 CPU-GPU 系统中,CPU DDR/LPDDR 与 GPU HBM 是两套物理内存,依赖 PCIe 和显式拷贝;统一内存的方向,是让处理器共享一个地址空间,尽量减少数据搬运、提升可寻址容量和编程便利性。
但需要特别区分:NVIDIA Vera/Rubin 的统一内存主要是 CPU↔GPU coherent memory architecture;华为 Atlas 950 的统一内存编址主要是 SuperPoD 内多 NPU/HBM 资源的统一编址、内存语义通信和池化。
NVIDIA 更像“CPU 内存 + GPU 显存形成一致性池”;Atlas 950 更像“多 NPU/HBM 在超节点内形成统一地址域”。二者都减少搬运,但硬件一致性边界不同。
主要问题是显式拷贝、页迁移与同步成本,GPU 高效可用容量受本地 HBM 限制。
NVLink-C2C 提供 CPU↔GPU coherent bandwidth;NVLink 6 负责 GPU↔GPU rack-scale fabric。
灵衢/UB 支持内存语义,重点是 NPU 间统一编址、资源池化和 SuperPoD 级调度。
3.4A.1 传统 PCIe CPU + GPU:为什么会有“搬数据税”
传统方案中,CPU 系统内存与 GPU HBM 分离。CPU 准备数据后,GPU 计算前通常需要显式拷贝或托管内存页迁移;GPU 计算结果若由 CPU 处理,也要返回主机侧。痛点包括:数据拷贝占用带宽和延迟、CPU/GPU 指针语义不同、GPU 可直接高效访问的容量受 HBM 限制。CUDA Unified Memory 通过 cudaMallocManaged 提供单一托管地址空间,并支持 page migration、prefetch、oversubscription,但在不同代际和互联条件下,仍需要关注页故障、迁移开销和同步语义。
3.4A.2 NVIDIA Vera + Rubin:核实后的关键口径
NVIDIA 官方 Vera CPU 与 Rubin 平台资料显示:Vera CPU 采用第二代 SCF(Scalable Coherency Fabric),连接 88 个 Olympus CPU 核、缓存、内存、I/O 与 NVLink-C2C,SCF 双向剖分带宽为 3.4TB/s;Vera 搭配 LPDDR5X/SOCAMM,容量最高 1.5TB、带宽最高 1.2TB/s;Vera CPU 与 Rubin GPU 之间通过第二代 NVLink-C2C 提供最高 1.8TB/s coherent bandwidth,使 LPDDR5X 与 HBM4 可作为统一 CPU-GPU 地址空间使用,适合 KV cache offload、多模型执行和 Agentic AI 编排。
需要修正的是:用户材料中提到“NVLink 6 + SCF 2.0 形成统一内存寻址、CPU↔GPU 5TB/s 双向”这一说法不完全准确。公开官方口径中,NVLink 6 主要是 Rubin GPU↔GPU 的 rack-scale scale-up fabric,每 GPU 双向带宽 3.6TB/s,NVL72 机架总 GPU 带宽 260TB/s;CPU↔GPU coherent 连接是 NVLink-C2C,官方口径为 1.8TB/s。因此,在报告中应把“GPU-GPU all-to-all fabric”和“CPU-GPU coherent memory link”分开表述。
3.4A.3 华为 Atlas 950:统一内存编址更接近“NPU/HBM 池化 + 内存语义通信”
Atlas 950 的公开资料强调“统一内存编址”和“内存语义”。Ascend 社区页面对 1024 NPU 形态给出 256TB unified global memory addressing & memory semantics;华为 HC2025 对 8192 颗 950DT 满配 SuperPoD 给出 8 EFLOPS FP8、16 EFLOPS FP4、16PB/s 互联带宽等指标。若按 950DT 单芯片 144GB HBM 估算,8192 卡理论 HBM 容量约 1152TB。这里的关键不是 CPU 把 LPDDR 作为 GPU 的溢出显存,而是把多 NPU 的 HBM/系统资源通过灵衢协议组织成统一可编址、可调度、可池化的 SuperPoD 内存域。
3.4A.4 对 MoE、KV Cache 和 Agent 的实际意义
- MoE:专家路由造成 All-to-All,统一地址空间和高带宽互联可减少专家参数和激活的副本搬运。
- 长上下文 KV Cache:NVIDIA 方案可把冷 KV cache offload 到 Vera LPDDR5X;华为方案则强调 SuperPoD 内 NPU/HBM 统一编址和分级池化,减少跨卡重复加载。
- Agentic AI:多 Agent 共享对话历史、工具状态、检索缓存,统一内存/内存语义可降低状态复制与同步成本。
- 编程模型:NVIDIA 依托 CUDA Unified Memory、NVSHMEM、NCCL、TensorRT-LLM 等生态较成熟;华为需要通过 CANN、UB OS Component、MindSpore/PyTorch/vLLM/SGLang/Triton 适配把统一内存能力暴露给开发者。
3.4A.5 三类方案对比表
| 维度 | 传统 PCIe CPU+GPU | NVIDIA Vera + Rubin | 华为 Atlas 950 SuperPoD |
|---|---|---|---|
| 核心目标 | CPU 控制、GPU 加速,内存分离 | CPU-GPU coherent unified memory,支撑 KV cache offload 和 Agent 编排 | SuperPoD 内多 NPU/HBM 统一编址、池化与内存语义通信 |
| 关键互联 | PCIe | NVLink-C2C:CPU↔GPU coherent 1.8TB/s;NVLink 6:GPU↔GPU 3.6TB/s/GPU | UnifiedBus/灵衢 2.0,官方口径 16PB/s 级 SuperPoD 互联 |
| 一致性/语义 | 显式拷贝或 CUDA 托管内存迁移,同步需谨慎 | CPU-GPU coherent bandwidth 与统一 CPU-GPU 地址空间;GPU-GPU rack fabric 主要靠软件同步/NCCL/NVSHMEM 等 | Load/Store 同步语义 + URMA 异步消息语义;强调 NPU 间统一内存编址与资源池化 |
| 容量扩展 | GPU 高效访问主要受 HBM 限制 | HBM4 + Vera LPDDR5X 形成 coherent pool,用于 KV cache offload 等 | 1024 卡展示形态 256TB;8192 卡理论 HBM 容量约 1152TB(需以正式 datasheet 为准) |
| 成熟度 | 成熟通用,但高端 AI 搬运成本高 | NVIDIA CUDA/NCCL/TensorRT-LLM 生态成熟;Vera/Rubin 为路线图/新平台 | 架构创新强,生态与满配长期稳定运行仍需验证 |
3.5 整机工艺与液冷工程:让 64 卡/柜、1024 卡/域、8192 卡/系统可交付
超节点不是只靠芯片和协议,整机工艺决定了它能否稳定商用。华为官方 SuperPoD architecture 页面提到 Atlas 950 在组件、协议、算法、光电技术上做系统级创新,使用正交架构实现零线缆电互联,采用液冷接头浮动盲插设计降低漏液风险,并通过材料和工艺提升液冷光模块可靠性。
3.5.1 正交盲插与零线缆电互联
在高密服务器中,线缆不仅占空间,还带来插拔、散热、信号完整性和维护问题。正交架构把前部计算托盘与后部互联/背板垂直插接,减少线缆,提升信号一致性与维护效率。LightCounting 对 WAIC 展示机的观察也提到 Atlas 950 计算柜采用前托盘与后插板之间的正交电互联。
3.5.2 液冷与光模块可靠性
高密 NPU 机柜功耗巨大,风冷难以经济承载。液冷可把热直接从芯片/板级组件带走,降低机房 PUE;但液冷引入漏液、维护和光电器件可靠性问题。因此浮动盲插液冷接头、液冷光模块材料工艺、监测与故障隔离成为工程亮点。
3.5.3 LPO/光电协同的价值
LightCounting 报告称 WAIC 展示系统采用 800G 光模块与 LPO 方案。LPO 通过减少 DSP 等有源处理环节,目标是降低光模块功耗、成本和延迟。对 1024/8192 卡级系统,光模块数量巨大,单模块功耗和成本的微小优化都会放大为显著系统收益。
3.6 软件栈:CANN、UB OS Component 与开源适配做了哪些工作
硬件互联和统一内存只有被软件栈抽象出来,开发者才能使用。华为 MWC 公开资料称 CANN 通过分层解耦开源,包括算子库、加速库、图引擎和编程语言,并支持 PyTorch、vLLM、SGLang、xLLM、verl、Triton、TileLang 等开源项目,以提升开发效率。华为官方 SuperPoD architecture 页面还提到 UB OS Component 开源,可集成到 openEuler 等开源 OS 社区,用于支持灵衢硬件的内存管理、通信、设备管理和虚拟化。
3.6.1 CANN 层具体工作
- 算子库与加速库:针对 Cube/Vector 融合算子、低精度 GEMM、Attention、MoE All-to-All 等热点算子做优化。
- 图引擎:进行图级融合、内存复用、算子重排和通信计算重叠。
- 编译器与虚拟指令接口:向上屏蔽 NPU 差异,让框架可生成适配低精度、统一内存和通信语义的执行计划。
- 通信库:利用 UB 集合通信硬化加速单元,优化 AllReduce、AllGather、ReduceScatter、All-to-All。
3.6.2 UB OS Component 与系统软件
UB OS Component 的作用是让操作系统认识并管理灵衢硬件:统一硬件抽象、统一内存地址空间管理、资源全局调度、计算资源动态组合、设备间高性能通信、虚拟化和池化。对云服务商和智算中心而言,这一层决定了超节点能否被纳入资源调度、租户隔离、故障监控和运维体系。
3.7 算法侧适配:不是把模型搬上去,而是重写并行和缓存策略
Atlas 950 的硬件能力要转化为业务吞吐,需要算法侧做适配。关键不是“模型能不能跑”,而是“跑得是否高效”。
| 算法/负载 | 瓶颈 | Atlas 950 相关优化方向 |
|---|---|---|
| MoE 训练 | 专家路由 All-to-All 通信量大,负载不均衡 | 利用 UB 低时延和高带宽优化 All-to-All;专家分片与路由重排;跨设备内存池降低专家副本。 |
| 长上下文推理 | KV Cache 容量与访存带宽瓶颈 | KV Cache 分级池化、统一内存编址、Decode 阶段使用 950DT 高带宽 HBM。 |
| Prefill/Decode 分离 | 两个阶段资源需求不同,单一硬件配置浪费 | Prefill 偏算力、Decode 偏带宽,用 950PR/950DT 或资源池进行异构调度。 |
| 低精度训练/推理 | 显存、带宽、吞吐与精度之间权衡 | FP8/MXFP8/HiF8/MXFP4 混合精度;校准、缩放、误差补偿与关键层保精度。 |
| 多模态训练 | 输入大、流水线长、数据预处理与通信重叠难 | 流水并行、异步数据预取、NDDMA、统一缓存和通信计算重叠。 |
亮点:Atlas 950 的算法适配方向是把硬件的统一内存和低时延互联转化为新的并行策略,而不是沿用传统 GPU 集群的切分方式。后续评估应重点看 MoE 的 All-to-All 效率、长上下文 Decode TPS、KV Cache 命中率、低精度精度损失和故障恢复后的训练收敛。
3.8 仍需验证的问题
- 满配 8192 卡与 WAIC 1024 卡展示口径不同:1024 卡展示系统已有较多媒体拆解,8192 卡满配仍需正式 datasheet 与客户实测。
- 统一内存不是无限快:远端访存仍有延迟,缓存一致性、热点争用和尾延迟可能影响不规则模型。
- 低精度需要算法配合:FP4/FP8 的收益取决于量化策略、校准、关键层保精度和框架支持。
- 生态迁移是硬成本:即便 CANN 开源并适配主流框架,CUDA 生态迁移仍涉及算子、调试、性能剖析和人才培训。
第四章 场景适配、业务价值与 TCO
4.1 高适配场景
- 通用基础大模型预训练:尤其是高并行度、长训练周期任务。
- MoE 混合专家模型:专家路由和 All-to-All 通信对互联性能敏感。
- Agent 长上下文推理:KV Cache 共享、低时延 Decode、并发调度是关键。
- 国家级/区域级智算中心:需要国产化、可控供应与政策协同。
4.2 中性/不适用场景
| 场景 | 适配度 | 原因 | 替代建议 |
|---|---|---|---|
| 行业模型微调 | 中 | 若模型规模有限,超节点资源可能过重。 | 中小规模集群或云上弹性资源。 |
| AIGC 推理 | 中 | 取决于并发、上下文长度与模型类型。 | 按吞吐/时延核算,必要时使用 Atlas 850E 等。 |
| 小规模推理/边缘 AI | 低 | 液冷、机房与运维门槛远高于业务需求。 | 风冷推理服务器、边缘盒子、云服务。 |
4.3 TCO 测算框架
TCO 不应只看硬件采购价,而应拆为:AI 服务器与互联柜、液冷与供配电改造、光模块/光纤、软件迁移、调优人力、运维备件、能耗与 PUE、故障恢复损失。Atlas 950 的经济性成立条件是:更高算力利用率与国产供应可获得性,足以抵消生态迁移和机房改造成本。
第五章 竞品横向对比
| 维度 | 华为 Atlas 950 SuperPoD | NVIDIA NVL/DGX/SuperPOD 路线 | 解读 |
|---|---|---|---|
| 战略焦点 | 系统级互联与统一内存,国产化全栈 | 单卡性能 + NVLink/NVSwitch + CUDA生态 | 华为以系统弥补单芯片与生态差距;NVIDIA 生态粘性仍强。 |
| 规模口径 | 最多 8192 Ascend 950DT | NVL144/NVL576 等路线图 | 卡数不可直接等同有效性能,需看 MFU、通信效率和软件栈。 |
| 软件生态 | CANN、MindSpore、昇腾开源社区,适配 PyTorch 等仍需投入 | CUDA、cuDNN、NCCL、TensorRT、vLLM 等成熟生态 | 生态是 Atlas 950 商业落地最大变量之一。 |
| 供应链 | 面向国内自主可控,受国产 HBM/封装/产能制约 | 先进制程与 HBM 供应强,但受出口管制影响中国市场 | 中国客户实际选择取决于可获得性与政策环境。 |
| 客户画像 | 智算中心、运营商、央国企、头部模型公司 | 全球云厂商、AI Lab、企业客户 | 地缘与生态导致市场分层。 |
SWOT
- 国产软硬件栈与政策适配
- UnifiedBus 与统一内存编址具系统创新
- 满配规模大,面向万卡级智算中心
- CUDA 生态迁移成本高
- 大规模稳定运行公开实测不足
- 单芯片绝对性能与先进制程仍有压力
- 国产智算中心建设需求
- AI 供应链安全与自主可控
- 光互联、液冷、国产框架生态增量
- NVIDIA/AMD 等海外路线持续迭代
- 国内多厂商超节点路线竞争
- 高 CapEx 与客户预算周期不确定
第六章 产业链拆解
6.1 上游:高弹性环节
若 8192 卡级超节点进入规模建设,增量不仅来自 NPU,还来自高速光模块、光连接器、SerDes、交换/互联芯片、高层 PCB、HBM、先进封装、液冷冷板/泵/介质和电源模块。尤其是全光互联与液冷基础设施,可能成为超节点从样机走向规模交付的关键供给约束。
6.2 中游:整机与集成
中游包括华为 Atlas 整机、互联柜、液冷数据中心集成、CANN/通信库、集群调度、故障自愈与运维平台。商业化能力取决于是否能把复杂工程产品变成可复制交付方案。
6.3 下游:需求市场
下游主要是国家/地方智算中心、运营商算力网络、头部互联网与模型企业、金融/能源/制造/科研等行业 AI 平台。对这些客户而言,Atlas 950 的吸引力通常来自三点:国产化、安全可控、在超大模型任务中的系统级效率。
第七章 商业化进展、生态布局与市场空间
7.1 商业化时间表
- 2025:Atlas 900 A3/384 卡超节点验证与商用铺垫;HC2025 发布 UB2.0 与 Atlas 950/960 路线图。
- 2026 H1:950PR 与 MWC 海外展示;WAIC 展示 1024 卡 950 超节点真机。
- 2026 Q4:官方规划 Atlas 950 SuperPoD 与 950DT 上市/可用;SuperCluster 同期进入市场。
- 2027–2028:Atlas 960/Ascend 970 路线推进,超节点规模继续扩大。
7.2 生态策略
华为强调开放 UnifiedBus 2.0 技术规范,以及 CANN、MindSpore/昇腾社区开源开放。对客户而言,生态的关键不是“是否开源”本身,而是 PyTorch/vLLM/Megatron/DeepSpeed 等主流训练推理栈的真实适配质量、算子覆盖、调试工具、人才供给和迁移案例。
7.3 市场空间测算思路
由于 Atlas 950 尚未规模交付,本报告不作精确销售预测。更合理的测算方式是以“智算中心新增高端国产算力预算 × 国产化渗透率 × 超节点占比 × 单套平均配置”建立情景模型。保守情景下,Atlas 950 主要进入国家级/头部客户;乐观情景下,若生态迁移与液冷改造形成标准化交付,运营商与区域智算中心会成为规模采购主体。
第八章 风险与不确定性
8.1 技术验证风险
- 8192 卡长期稳定运行、故障隔离、训练恢复和跨机柜光互联可靠性仍需公开案例验证。
- 统一内存编址对真实 MoE/长上下文任务的收益取决于编译器、通信库和模型切分策略。
- 媒体披露的 1152TB、16.3PB/s、3μs 等细节需要与最终产品 datasheet 对齐。
8.2 商业落地风险
- 一次性采购与液冷机房改造门槛高,存量 IDC 难以快速承接。
- 客户若已有 CUDA 训练栈,迁移成本可能超过硬件成本节约。
- 国产 HBM、封装、光模块供应与良率可能影响交付节奏。
8.3 外部环境风险
出口管制可能一方面强化国内替代需求,另一方面限制上游制造与关键材料供应。国内多家 GPU/NPU 厂商也在发布超节点方案,竞争会压缩溢价并加速标准战。
第九章 发展趋势研判
- 系统互联成为 AI 算力竞争主战场:单芯片峰值提升放缓后,互联拓扑、内存语义、可靠性和软件栈决定有效算力。
- 超节点会分层:液冷万卡级面向国家/头部客户,风冷/中小规模超节点面向企业推理与行业模型。
- 灵衢能否成为标准取决于伙伴生态:开放规范只是第一步,光模块、交换、服务器、软件框架和测试认证体系才是标准化核心。
- 国产大模型训练底座将更自主:即使与全球最成熟生态仍有差距,政策与供应链安全会推动国产超节点进入关键基础设施。
第十章 结论与建议
10.1 核心结论
Atlas 950 SuperPoD 是华为从“芯片产品”转向“AI 基础设施系统工程”的标志性产品。它的核心价值在于通过 UnifiedBus/灵衢 2.0、全光互联和统一内存编址,把大规模 NPU 资源组织成更紧耦合的计算域,以应对 MoE、长上下文和 Agentic AI 的通信/内存瓶颈。
10.2 分主体建议
- 算力采购方:不要只看 EFLOPS 和卡数,应以自有模型做 PoC,重点测试 MFU、长上下文吞吐、故障恢复、框架迁移和运维成本。
- 产业链厂商:关注光互联、液冷、电源、高层 PCB、集群运维软件等高弹性环节;提前适配 UnifiedBus 生态。
- 算法企业:提前建立 CANN/昇腾迁移能力,优化 MoE 路由、KV Cache、低精度训练/推理和通信重叠。
- 投资/产业观察者:跟踪 2026 Q4 实际订单、客户试点、稳定运行数据、UB2.0 伙伴数量与开源社区活跃度。
附录:术语与参数
| 术语 | 解释 |
|---|---|
| SuperPoD/超节点 | 由多个物理服务器/机柜组成,但在互联、内存和调度上尽量表现为单一逻辑计算机的系统。 |
| UnifiedBus/灵衢 | 华为面向超节点的互联协议,目标是提供高带宽、低时延和统一内存语义;UB2.0 面向 Atlas 950/960。 |
| 统一内存编址 | 跨物理节点形成统一地址空间,减少数据搬运与软件协议栈开销。 |
| MoE | Mixture of Experts,混合专家模型;只激活部分专家,通信模式更复杂。 |
| FP4/FP8/MXFP8/HiF8 | 低精度数据格式,用于提高 AI 训练/推理吞吐并降低内存与带宽压力。 |
补充版:华为 Atlas 950 超节点(SuperPoD)技术、产业与商业化全景深度分析报告
执行摘要
随着 Agent 智能体、十万亿参数 MoE 混合专家大模型、超长上下文推理成为 AI 产业主流演进方向,传统分布式算力集群存在显存孤岛、通信时延高、算力利用率低、数据搬运开销大等核心痛点,现有算力基础设施已难以满足下一代大模型训练与超高并发推理需求。在此背景下,华为推出 Atlas 950 SuperPoD(950 超节点),定位国产万卡级旗舰 AI 算力底座,是华为继 Atlas 900 超节点之后面向超大规模 AI 计算的架构级革新产品,官方规划 2026 年第四季度商用/可用。
本补充正文基于华为 HC2025、MWC2026、WAIC2026 公开资料、Ascend 社区页面及产业报道,从行业背景、硬件架构、核心技术、性能场景、竞品对比、产业链、商业化、风险挑战、趋势研判等维度,对 Atlas 950 超节点进行全景拆解。核心结论是:Atlas 950 超节点依托自研灵衢 2.0(UnifiedBus 2.0)全光互联与全域统一内存编址能力,试图打破传统集群算力、显存、互联资源壁垒;满配 8192 卡口径下,公开资料给出 8 EFLOPS FP8、16 EFLOPS FP4、16PB/s 级互联带宽、160 机柜、约 1000㎡、训练性能较 Atlas 900 A3 提升 17 倍、推理性能提升 26.5 倍等关键指标。
核心关键指标速览
- 最大支持:8192 颗/张 Ascend 950DT NPU
- 基础单元:单柜 64 卡
- 满配机柜:128 计算柜 + 32 通信柜,共 160 柜
- 部署面积:约 1000㎡
- FP8 算力:8 EFLOPS
- FP4 算力:16 EFLOPS
- 互联带宽:16PB/s 级,媒体报道亦有 16.3PB/s
- RTT 时延:WAIC/媒体口径多称低至 3μs
- 全局统一内存:1024 卡展示形态常见 256TB;8192 卡满配可推算 1152TB 理论容量
- 性能提升:训练 17 倍、推理 26.5 倍(相对 Atlas 900 A3 公开口径)
第一章 行业背景与算力架构变革
1.1 当前 AI 算力基础设施核心痛点
AI 产业已进入“超大模型、超长上下文、超高并发”阶段。千亿、万亿参数稠密模型和十万亿参数 MoE 模型持续演进,Agent 应用推动上下文长度向百万 Token 级别延伸,传统集群架构的局限性全面显现。
- 显存孤岛:传统单卡独立显存导致跨卡、跨节点频繁搬运数据,显存难以统一调度,资源闲置与碎片化严重。
- 通信瓶颈:以太网、RoCE、InfiniBand 等 Scale-out 架构在大规模同步训练下容易出现层级转发、拥塞和尾延迟问题。
- 算力利用率不足:大模型并行训练中,通信等待、数据复制、故障恢复和调度开销会显著侵蚀有效算力。
- 供应链安全:海外高端 AI 芯片和互联技术受出口管制影响,国内高端 AI 算力底座存在自主可控诉求。
1.2 超节点定义与架构特征
AI 超节点区别于传统 Scale-out 分布式集群,是一种更偏 Scale-up 的融合算力架构,目标是实现“物理多机、逻辑单机”。华为公开资料强调超节点的三大核心特征:超大无损互联带宽、超低通信时延、全域统一内存编址。
1.3 全球算力基础设施路线
海外路线以 NVIDIA 为代表,依托 NVLink/NVSwitch、DGX/NVL、CUDA 生态形成端到端壁垒;国内路线以华为昇腾超节点为代表,强调自研 NPU、灵衢互联、统一内存架构与 CANN/MindSpore 软件栈,核心优势是自主可控与系统级架构创新,短板是软件生态和开发者惯性仍需时间沉淀。
1.4 华为超节点产品谱系
华为已形成 Atlas 900 A3/384 卡超节点、Atlas 950 SuperPoD、Atlas 960 规划,以及 Atlas 850E 风冷超节点、TaiShan 950 通算超节点等产品矩阵。Atlas 850E 更适合企业级风冷机房与中小规模推理;Atlas 950 面向液冷、万卡级、国家级/头部客户高端训练与推理;TaiShan 950 面向通用计算和数据库等场景。
第二章 产品概况与硬件规格
2.1 发布历程与定位
Atlas 950 SuperPoD 在 HC2025 公开路线图中亮相,MWC Barcelona 2026 完成海外展示,WAIC 2026 出现 1024 卡真机展示报道,官方规划 2026 年第四季度可用/商用。目标客户包括国家级/省级智算中心、头部大模型企业、大型互联网云厂商、运营商算力网络、央企 AI 平台和科研院所。
2.2 硬件架构与模块化设计
公开资料显示,Atlas 950 SuperPoD 以 64 张 Ascend 950DT NPU/计算柜为基础单元,满配由 128 个计算柜与 32 个通信柜构成,共 160 个机柜,约 1000㎡。其核心设计目标不是简单堆叠服务器,而是通过 UnifiedBus/灵衢互联、全光连接和统一内存编址,把多柜、多卡资源组织为统一执行环境。
2.3 核心硬件参数
| 参数 | 补充说明 |
|---|---|
| 计算单元 | Ascend 950DT,面向训练与 Decode 推理,HiZQ 2.0 HBM,单芯片 144GB,4TB/s 访存带宽,2TB/s 芯片互联带宽。 |
| 集群算力 | 满配 8192 卡,8 EFLOPS FP8、16 EFLOPS FP4。 |
| 内存体系 | 支持统一内存编址。1024 卡展示形态常见 256TB;8192 卡满配按 144GB/芯片可推算 1152TB 理论 HBM 容量。 |
| 互联系统 | UnifiedBus/灵衢 2.0,全光互联,官方口径 16PB/s 级互联带宽;媒体口径常见 16.3PB/s、3μs RTT。 |
| 性能指标 | 相较 Atlas 900 A3,训练吞吐 4.91M TPS、提升 17 倍;推理吞吐 19.6M TPS、提升 26.5 倍。 |
| 散热与工程 | 面向高密部署,液冷成为核心前提。展会/媒体材料提及浸没式液冷、高密供电、正交盲插、光电融合等工程能力。 |
2.4 软件栈体系
Atlas 950 超节点的软件栈包括 CANN 昇腾计算架构、通信库、统一内存管理、集群调度与运维监控,并通过 MindSpore、PyTorch 适配等方式降低模型迁移门槛。短期生态成熟度仍是商业落地关键变量。
第三章 核心技术深度拆解
3.1 Ascend 950DT NPU
Ascend 950DT 是 Atlas 950 SuperPoD 的核心芯片,定位训练与 Decode 推理。公开演讲称其支持 FP8、MXFP8、MXFP4、HiF8 等低精度格式,强调互联带宽和内存带宽,以适配大模型训练、MoE、长上下文推理等负载。
3.2 灵衢 2.0 / UnifiedBus 2.0
灵衢 2.0 是 Atlas 950 的核心壁垒。其价值在于用面向超节点的互联协议把大量 NPU 整合为单一逻辑计算域,减少传统分布式网络协议栈和交换层级带来的延迟。华为同时宣布开放 UnifiedBus 2.0 技术规范,希望推动国内算力互联生态形成统一标准。
3.3 全域统一内存编址
统一内存编址意在打破“单卡显存孤岛”,通过硬件级远程内存访问让多卡/多节点内存形成统一地址空间。对 MoE 模型,专家权重与激活跨设备调度频繁;对超长上下文推理,KV Cache 容量与访问效率决定吞吐。统一内存可降低数据搬运开销、提升资源利用率,但实际收益仍依赖编译器、通信库、模型切分和业务负载。
3.4 高密液冷与整机工程
8192 卡级超节点对供电、散热、布线、光纤管理和故障恢复提出极高要求。液冷、高密供电、光电互联、正交盲插等工程能力决定 Atlas 950 能否从“展会样机/路线图”走向可复制交付。
3.5 “系统补芯”的技术战略
Atlas 950 体现了华为“以系统架构弥补单芯片差距”的路线:在先进制程、单卡性能和 CUDA 生态短期难以完全追平的情况下,通过互联、内存、调度、软件栈和工程集成放大系统级有效算力。
第四章 性能、场景与 TCO
4.1 典型负载表现
公开口径下,Atlas 950 满配可实现 8 EFLOPS FP8、16 EFLOPS FP4,训练吞吐相对 Atlas 900 A3 提升 17 倍,推理吞吐提升 26.5 倍。其优势最可能体现在万亿参数预训练、十万亿参数 MoE、超长上下文 Agent 推理、多模态训练等通信和内存高度敏感场景。
4.2 场景适配分级
- 高适配:国家级基础大模型预训练、十万亿级 MoE、大规模 Agent 集群推理、多模态训练、公共智算中心。
- 中性适配:行业模型微调、企业高并发推理、自动驾驶仿真训练、AIGC 规模化推理。
- 低适配:小模型推理、边缘 AI、低并发企业应用;此类场景更适合 Atlas 850E 或普通推理服务器。
4.3 TCO 测算框架
Atlas 950 的 TCO 需要综合硬件采购、液冷/供电/机房改造、光模块和光纤、模型迁移、调优人力、运维备件、能耗和停机损失。若统一内存与高带宽互联显著提升模型有效算力利用率,长期单位算力成本可能低于传统万卡集群;但若客户模型迁移成本高、机房改造周期长,则短期经济性会承压。
4.4 部署约束
满配部署需要高功率供电、液冷条件、足够机房空间、专业运维和昇腾模型迁移人才。存量风冷 IDC 难以直接承接,适合新建或深度改造的高端智算中心。
第五章 竞品对比与 SWOT
5.1 与 NVIDIA NVL / DGX / SuperPOD 路线对比
华为公开材料和多家行业媒体将 Atlas 950 与 NVIDIA NVL144、NVL576 等路线比较,强调 Atlas 950 在卡规模、系统总算力、统一内存和互联带宽上的领先口径。需要注意,卡数和峰值算力并不等于真实业务性能,采购决策仍需以真实模型压测、框架适配、稳定性、可获得性和生态成本为准。
5.2 国内同类方案
国内 GPU/NPU 厂商在 2025–2026 年密集展示超节点或高带宽通信域方案,包括不同规模的 64 卡、128 卡、256 卡、384 卡、1024 卡方案。Atlas 950 的差异点在于华为已形成芯片、互联协议、服务器、液冷工程、软件栈和生态伙伴的系统化组合。
5.3 SWOT 补充
- 全栈国产化,自主可控程度高。
- 灵衢 2.0 与统一内存形成系统架构壁垒。
- 万卡级规模与国家级智算中心需求匹配。
- CUDA 生态惯性强,迁移成本不可忽视。
- 8192 卡稳定运行仍需规模商用验证。
- 液冷与高密部署门槛高。
- 国产智算中心建设与政策红利。
- AI 供应链安全诉求增强。
- 光互联、液冷、算力运维软件增量显著。
- 海外产品持续迭代。
- 国内路线竞争加剧。
- 高端算力投资可能阶段性过热。
第六章 产业链拆解与增量机会
Atlas 950 的产业链可分为上游核心元器件、中游整机集成与液冷交付、下游智算中心和 AI 应用客户。上游包括 NPU、CPU、HBM、封装基板、高速 PCB、光模块、光连接器、SerDes、电源和液冷组件;中游包括 Atlas 整机、互联柜、液冷机房改造、集群调度、故障自愈、模型迁移与运维服务;下游包括政府/国资智算平台、运营商、头部模型公司、互联网云厂商和行业 AI 平台。
产业链增量机会主要集中在四个方向:高速光互联、液冷基础设施、分布式 AI 软件与模型迁移工具、超大规模集群运维服务。若灵衢 2.0 成为国产算力互联通用标准,上游互联与认证生态的长期价值可能进一步扩大。
第七章 商业化进展、生态布局与市场空间
7.1 商业化时间表
2024–2025 年为架构研发和内部验证阶段;2025 年 HC 发布路线图;2026 年 MWC 海外展示、WAIC 真机展出;2026 年 Q4 进入官方规划的商用/可用窗口;2027–2028 年推进 Atlas 960、Ascend 970 和更大规模 SuperCluster。
7.2 生态战略
华为采用“硬件开放 + 软件开源 + 伙伴共建”的生态策略:开放灵衢协议规范、推进 CANN 和 MindSpore 生态、适配主流开源框架、发展整机集成和行业解决方案伙伴。生态成熟度将决定 Atlas 950 能否从政策型采购走向更广泛的市场型采购。
7.3 市场空间
2026–2030 年国内高端国产智算中心建设仍将保持高景气。Atlas 950 的潜在市场空间取决于高端国产算力预算、国产化渗透率、超节点在智算中心中的占比以及单套平均配置。短期主要面向国家级项目和头部客户,中长期有望随交付标准化和生态完善向更多行业扩散。
第八章 风险与不确定性
- 技术风险:8192 卡长期稳定运行、故障隔离、训练恢复、跨机柜光互联可靠性仍需公开实测验证。
- 软件风险:分布式训练、算子覆盖、模型迁移、调试工具、PyTorch/vLLM/Megatron 等生态适配仍需持续投入。
- 商业风险:初始投资高、液冷机房改造难、回报周期长。
- 生态风险:开发者社区、第三方框架、昇腾运维和算法优化人才仍存在缺口。
- 政策与行业风险:外部限制既可能提升国产替代需求,也可能影响上游供应;国内智算投资也存在阶段性同质化风险。
第九章 发展趋势研判
- 算力竞争从单芯片转向系统架构:互联带宽、通信时延、内存池化、可靠性和软件栈成为有效算力关键。
- 超节点将分层:液冷万卡级面向国家级与头部客户,风冷中小超节点面向企业推理和行业应用。
- 灵衢协议有望推动国产互联标准化:标准能否成立取决于伙伴数量、组件成熟度、测试认证和真实部署规模。
- 国产大模型训练底座自主化:Atlas 950 若如期商用,将显著增强国内高端大模型训练的供应可控性。
第十章 核心结论与产业建议
10.1 核心结论
Atlas 950 SuperPoD 是华为 AI 基础设施从“芯片产品”走向“系统工程平台”的标志性产品。它的核心价值在于通过灵衢 2.0、全光互联、统一内存编址和液冷高密工程,把大量 Ascend NPU 组织成更紧耦合的计算域,以适配 MoE、长上下文和 Agentic AI 的通信/内存瓶颈。
10.2 分主体建议
- 算力采购方:以真实模型做 PoC,重点测 MFU、长上下文吞吐、故障恢复、框架迁移和运维成本。
- 产业链厂商:重点布局光互联、液冷、高密电源、PCB、集群运维软件和灵衢适配。
- 算法企业:提前建设昇腾/CANN 迁移能力,优化 MoE 路由、KV Cache、低精度训练推理与通信重叠。
- 投资与产业观察者:持续跟踪 2026 Q4 订单、试点效果、稳定性实测、灵衢生态伙伴和开源社区活跃度。
10.3 关键跟踪指标
商用订单落地数量、满配集群稳定性实测数据、客户模型迁移效果、灵衢生态伙伴数量、CANN/昇腾社区开发者活跃度、液冷机房标准化交付能力,是判断 Atlas 950 产业化进度的核心指标。
附录补充
附录 A:参数汇总
- 最大组网:8192 颗 Ascend 950DT
- 基础单元:单柜 64 卡
- 满配机柜:128 计算柜 + 32 通信柜
- FP8/FP4:8/16 EFLOPS
- 互联:16PB/s 级
- 上市:2026 Q4
附录 B:核心名词
- SuperPoD:物理多机、逻辑单机的超节点。
- 灵衢/UnifiedBus:面向超节点的高速互联协议。
- 统一内存编址:跨设备统一地址空间。
- MoE:混合专家模型。
- FP4/FP8:低精度 AI 计算格式。
附录 C:传统集群与超节点对比
| 维度 | 传统 Scale-out 集群 | 超节点 Scale-up 融合架构 |
|---|---|---|
| 通信 | 层级转发,协议栈复杂 | 直连/总线语义,低时延 |
| 内存 | 单卡显存孤岛 | 统一内存编址与资源池化 |
| 算力利用率 | 易受通信等待影响 | 目标是提升有效 MFU |
| 部署 | 开放灵活 | 工程集成复杂、机房要求高 |
| 适配场景 | 通用分布式训练/推理 | 万亿级模型、MoE、长上下文、高并发推理 |
参考来源与置信度说明
来源使用原则:产品路线图、上市时间、满配规模、算力和互联带宽优先采用华为官网/官方演讲;展会真机、1024 卡展示形态、SAIL 奖、部署数量等采用人民网、环球网、新浪/搜狐/媒体报道交叉参考;竞品指标采用 NVIDIA/媒体路线图时标注不确定性。
- Huawei, “Groundbreaking SuperPoD Interconnect: Leading a New Paradigm for AI Infrastructure”, HC2025 徐直军主题演讲:https://www.huawei.com/en/news/2025/9/hc-xu-keynote-speech
- Huawei, “Huawei Unveils World's Most Powerful SuperPoDs and SuperClusters”:https://www.huawei.com/en/news/2025/9/hc-lingqu-ai-superpod
- Huawei, “Huawei Unveiled the Latest SuperPoD, Making an AI Infrastructure New Option to the World”, MWC 2026:https://www.huawei.com/en/news/2026/3/mwc-superpod-ai
- Huawei, “Huawei's SuperPoD Portfolio Creates New Option for Global Computing at MWC Barcelona 2026”:https://www.huawei.com/en/news/2026/3/mwc-superpod-computing
- Ascend Community, Atlas 950 SuperPoD product page/specifications:https://www.hiascend.com/en/hardware/cluster?tag=950
- 人民网,《华为发布算力超节点和集群》:http://finance.people.com.cn/n1/2025/0918/c1004-40567058.html
- 环球网,《MWC26:华为Atlas 950 SuperPoD超节点海外首秀》:https://tech.huanqiu.com/article/4QheRfcF860
- Tom's Hardware, “Huawei Ascend NPU roadmap examined”:https://www.tomshardware.com/tech-industry/artificial-intelligence/huawei-ascend-npu-roadmap-examined-company-targets-4-zettaflops-fp4-performance-by-2028-amid-manufacturing-constraints
- Artificial Intelligence News, “Huawei's new Ascend chips to power world's most powerful cluster”:https://www.artificialintelligence-news.com/news/huawei-announces-new-ascend-chips-to-power-worlds-most-powerful-clusters/
- Converge Digest, “Huawei Unveils Next-Gen Ascend Chips, SuperPoDs, and UnifiedBus Interconnect”:https://convergedigest.com/huawei-unveils-next-gen-ascend-chips-superpods-and-unifiedbus-interconnect/
- Data Centre Magazine, “How Powerful are Huawei’s New SuperPoDs and SuperClusters?”:https://datacentremagazine.com/news/how-powerful-are-huaweis-new-superpods-and-superclusters
- 多家 WAIC 2026 中文媒体报道(中国经营报、证券/财经媒体、华为企业业务微博等)用于交叉确认 1024 卡真机展示、Atlas 850E、384 超节点部署数量等展会信息。
- Huawei, “Huawei Launches Open-Access SuperPoD Architecture for All Scenarios”:https://www.huawei.com/en/news/2025/9/hc-superpod-innovation
- LightCounting, “July 2026 Atlas 950 SuperPoD: Achieves All-Optical Interconnection with Superior Cost and Power Efficiency”:https://www.lightcounting.com/research-note/july-2026-atlas-950-superpod-achieves-all-optical-interconnection-with-superior-cost-and-power-efficiency-450
- RCR Wireless, “Huawei outlines roadmap for Ascend AI chips”:https://www.rcrwireless.com/20250922/ai-infrastructure/huawei-ai-chips
- Jon Peddie Research, “Huawei’s Ascend 950 AI processor”:https://www.jonpeddie.com/techwatch/huaweis-ascend-950-ai-processor/
- NVIDIA Technical Blog, “Inside the NVIDIA Vera Rubin Platform: Six New Chips, One AI Supercomputer”:https://developer.nvidia.com/blog/inside-the-nvidia-rubin-platform-six-new-chips-one-ai-supercomputer/
- NVIDIA, “Next Gen Data Center CPU | NVIDIA Vera CPU”:https://www.nvidia.com/en-us/data-center/vera-cpu/
- NVIDIA Technical Blog, “NVIDIA NVLink: The Scale-Up Network for AI Factories”:https://developer.nvidia.com/blog/nvidia-nvlink-the-scale-up-network-for-ai-factories/
- NVIDIA CUDA Programming Guide, Unified and System Memory / Unified Memory:https://docs.nvidia.com/cuda/cuda-programming-guide/02-basics/understanding-memory.html
免责声明:本报告基于截至 2026-08-03 可检索公开资料整理,不构成采购、投资或工程实施建议。所有未来时间、性能领先表述和商业规模预测均需以后续正式 datasheet、客户实测和订单交付为准。