📊 执行摘要
截至2026年,AI算力市场已形成"GPU主导训练、LPU主导高并发推理"的格局。2026年3月NVIDIA在GTC大会发布Vera Rubin平台,正式将Groq LPU技术整合入其产品线,标志着推理专用芯片进入主流市场。本报告融合Coding Confessions深度解析与行业最新数据,从架构原理、TSP硬件设计、实测数据、国产化替代及未来趋势维度,为企业技术选型提供决策依据。
📖 一、核心定义与市场定位
🟢 GPU (Graphics Processing Unit)
- 通用并行计算加速器,基于SIMT架构
- 核心优势:灵活性与高吞吐
- AI训练与通用计算的基石
- 代表:NVIDIA H系列 / AMD MI系列
- 生态:CUDA操作系统级壁垒
🔵 LPU (Language Processing Unit)
- 专用推理加速器,以Groq为代表
- 采用数据流架构 (Dataflow)
- 核心优势:极低延迟与确定性响应
- 专为大模型Token生成优化
- 采用TISC架构,编译器静态调度
🔔 重磅消息:NVIDIA正式入局LPU
2025年12月,NVIDIA以200亿美元完成对Groq核心技术的收购,获得LPU技术非独家许可并吸纳核心团队。2026年3月GTC大会上,NVIDIA正式发布Groq 3 LPU,整合入Vera Rubin平台,用于AI推理加速。
⚙️ 二、架构深度对比
2.1 内存架构:打破"内存墙"的关键
🟢 GPU 内存架构
- 存储方案HBM堆叠DRAM
- 带宽 (H100)3.35 TB/s
- 带宽 (Rubin)22 TB/s
- 容量80-288 GB
- 延迟较高 (DRAM本质)
- 缓存层级L1/L2/Shared 复杂
🔵 LPU 内存架构
- 存储方案片上SRAM
- 带宽 (Groq3)150 TB/s
- 带宽 (LPX Rack)40 PB/s
- 容量 (单芯片)500 MB
- 延迟接近零 (片上)
- 缓存极简 (编译器优化)
2.2 关键技术答疑
❓ FAQ: 为什么SRAM比HBM快?万亿参数模型如何处理?
1️⃣ 为什么LPU的片上SRAM比GPU的HBM快这么多?
核心原因:物理距离决定延迟上限
| 指标 | HBM (GPU) | SRAM (LPU) |
| 物理位置 | 芯片外部,通过1000+引脚球栅阵列(BGA)连接 | 芯片内部,与计算单元同处一个硅片 |
| 访问延迟 | 100-200 纳秒 (ns) | 0.5-2 纳秒 (ns) — 快50-400倍 |
| 带宽单位 | 3.35 TB/s (H100) | 150 TB/s (Groq3单芯片) |
| 数据传输 | 序列化并行传输,受制于引脚数量和信号完整性 | 并行内部总线,带宽近乎无限 |
打个比方:HBM就像把图书馆的书放在隔壁楼,阅读时需要走过去拿(100ns);SRAM就像书就放在你办公桌上,伸手就能拿(1ns)。虽然"隔壁楼"有电梯和快递系统(DDR5/HBM的高带宽),但物理距离的差距是根本性的。
2️⃣ Groq3只有500MB SRAM,如何处理万亿参数大模型(如Kimi 2.5)?
关键洞察:不是"把大模型塞进LPU",而是"GPU + LPU 异构协同"
🔑 MoE模型的核心架构:
MoE (Mixture of Experts) 将模型分成两部分:
- Attention层 — 需要完整KV缓存,内存需求大,必须用GPU的HBM(288GB+)
- FFN/专家层 — 计算密集但内存需求相对小,适合LPU处理
例如:Mixtral 8x7B有8个专家,每次只激活2个,激活参数只占15-30%
✅ Vera Rubin架构的异构分工:
| 处理器 | 职责 | 内存方案 |
| Vera Rubin GPU | Attention层 + KV缓存 + 长上下文 | 288GB HBM4 |
| Groq 3 LPU | FFN层 + MoE专家路由 + Token生成 | 500MB片上SRAM |
⚡ 关于专家切换延迟:
- 编译器预知:MoE的路由决策在编译时就可确定(因为是确定性路由算法)
- 预取机制:编译器提前把下一个专家权重加载到SRAM
- 流水线重叠:专家切换与计算并行,隐藏加载延迟
- 结果:对用户感知延迟几乎无影响(编译器优化掉)
LPU解决方案:GPU处理需要大内存的部分,LPU处理需要低延迟的部分
| 对比 | 纯GPU方案 | GPU + LPU 异构 |
| 万亿参数MoE | 全部塞进HBM,需要640GB+ | GPU管Attention/KV,LPU管FFN/专家 |
| 延迟 | HBM访问延迟100-200ns | FFN层0.5-2ns,流水线无等待 |
| 专家切换 | 动态路由,运行时决定 | 编译器预知 + 预取隐藏延迟 |
📌 总结:LPU不是GPU的替代品,而是最佳拍档。Vera Rubin平台 = Rubin GPU(处理大内存的Attention)+ Groq LPU(处理低延迟的FFN/专家)。专家切换的延迟被编译器的预取和流水线重叠完全隐藏,对用户感知延迟影响接近零。
2.3 计算模型对比
📊 GPU vs LPU 硬件规格对比
| 特性 | GPU (H100) | LPU (Groq3) |
|---|---|---|
| 内存类型 | HBM (片外) | SRAM (片上) |
| 内存带宽 | 3.35 TB/s | 150 TB/s |
| 片上SRAM | ~50 MB | 500 MB |
| 内存访问延迟 | ~100 ns | ~1 ns |
| 制程工艺 | 4N (TSMC) | 三星 SF4 (4nm) |
| 晶体管数量 | 80B | 22B |
| TDP | 700W | >300W |
| 算力 (FP8) | 989 TFLOPS | 1.2 PFLOPS |
| 带宽/算力比 | 3.4 GB/s/TF | 125 GB/s/TF |
💡 关键洞察:LPU的内存带宽是GPU的45倍,这对LLM推理至关重要——内存带宽直接决定Token生成速度。
以下表格详细说明GPU与LPU的架构差异如何直接影响推理速度与效率:
| 特性 | GPU (SIMT) | LPU (Dataflow) | 对推理速度的影响 |
|---|---|---|---|
| 执行模式 | SIMT — 单指令多线程,数千线程并行执行相同指令。但线程间存在分支分歧(branch divergence)时,效率骤降。大模型的自回归生成逐Token执行,大量线程被闲置。 | 数据流 — 算子按拓扑顺序执行,数据从内存流入经过各处理单元流出。无分支分歧,每个时钟周期都在做有效计算。 | ✅ LPU胜出 GPU线程闲置=算力浪费 |
| 调度方式 | 硬件动态调度 — Warp Scheduler在运行时决定哪些线程在哪个计算单元执行。需要复杂的乱序引擎、寄存器重命名、发射队列。运行时开销约占15-30%算力。 | 编译器静态调度 — 编译器在编译时精确规划每条指令的执行时间与数据位置。运行时硬件只需执行既定计划,无调度决策开销。 | ✅ LPU胜出 消除15-30%调度开销 |
| 并行粒度 | 细粒度线程级 — 线程是最小调度单位。H100有168个SM,每SM可调度64个warp(共10752个warp)。线程切换需要保存/恢复寄存器状态,上下文切换开销显著。 | 粗粒度算子级 — 320-lane SIMD单元作为整体调度。指令流式穿过功能单元,无线程切换开销。编译器确保数据在正确时间到达正确位置。 | ✅ LPU胜出 零线程切换开销 |
| 内存架构 | HBM+多级缓存 — H100带宽3.35TB/s,但相对计算速度仍供不应求。L1/L2缓存命中率决定是否能跑满计算单元。缓存未命中时需等待HBM响应(约500周期)。 | 片上SRAM 220MB — Groq3单芯片500MB SRAM,带宽高达150TB/s,是H100的45倍。权重完全片上存储,零HBM访问等待。 | ✅ LPU胜出 消除"内存墙"瓶颈 |
| 延迟确定性 | 非确定性 — 缓存预取投机执行可能命中或失效,乱序执行完成时间不可预测,Token生成延迟波动大(P99延迟可能是P50的3-5倍)。 | 确定性 — ISA (Instruction Set Architecture, 指令集架构) 暴露精确延迟信息,编译器保证数据在指定周期精确到达。Token生成延迟稳定,波动<5%。这对实时交互体验至关重要。 | ✅ LPU胜出 稳定可预测的延迟 |
| 批处理效率 | 大Batch优势 — 同时处理多个序列,计算单元利用率高。但小Batch时线程闲置严重。首Token延迟与Batch大小正相关。 | 流式执行 — 无需Batch即可高效运行。每个新Token直接使用前一Token结果,流水线式生成。首Token延迟与Batch无关,始终最优。 | ✅ LPU胜出 小Batch场景下优势明显 |
⚡ 推理速度提升的本质
LPU之所以能在推理速度上远超GPU,核心在于消除三大瓶颈:
1. 内存墙 — GPU的计算速度(>1000 TFLOPS)远超HBM带宽(3.35 TB/s),计算单元经常等待数据。
→ LPU以150TB/s SRAM带宽彻底消除等待,计算单元始终满载。
2. 调度开销 — GPU需要复杂运行时进行线程调度与内存一致性维护。
→ LPU的编译器静态调度将这部分开销降至零。
3. Batch依赖 — GPU需要大Batch才能跑满算力,导致首Token延迟高。
→ LPU流式执行无需Batch,小Batch下仍保持高效。
2.5 Groq LPU (TSP) 架构深度解析
📖 核心创新:翻转架构 (Flipped Architecture)
TSP (Tensor Streaming Processor) 对传统CPU/GPU架构进行了根本性颠覆。传统多核芯片采用"平铺架构"——每个tile包含全套功能单元。而TSP设计师将功能单元从核心中抽出,排列成2D网格,称为"翻转架构"。
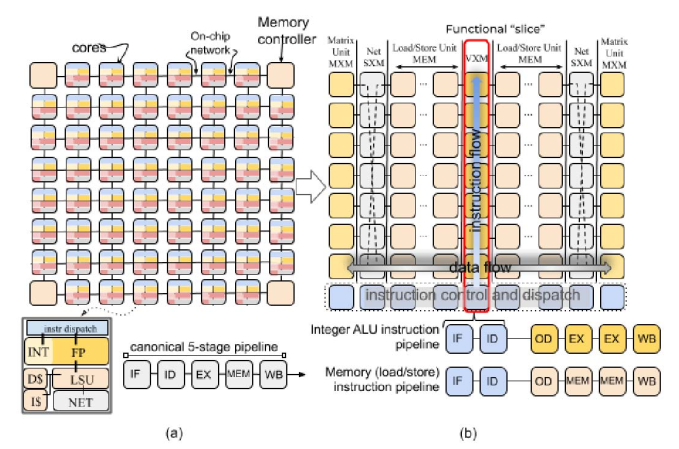
图1: (a) 传统平铺多核架构 vs (b) TSP翻转架构
🔷 Groq 3 LP30 芯片规格
- 制程工艺三星 SF4 (4nm)
- 片上SRAM512 MB
- SRAM带宽150 TB/s
- FP8算力1.2 PFLOPS
- SerDes数量96个 (112 Gbps)
- Scale-up带宽2.5 TB/s
⚡ 能效与功耗对比
| 芯片型号 | 制程 | Die Size | 最大功耗 | TDP | 典型功耗 |
| GroqChip (v1) | 14nm | ~725 mm² | 300W | 215W | ~185W |
| GroqCard | — | — | 375W | — | ~240W |
| Groq 3 LP30 | 4nm (三星) | > 700 mm² | 未公开 | — | — |
数据来源:Groq whitepaper, Technetbook, Awesome Agents
Groq 3 LPU采用气冷设计(无需液冷),每瓦特推理吞吐量是GPU的35倍。
- • GPU方案需要35兆瓦的工作负载,LPU+GPU混合方案仅需1兆瓦
- • 每次推理能耗:LPU 1-3焦耳/token vs GPU 10-30焦耳/token
- • LPX机架:全液冷设计(32托盘 × 8芯片高密度部署)
2.6 功能切片 (Functional Slices)
每个垂直切片代表一类同构功能单元集合,所有切片以生产者-消费者模式运作——一个切片产生结果作为数据流,下一个切片接收作为输入。
⬛ MXM
Matrix Multiply
执行矩阵乘法运算,是神经网络计算的核心单元
⬛ SXM
Shift/XM
执行向量的移位和旋转操作
⬛ MEM
Memory
处理内存读写操作
⬛ VXM
Vector/XM
执行向量的算术运算
⬛ ICU
Instruction Control Unit
水平组织,负责获取和分发指令到其他切片
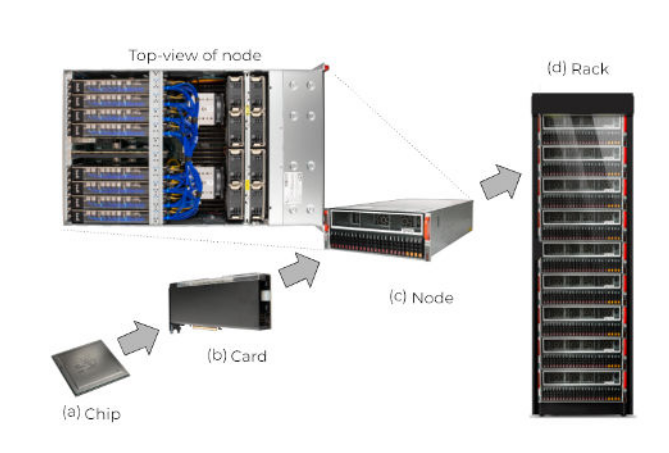
图2: 数据流在TSP切片间的东西方向流动
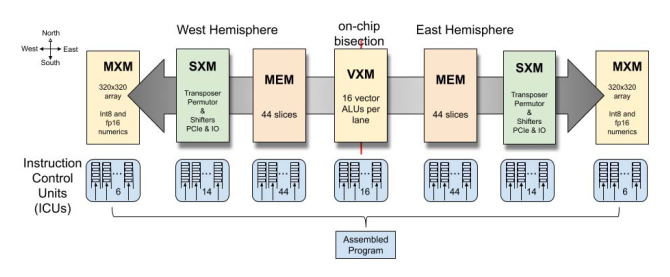
图3: 流水线指令执行,时间戳错开执行
2.7 多TSP分布式系统
🔶 节点 (Node)
- • 8个TSP设备
- • 7个设备间连接
- • 4个全局链路
- • 32端口高阶路由器
🔶 机架 (Rack)
- • 9个节点 (72 TSPs)
- • 288总端口
- • 144机架内本地连接
- • 144机架间连接
🔶 最大配置
- • 145个机架
- • 10,440个TSP
- • 任意两TSP间最多5跳
- • 每机架含备用节点
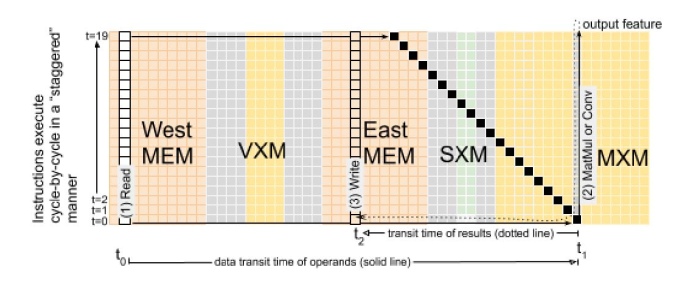
图4: 层次化系统架构 — 8个TSP组成节点,9个节点组成完整机架
🔌 NVIDIA Groq 3 LPX 机架系统(2026 GTC发布)
NVIDIA于2026年3月GTC大会上正式发布Groq 3 LPX,这是首个集成到Vera Rubin平台的LPU机架级系统。
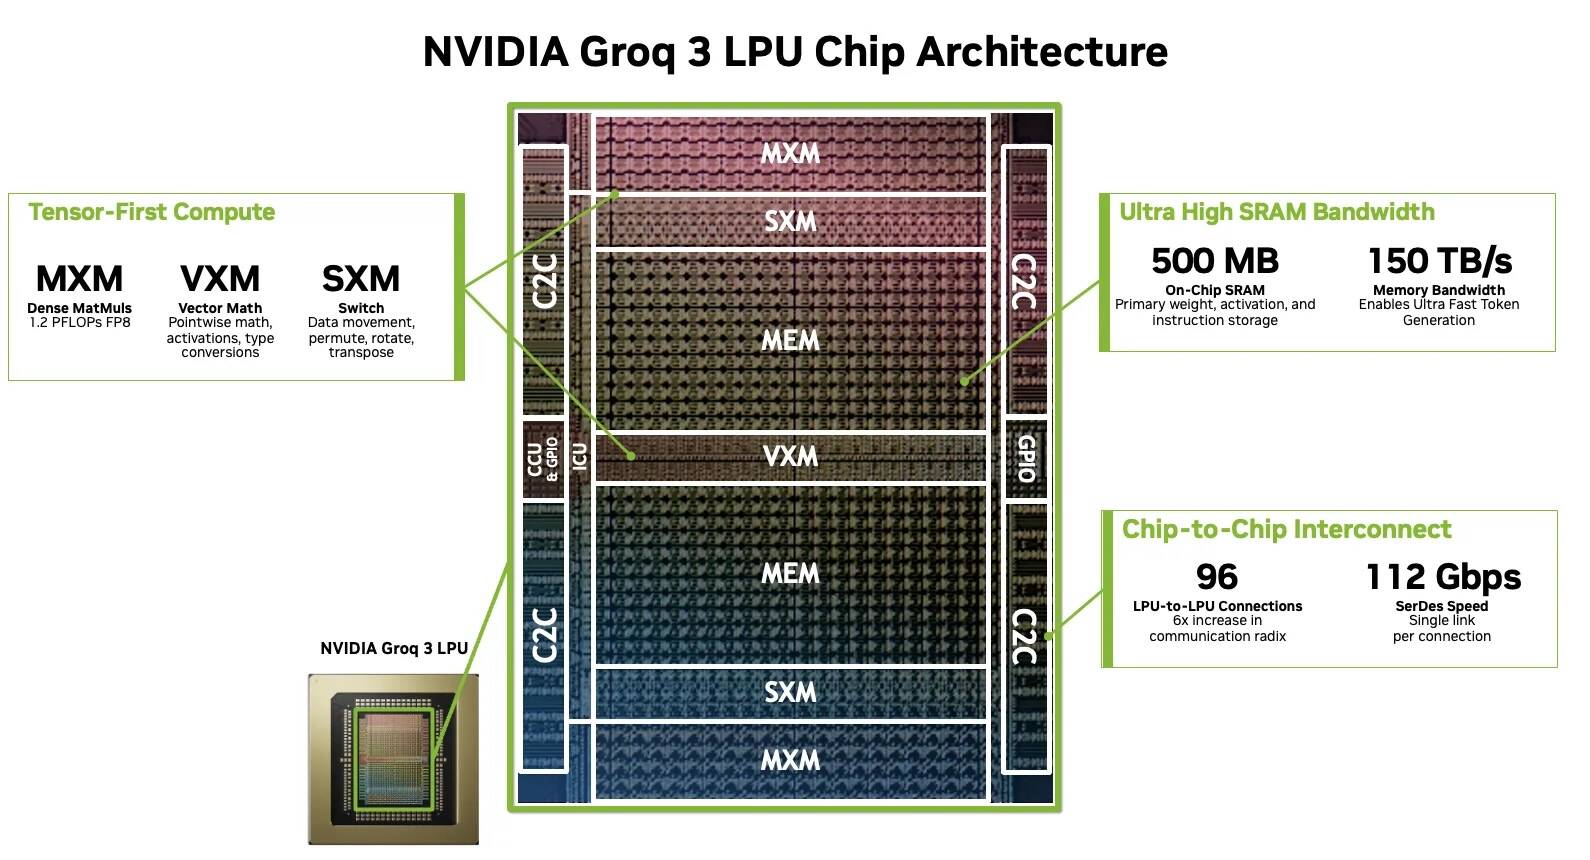
图5: Groq 3 LPU 芯片实物图
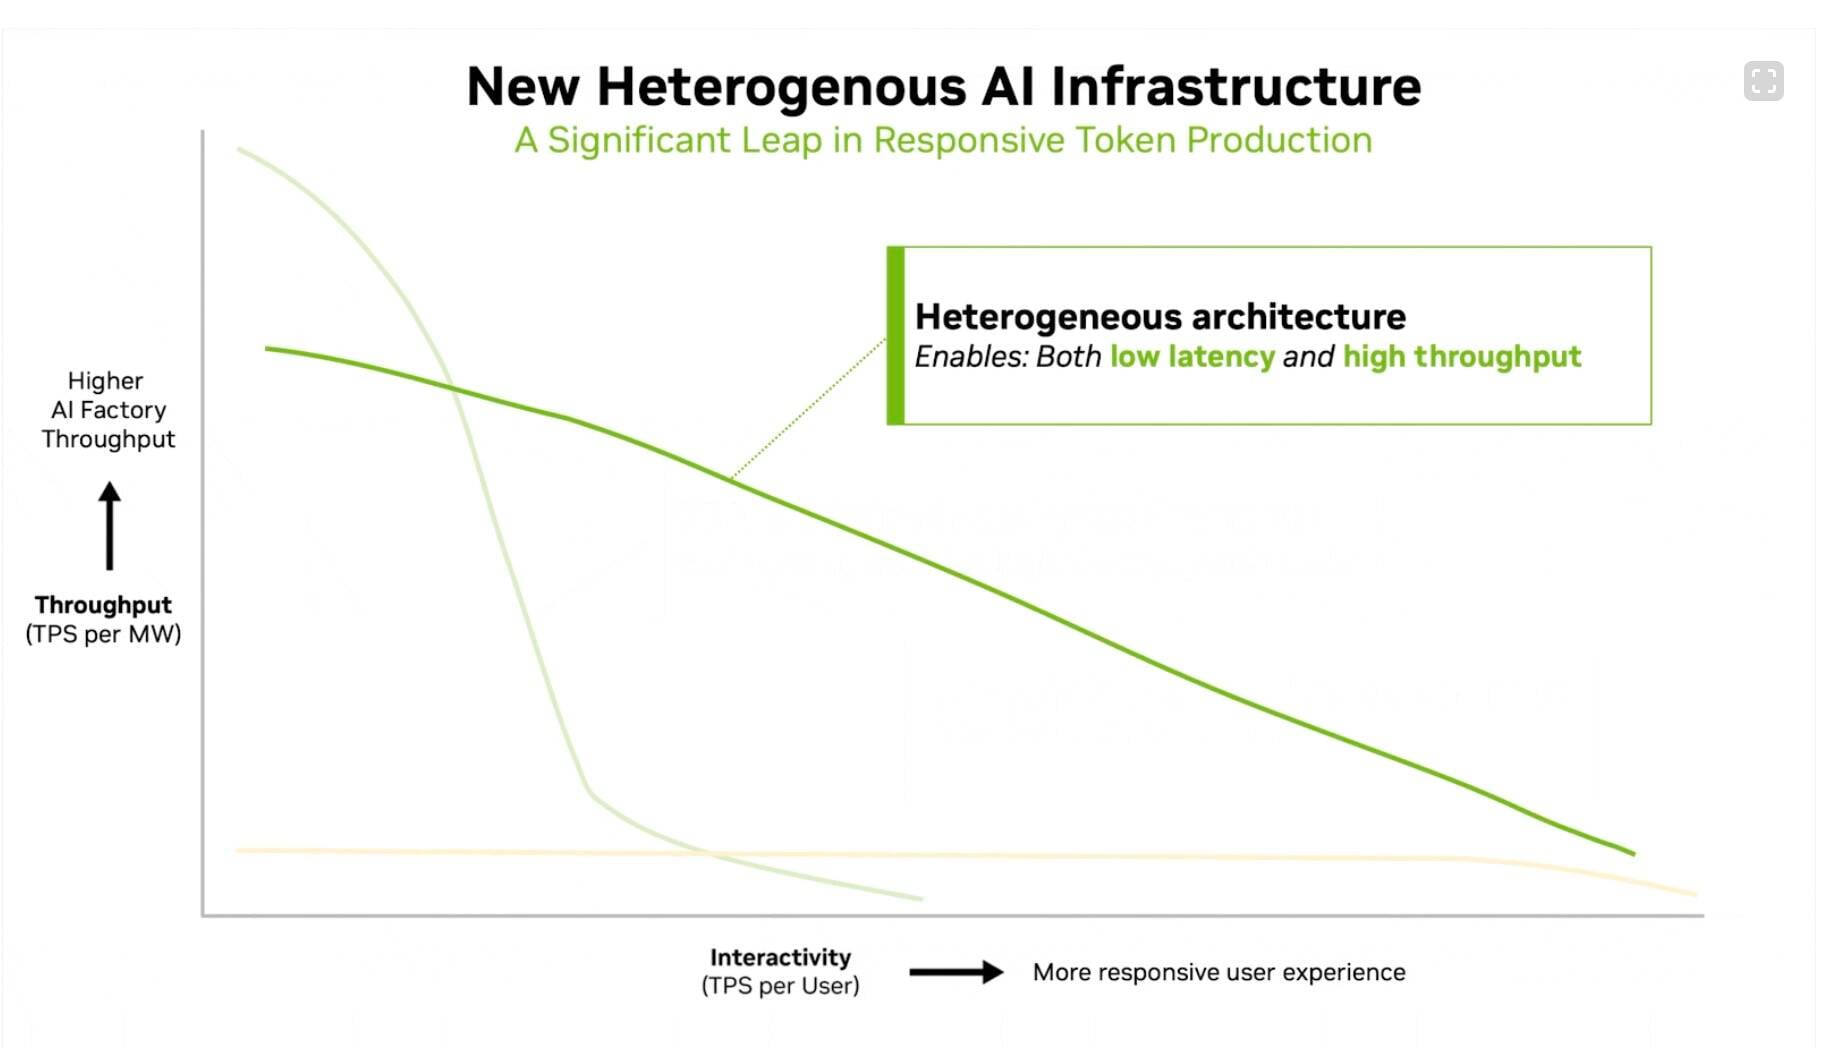
图6: GPU + LPU 异构协同架构
LPX 机架规格
| 规格 | LPX Rack | 单芯片 (Groq 3 LPU) |
| LPU数量 | 256个 | 1个 |
| SRAM总容量 | 128 GB | 500 MB |
| SRAM带宽 | 40 PB/s | 150 TB/s |
| Scale-up带宽 | 640 TB/s | 2.5 TB/s |
| 互连技术 | RealScale (芯片直连) | 96个SerDes |
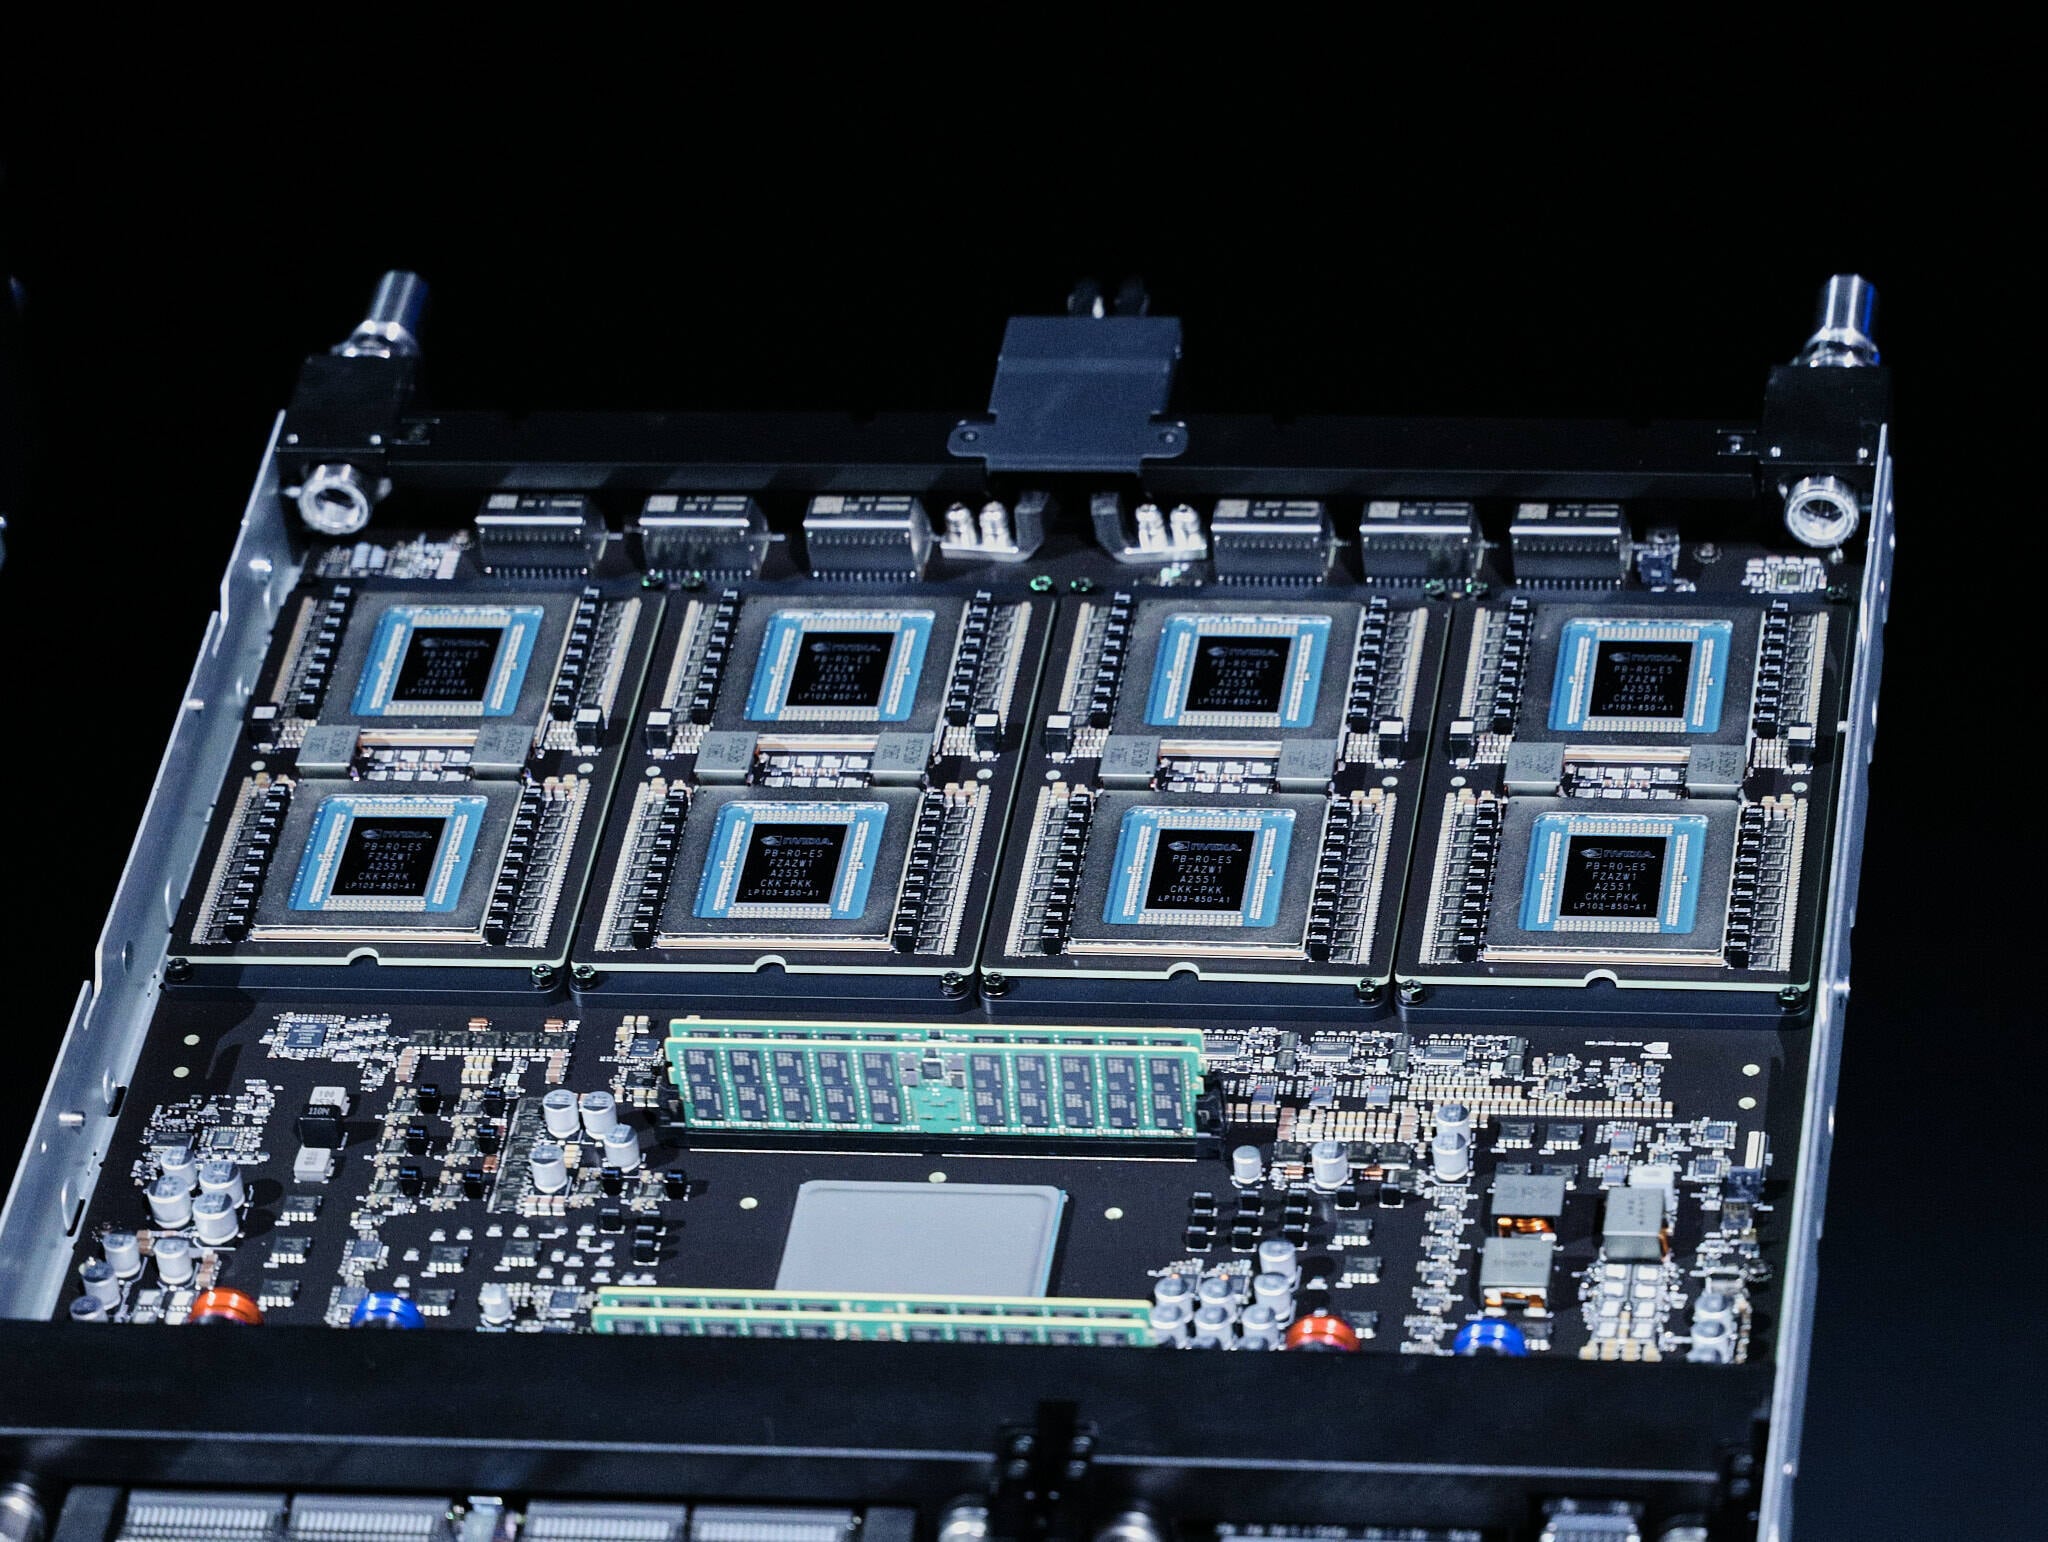
图7: NVIDIA Groq 3 LPX 机架系统 — 256个LPU协同工作
🔗 机架间连接架构
机架内连接 (Within Rack)
- • 32个计算托盘,每托盘8个LPU
- • 托盘间通过LPU C2C Spine直连
- • 铜缆连接数千条Tx/Rx通道对
- • 背对背安装,全液冷设计
- • 640 TB/s rack-scale带宽
机架间连接 (Across Racks)
- • LPX通过Spectrum-X Ethernet互联
- • 连接到Vera Rubin NVL72机架
- • NVL72含36个Vera CPU + 72个Rubin GPU
- • GPU处理Prefill,LPU处理Decode
- • NVLink 72提供高速内部连接
🏗️ 完整AI工厂架构
典型配置:1个LPX Rack + 1个Vera Rubin NVL72 Rack
- • NVL72 Rack:36 Vera CPU + 72 Rubin GPU + HBM4 (288GB/卡)
- • LPX Rack:256 Groq 3 LPU + 128GB SRAM + 40PB/s带宽
- • GPU专注Prefill阶段(计算密集、需大内存)
- • LPU专注Decode阶段(访存密集、低延迟)
- • NVIDIA Dynamo编排层管理任务分配
效果:每瓦特推理吞吐量提升35倍!
2.8 确定性执行模型
❌ TSP 消除的传统非确定性
- • 无缓存 (No Caches)
- • 无乱序执行 (No Out-of-Order Execution)
- • 无推测执行 (No Speculative Execution)
- • 无动态调度 (No Dynamic Scheduling)
- • 无硬件路由 (No Reactive Routing)
✅ TSP 确定性保证
- • 编译器静态调度所有指令
- • ISA (指令集架构) 暴露精确延迟信息
- • 数据流精确到达处理单元
- • 软件定义硬件
- • 消除背压和拥塞
📖 ISA (Instruction Set Architecture) 详解:TSP性能确定性的基石
什么是ISA?
指令集架构定义了CPU/GPU能执行的所有指令及其语义。传统架构只定义"做什么",不暴露"多久做完"——编译器只知道执行结果是正确的,但不知道需要多少时钟周期。
❌ 传统CPU/GPU的ISA局限:
- • 编译器只知道指令"能做什么",不知道"需要多久"
- • 运行时由硬件动态决定指令执行顺序(乱序执行引擎)
- • 缓存命中/未命中在运行时才知道
- • 结果:编译器无法精确预测程序执行时间 → 延迟不确定性
✅ TSP的ISA创新:暴露精确延迟
- • 每条指令都附带确切的延迟周期数(例如:MATMUL = N个周期,LOAD = M个周期)
- • 编译器在编译时就能精确计算每条指令的完成时间
- • 编译器据此在时间维度上精确调度:确保数据在处理单元空闲时刚好到达
- • 实现真正的"所见即所得"性能——编译时确定=运行时确定
💡 对推理速度的意义:
| GPU | 运行时猜测最优执行顺序 → 延迟不可预测,P99波动大 |
| TSP/LPU | 编译时规划最优执行路径 → 确定性低延迟,波动<5% |
2.9 同步机制
| 机制 | 功能 | 应用场景 |
|---|---|---|
| HAC (Hardware Aligned Counter) | 256周期溢出计数器,用于TSP间同步 | 时钟同步、漂移校正 |
| SYNC/NOTIFY | 单TSP内 barrier 同步 | 暂停指令队列直到广播RESUME |
| DESKEW | 对齐到epoch边界 | 多TSP执行边界对齐 |
| RUNTIME_DESKEW | 运行时重新同步 | 执行期间动态同步 |
🔗 软件调度网络
编译器在编译时静态调度所有跨网络的数据移动,消除了传统网络系统中由路由和调度引入的非确定性。这实现了基于张量维度 (H × W × C) 的确定性负载均衡。
🛡️ 错误处理
采用前向纠错 (FEC) 逐跳传输和原位纠错。瞬态错误通过软件重放处理;每个机架包含一个备用TSP节点用于故障切换。
📈 三、性能实测对比
📊 关键性能指标(基于 Llama3-70B)
🎯 四、应用场景选型矩阵
| 场景特征 | 推荐方案 | 理由 |
|---|---|---|
| 模型训练 & 微调 | 🟢 GPU (NVIDIA/昇腾) | 无可替代,生态依赖 |
| 高并发在线服务 | 🔵 LPU (Groq/国产LPU) | 低延迟、高吞吐、低成本 |
| 多模态推理 | 🟢 GPU | 视觉+语言混合任务,LPU不擅长 |
| 边缘设备/低功耗 | 🔵 国产LPU | 清微/后摩能效比极高 |
| 金融/政务合规 | 🟢🔵 国产 GPU/LPU | 自主可控,符合信创要求 |
| 实时对话 (Chatbot) | 🔵 LPU | 用户感知延迟极低,体验接近真人 |
| 批量离线推理 | 🟢 GPU | 大Batch吞吐量高 |
🇨🇳 五、国产化生态
5.1 国产 GPU(通用加速路线)
华为昇腾 (Ascend 910B/910C)
达芬奇架构,国内生态最成熟
训练 推理支持训练与推理,兼容PyTorch via CANN
寒武纪 (思元590)
MLU架构,国产AI推理芯片龙头
训练 推理市值4434亿元,2025年营收近65亿元
沐曦股份 (MX系列)
对标国际一线,6000+CUDA兼容
训练万卡级训练集群解决方案
摩尔线程 (全功能GPU)
AI计算 + 3D图形渲染双轮驱动
训练 推理2025年营收同比增长243%
5.2 国产 LPU(专用推理路线)
无问芯穹 (Infini-ACC)
明确提出LPU概念,软硬协同设计
推理 边缘单卡跑Llama2-70B,300token/s
清微智能 (TX81 RPU)
可重构计算,"软件定义硬件"
推理 边缘已部署超3万张卡,国家大基金唯一投资
后摩智能 (鸿途H30)
存算一体架构
推理 边缘低功耗优势显著
💡 国产选型建议
- 全栈替代:选华为昇腾(生态最全,人才最多)
- 极致推理:测试无问芯穹或清微智能(针对特定模型优化)
- 边缘部署:考虑清微或后摩(低功耗优势)
🚀 六、未来趋势与挑战
6.1 技术融合趋势
🔮 异构计算时代
未来服务器 = GPU (训练/复杂推理) + LPU (高并发服务)
- GPU借鉴LPU思路,增加片上缓存
- LPU将适度增加通用性
- NVIDIA Vera Rubin:VR( Prefill) + LPX( Decode)
📅 NVIDIA roadmap
6.2 挑战
⚠️ 生态薄弱
LPU软件栈(驱动、模型转换)成熟度远不及CUDA
⚠️ 模型适配
新模型架构(如MoE)可能打破LPU的静态调度优势
⚠️ 国产差距
在编译器技术与生态工具链上,国产厂商仍需追赶
✅ 七、最终建议
🎯 技术决策者
- 短期:训练与复杂推理用GPU;高并发服务试点LPU
- 长期:构建"GPU+LPU"混合算力池,优化TCO
- 关注NVIDIA Vera Rubin平台进展
💰 采购建议
- 不要只看单卡价格,要看每Token成本和延迟SLA
- 国产化项目优先考虑华为昇腾(稳妥)或无问芯穹(创新)
- 高并发场景优先测试LPU方案
📌 结论
LPU不是GPU的替代品,而是AI算力拼图中不可或缺的专用加速器。在推理侧,它代表了"更高效、更实时"的技术方向。2026年,随着NVIDIA正式入局LPU并将其整合入主流平台,推理专用芯片时代已全面到来。