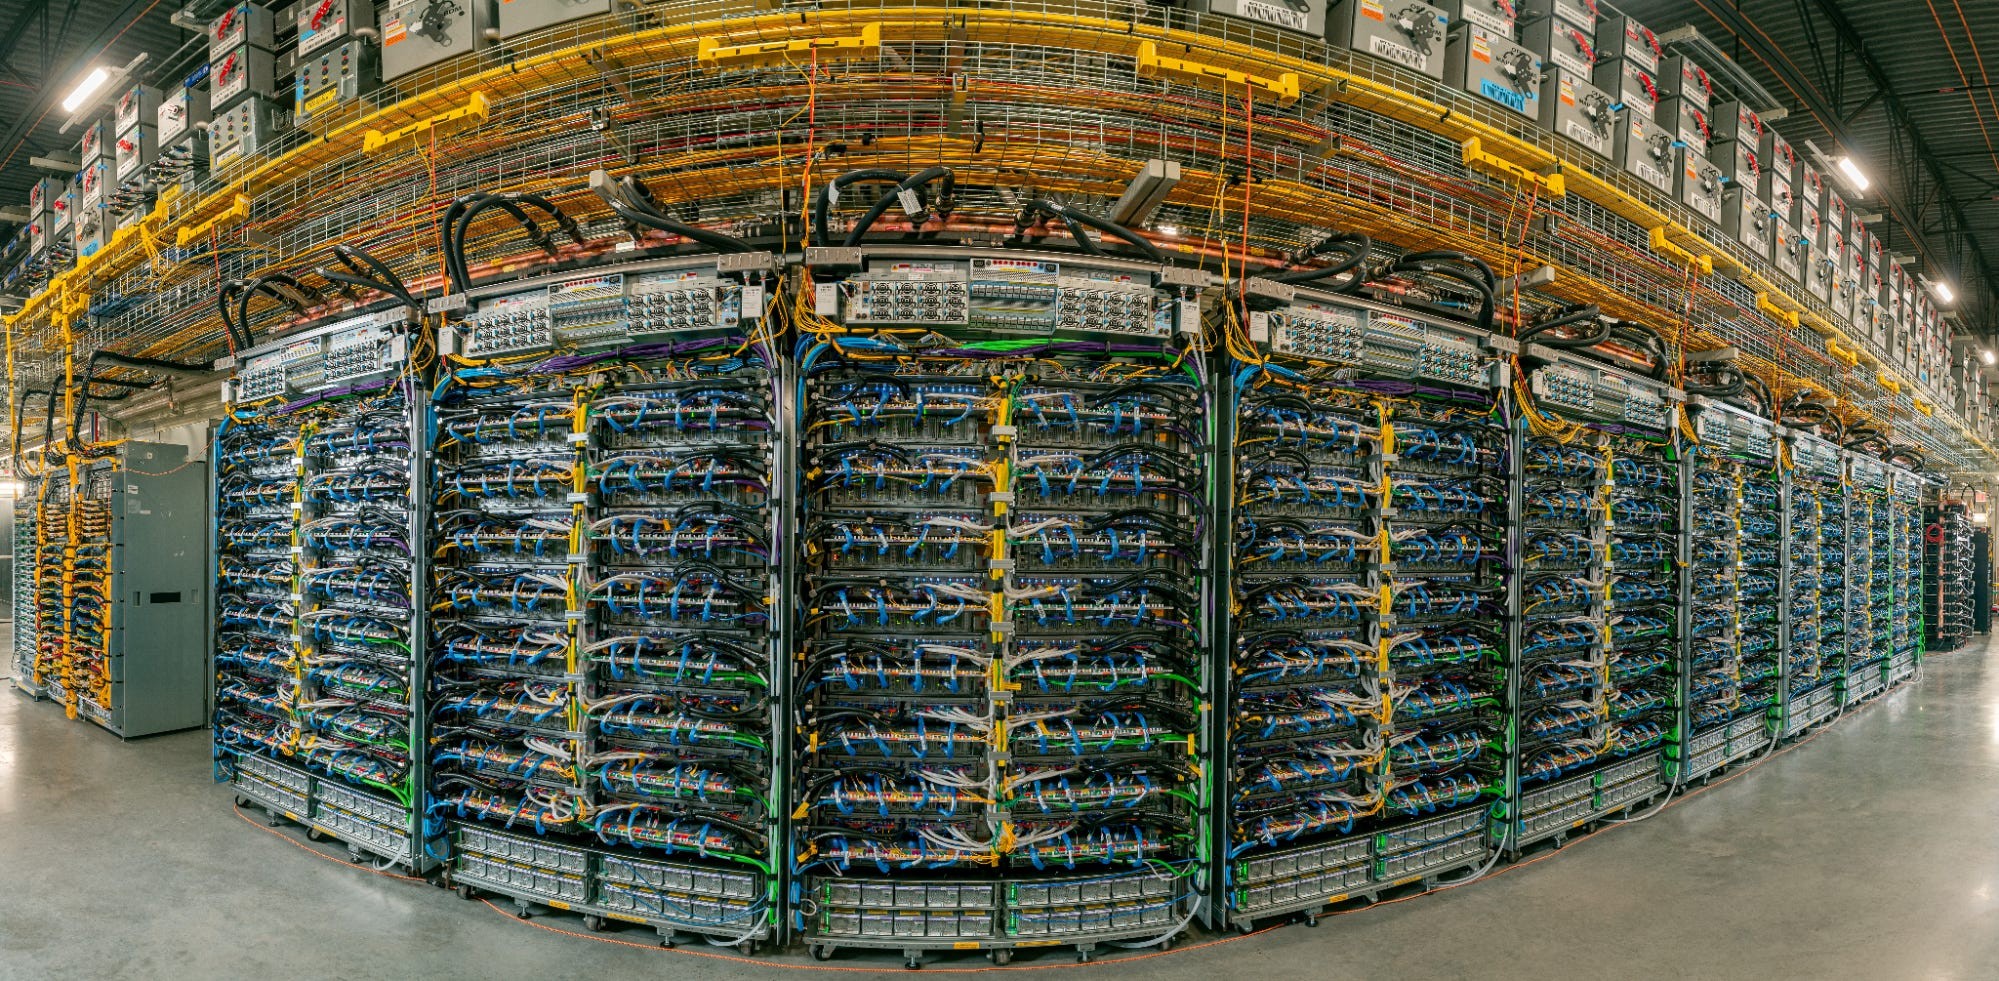
谷歌TPU打GPU这套打法精准狠 — 深挖谷歌如何挖英伟达CUDA墙角
谷歌 TPU v7 Ironwood 以专用架构 + 3D Torus 互联 + OCS 光交换,
从硬件到软件全面挑战英伟达 GPU 霸权。
OpenAI 和 Anthropic 为什么纷纷采用谷歌 TPU?谷歌 TPU 到底有什么独门绝技?
本期视频深入解析谷歌 TPU 的核心技术:OCS 光路交换、ICI 芯片间互联、3D Torus 拓扑结构,
以及谷歌如何从软件层面瓦解 CUDA 生态壁垒。
从硬件架构到商业策略,一口气看懂谷歌 TPU 如何挑战英伟达 GPU 霸权。
视频七个核心章节一览
视频中最核心的 8 个技术洞察
从 2015 年 TPU v1 到 2025 年 TPU v7 Ironwood
推理专用芯片,首次用于 Google 搜索 RankBrain
首次支持训练,引入 BF16 格式
液冷散热,算力翻倍,Pod 规模扩大
引入 OCS 光交换,10x 性能提升
成本优化版,广泛部署于 Google Cloud
能效比提升 67%,Pod 算力突破 ExaFLOPS
4,614 TFLOPS / 192GB HBM / 7.2 TB/s 带宽
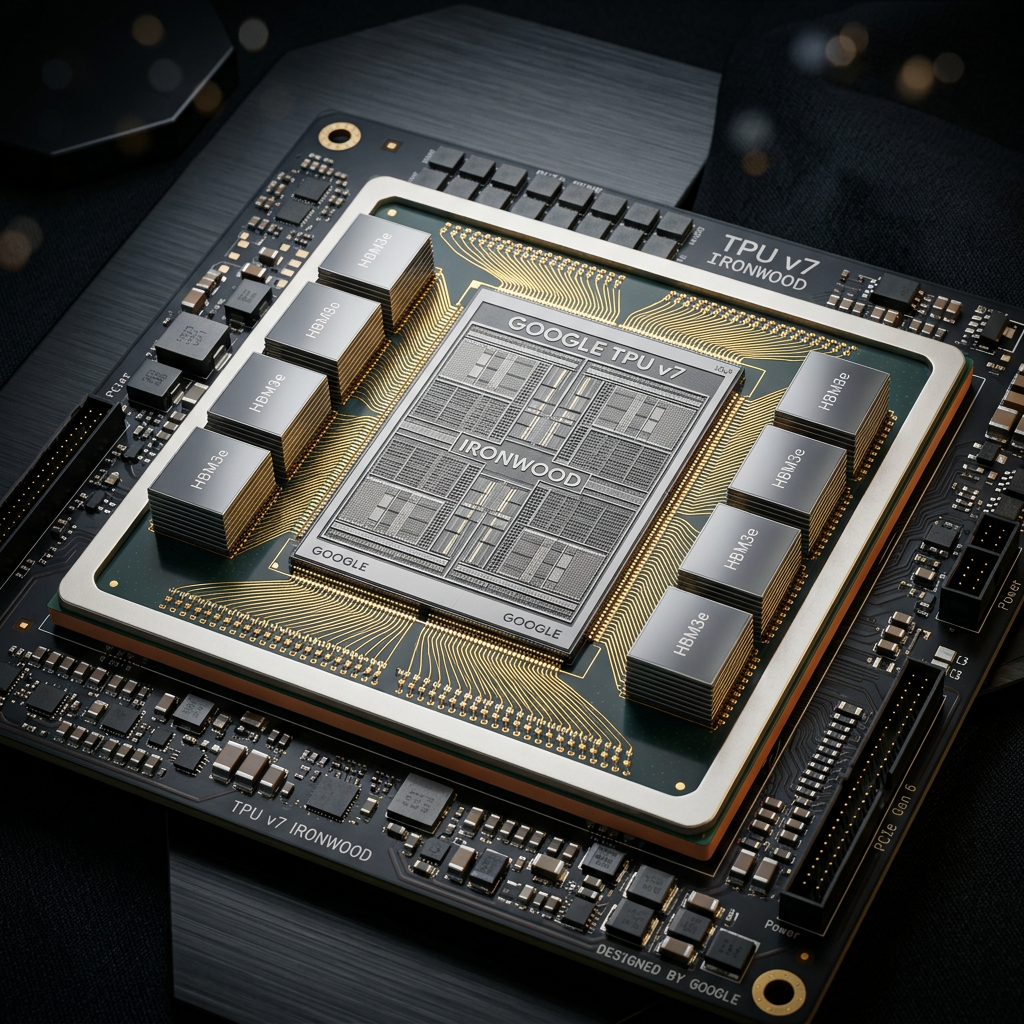
Ironwood 单芯片参数一览
TPU v7 Ironwood AI 加速器芯片架构图
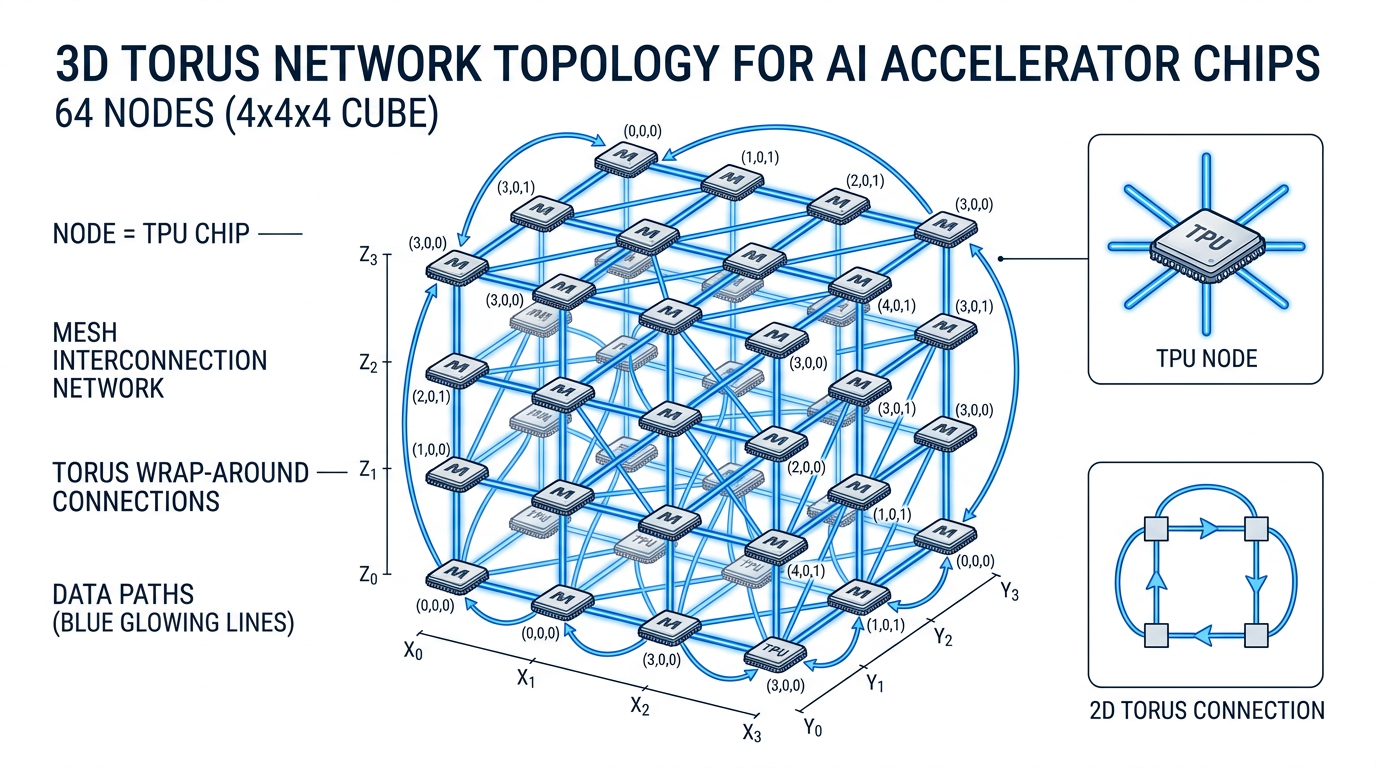
4x4x4 Cube = 64 颗 TPU,每颗 6 条 ICI 链路
3D Torus 拓扑结构示意图:4x4x4 Cube = 64 颗 TPU 全互联
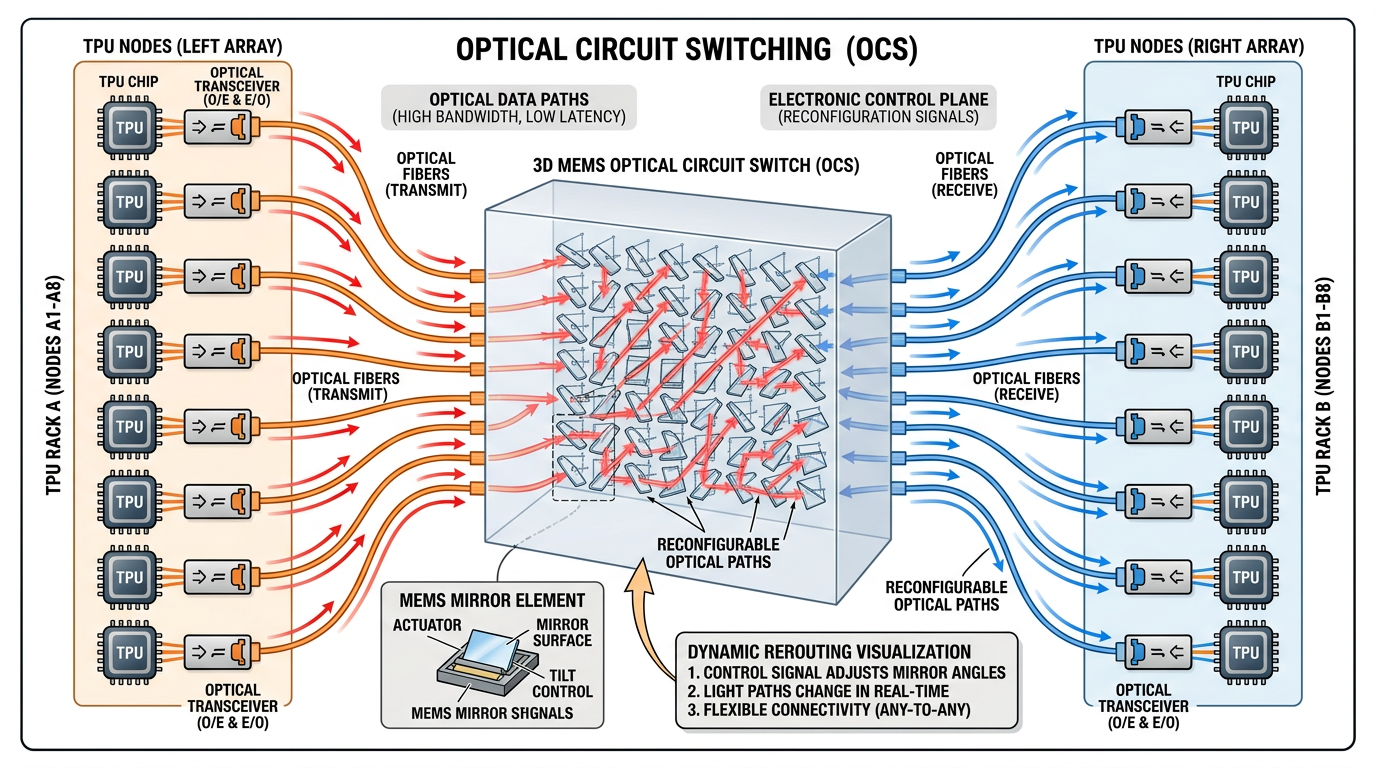
MEMS 微镜阵列实现毫秒级动态拓扑重构
OCS 光路交换架构:MEMS 微镜阵列实现动态拓扑重构
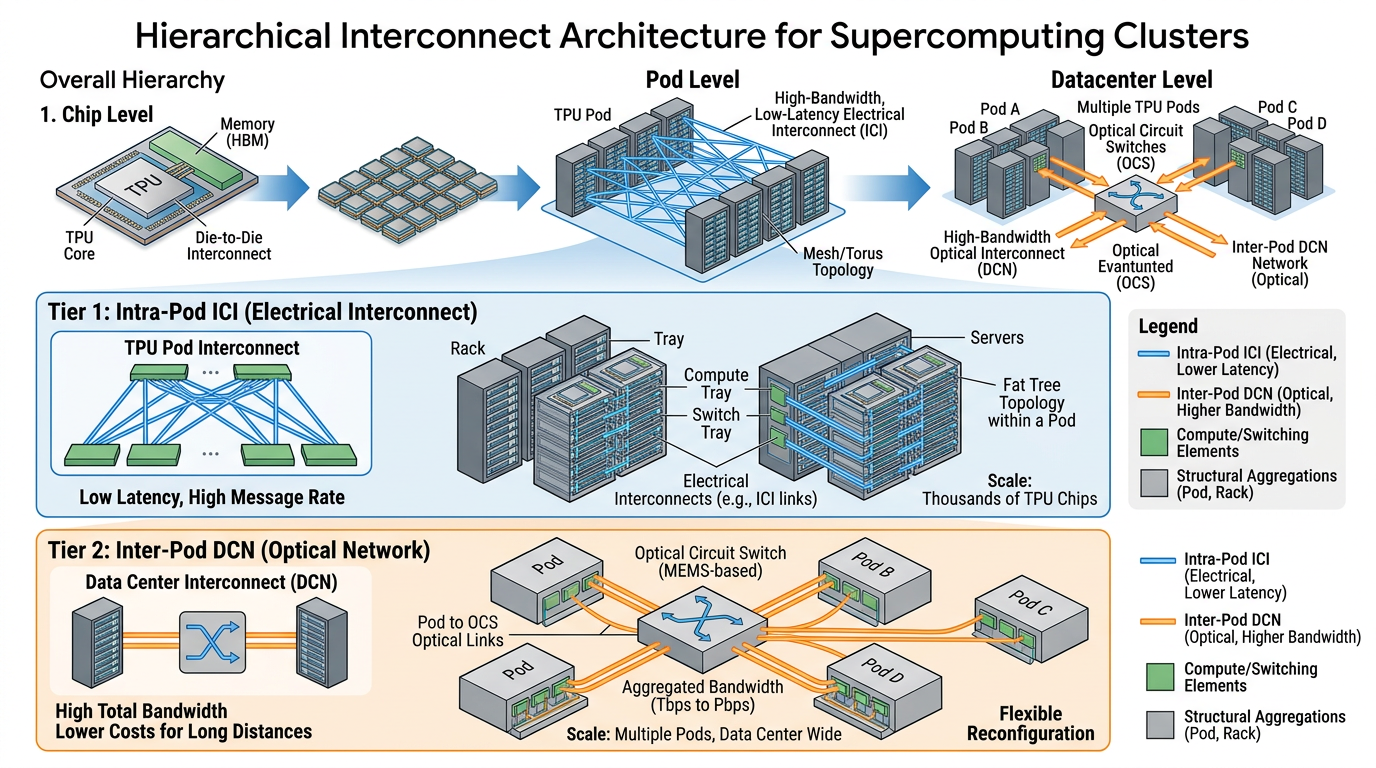
两层互联架构支撑百万颗 TPU 协同计算
两层互联架构:从 ICI Pod 到 DCN 超级集群的扩展方案
专用 ASIC 路线 vs 通用 GPU 路线
| 对比维度 | ☀ TPU (ASIC) | ⚡ GPU (通用) |
|---|---|---|
| 设计哲学 | 专注 AI 矩阵运算 | 兼顾图形/科学/AI |
| AI 能效比 | 极高(专用晶体管) | 一般(需兼顾通用) |
| 通用性 | 仅限 AI 工作负载 | 图形/科学/编码全场景 |
| 互联架构 | 3D Torus + OCS 动态重构 | NVLink/NVSwitch 固定拓扑 |
| 软件生态 | XLA/JAX/部分PyTorch | CUDA 百万开发者 |
| 单位 TCO | 约低 52% | 较高 |
| 规模能力 | 单 Pod 9,216 颗 | 集群规模受限 |
TPU集群
视频七个章节的完整深度解析
谷歌早在 2013 年就开始布局自研 AI 芯片,当时内部预测如果每个用户每天使用 3 分钟语音搜索,就需要将数据中心规模翻倍。这一判断促使谷歌走上了 TPU(Tensor Processing Unit)的自研之路。
从 TPU v1(2015年,推理专用)到如今的 TPU v7 Ironwood(2025年),谷歌已经迭代了七代产品。每一代都在算力密度、互联带宽、能效比上实现跨越式提升。TPU 不仅服务于谷歌内部(搜索、YouTube 推荐、Gemini 大模型),还通过 Google Cloud 对外提供服务。
TPU v7 代号 Ironwood,是谷歌 2025 年发布的最新一代 TPU,专为大规模 AI 训练和推理设计。其核心规格令人瞩目:
相比上一代 Trillium(TPU v6),Ironwood 的峰值算力提升近 5 倍。这种跨代飞跃得益于更先进的制程工艺、更大的 die size,以及架构层面对矩阵乘法单元(MXU)的深度优化。
Ironwood 的设计哲学是"为规模而生"——单芯片性能固然重要,但真正的竞争力在于数千颗芯片协同工作时的整体效率。这就引出了 TPU 最核心的技术创新:互联架构。
TPU 集群采用 4x4x4 的 3D Torus(三维环面)拓扑结构,64 颗 TPU 组成一个 Cube(立方体)。在这种拓扑中,每颗 TPU 有 6 条 ICI 链路 分别连接 X、Y、Z 三个维度上的相邻节点。
OCS(Optical Circuit Switch,光路交换) 是 TPU 互联的另一大杀器。OCS 使用 MEMS(微机电系统)微镜阵列,通过精确控制微镜角度来改变光信号的路由路径。
OCS 的革命性在于:传统数据中心改变网络拓扑需要人工重新插拔光纤,而 OCS 可以在毫秒级别动态重构连接关系。这意味着:
这种"软件定义互联"的能力,是英伟达 NVLink/NVSwitch 体系目前不具备的。
谷歌的 TPU 互联体系分为两层:
ICI(Inter-Core Interconnect,芯片间互联):这是 TPU 之间的直连高速通道,带宽 1.2 TB/s,延迟极低。通过 ICI + 3D Torus + OCS,单个 Pod 可以容纳 9,216 颗 TPU,形成一个逻辑上的"超级计算机"。
DCN(Data Center Network,数据中心网络):当单 Pod 不够用时,DCN 将多个 Pod 连接起来。通过 DCN,最多可以将 147,456 颗 TPU 组成一个超级集群,总算力达到惊人的 680 ExaFLOPS。
这种分层架构的设计智慧在于:ICI 层保证了 Pod 内部的超低延迟通信(适合模型并行),DCN 层则提供了跨 Pod 的大带宽连接(适合数据并行和流水线并行)。
TPU 和 GPU 代表了两种截然不同的芯片设计哲学:
TPU(ASIC 路线):专为 AI 矩阵运算设计,没有图形渲染单元,没有通用计算核心。所有晶体管都服务于 Tensor 运算。优势是能效比极高、单位面积算力密度大;劣势是只能做 AI,不能跑 CUDA 通用程序。
GPU(通用路线):英伟达的 GPU 既能做 AI 训练,也能做图形渲染、科学模拟、视频编解码。CUDA 生态覆盖了几乎所有计算场景。优势是通用性强、生态完善;劣势是为了兼顾多场景,AI 专项效率不如 TPU。
但 GPU 的护城河在于 CUDA 生态——全球数百万开发者、数万个优化库、几乎所有 AI 框架的首选后端。这不是单纯靠硬件性能就能颠覆的。
谷歌深知,光有好硬件不够,必须解决软件生态问题。为此,谷歌在多个层面发力:
PyTorch 代码几乎无需修改即可在 TPU 上运行,直接降低迁移门槛
主流 LLM 推理框架已支持 TPU 后端,开发者无需重写推理代码
对标 CUDA Kernel 的底层编程接口,允许编写高性能自定义算子
谷歌自研框架,函数式编程 + 自动微分,DeepMind 首选方案
谷歌的策略是"两条腿走路":一方面让现有 PyTorch 用户低成本迁移,另一方面用 JAX 培养原生 TPU 开发者群体。
2025 年,Anthropic 与谷歌达成了超过 100 万颗 TPU 的合作协议,这是 TPU 商业化的里程碑事件。Anthropic 选择 TPU 的主要原因:
每有效 PFLOP 成本显著低于 GPU 方案
单 Pod 9,216 颗 TPU 的超大规模集群能力
不受英伟达产能限制,供应稳定
与谷歌合作优化特定工作负载
2026年4月,谷歌在 Google Cloud Next 大会上正式发布第八代 TPU,**首次将训练和推理彻底拆分为两颗独立芯片**——这是 TPU 产品十年来最重大的架构转向。
不经常来,但一来就是排山倒海。一次前沿模型训练持续数周,横跨万卡规模
Agent 爆发后暴涨万倍(英伟达数据:两年增长100倍),混合专家模型路由工作极度频繁
| 制程 | 台积电 2nm |
| 单芯片 FP4 算力 | 12.6 PFLOPS |
| HBM 显存 | 216 GB HBM3e |
| 显存带宽 | 6.5 TB/s |
| 集群规模 | 单 Pod 9,600 颗,超集群 >100万颗 |
| ICI 带宽 | 较上一代提升 2 倍 |
| 横向扩展带宽 | 100Gbps → 400Gbps |
| 每瓦性能 | 较 Ironwood 提升 +124% |
| 性价比 | 较 Ironwood 提升 2.8 倍 |
专门处理嵌入查找中不规则的内存访问模式,将数据依赖的全局聚合操作从矩阵乘法单元(MXU)中卸载,避免通用芯片常见的零操作瓶颈。
通过 4 位浮点数将 MXU 吞吐量翻倍,同时降低数据搬运能耗,使更大的模型层可驻留于本地硬件缓冲区。
使量化、softmax 等向量操作与矩阵乘法实现更好的流水线重叠,提升芯片整体利用率。
| 制程 | 台积电 2nm |
| 片上 SRAM | 384 MB(Ironwood 的 3 倍) |
| 片外 HBM | 288 GB |
| 内存带宽 | TPU 8t 的 1.3 倍 |
| Pod 规模 | 256 → 1,152 颗(提升 4.5 倍) |
| 每 Pod FP8 算力提升 | 8.67 倍 |
| 每 Pod HBM 容量提升 | 5.74 倍 |
| 每瓦性能 | 较 Ironwood 提升 +117% |
| 性价比 | 较 Ironwood 提升 +80% |
384MB SRAM = Ironwood 的 3 倍,可完全在硅片上容纳更大的 KV 缓存,显著减少长上下文解码期间内核的空闲时间,尤其适合大规模 MoE 模型的低延迟目标。
| 最大通信跳数 | 16 跳 → 7 跳(减少 56%) |
| 网络直径 | 缩减 56% |
| 全对全通信延迟 | 改善 最高 50% |
完美适配混合专家模型(MoE)和推理模型中频繁的跨芯片令牌路由需求。
运行时数据无需访问外部存储,有效打破"内存墙"瓶颈。
设计哲学:算力密度 + 规模扩展
内存层级:216GB HBM3e
核心优势:更大模型层本地缓存
网络优化:Virgo (DCN 带宽 ×4)
扩展方向:纵向扩展 (superpod)
设计哲学:内存带宽 + 低延迟
内存层级:384MB SRAM + 288GB HBM
核心优势:更大 KV 缓存本地存储
网络优化:Boardfly (延迟 -50%)
扩展方向:横向扩展 (Pod 内低延迟)
百万级并发 Agent
均为 Ironwood 的 2 倍
消除主机侧瓶颈
统一软件栈
节能优化
训练芯片对标英伟达 Rubin,推理芯片对标英伟达 Groq 3。TPU 与 GPU 的竞争已从单纯的硬件性能,扩展到软件生态、供应链、商业模式的全方位较量。