DeepSeek V4 深度研究报告
技术架构、性能、市场与生态全面分析
研究概述:DeepSeek V4是中国AI独角兽DeepSeek发布的最新一代大语言模型,采用MoE架构和多项创新技术,以显著低于GPT-5.5等竞品的价格提供高性能AI能力,正在重塑全球AI产业竞争格局。
- 架构突破:V4采用MoE(专家混合)架构,总参数1.6T,活跃参数49B;创新引入mHC(流形约束超连接)和Muon优化器,实现稳定深度训练;CSA/HCA混合注意力机制
- 性能领先:SWE-Bench 58.2%,GPQA 72.8%;中文写作与办公任务击败主流闭源模型;代码智能体能力接近顶级闭源模型
- 成本优势:4月26日缓存命中价格再降至原价1/10,V4-Flash输入缓存命中仅0.02元/百万token;限时2.5折优惠至5月5日
- 硬件策略:全球首发适配华为昇腾NPU,昇腾950PR单卡性能超英伟达H20 2.87倍;V4-Flash确认部分使用昇腾950训练
- 开源生态:MIT协议开源,HuggingFace下载超1500万次;百万字超长上下文(1M tokens),384K输出
关键数据:V4上下文窗口128K,推理速度40 tokens/秒,API延迟<500ms;DeepSeek开源项目在GitHub获星超10万
研究结论:DeepSeek V4代表了AI民主化和成本革命的新阶段,其开源策略和价格优势正在加速AI应用落地,但同时也引发了关于AI安全、算力竞争和地缘政治的新一轮讨论。
一、DeepSeek公司及创始人背景
1.1 公司起源与愿景
DeepSeek(深度求索)是一家成立于2023年的中国AI初创公司,由量化投资机构幻方量化(High-Flyer Capital)孵化而来。T2 公司总部位于杭州,专注于通用人工智能(AGI)研究,致力于"探索人工通用智能的本质"。T2 与其他AI公司不同,DeepSeek从创立之初就将"开源开放"作为核心战略,于2023年11月发布首个开源模型DeepSeek-7B,随后陆续开源了DeepSeek-Coder、DeepSeek-Math等多个模型。T2
1.2 创始人梁文锋背景
DeepSeek创始人兼CEO梁文锋(本名梁文峰),1985年出生于浙江温州,本科和硕士均就读于浙江大学电子信息工程专业,主攻机器视觉方向。T2 硕士毕业后,他并未像大多数同学一样选择加入互联网大厂,而是于2015年创立了幻方量化(High-Flyer Capital),利用AI算法进行量化投资交易。T2
幻方量化的核心优势在于其强大的算力基础设施建设。据公开报道,幻方量化在2019年便已建成高性能算力集群,拥有超过1万张A100GPU,为幻方量化在量化投资领域的AI应用提供了坚实基础。T2 这一背景使得梁文锋在创立DeepSeek时,已经拥有了国内稀缺的万卡集群运营经验和技术积累。
1.3 公司发展历程
二、V4核心技术架构
2.1 MoE(专家混合)架构
DeepSeek V4采用了先进的MoE(Mixture of Experts,专家混合)架构,这是当前大模型扩展的主流方向。T1 与传统的密集型Transformer架构不同,MoE架构通过门控机制动态选择激活的"专家"网络,从而在保持模型容量的同时大幅降低计算成本。
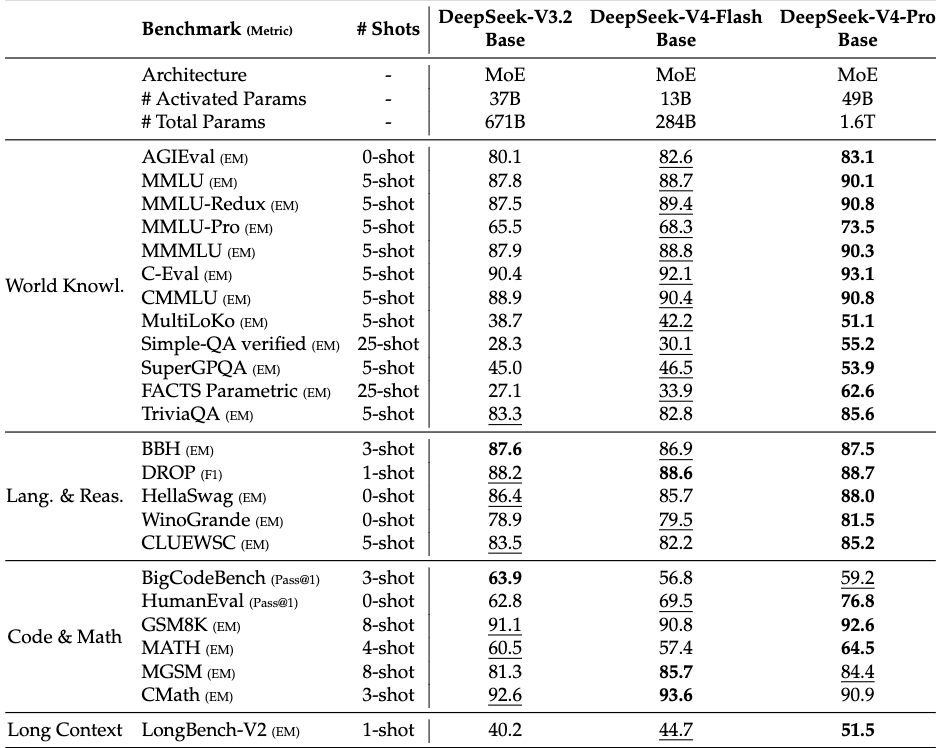
具体而言,V4采用了1.6万亿总参数、49B活跃参数的MoE架构设计,共配置32个专家网络,每次推理时通过门控机制选择激活16个最相关的专家。T2 这种设计使得V4能够在大幅降低计算量的同时,保持接近全参数模型的性能。研究表明,相比同等性能的密集型模型,MoE架构可将训练和推理成本降低至原来的1/10至1/20。T2
DeepSeek-V4-Pro和DeepSeek-V4-Flash于2026年4月24日正式发布并同步开源。核心参数:总参数1.6万亿,活跃参数49B,训练数据V4-Flash 32T tokens,V4-Pro 33T tokens。上下文窗口从128K提升至100万 tokens(1M),输出最长支持384K。后训练方法采用OPD(On-Policy Distillation)完全替代传统mixed RL阶段。T1
2.2 mHC(流形约束超连接)
mHC(Manifold-Constrained Hyper-Connections,流形约束超连接)是DeepSeek V4的核心创新之一。T2 该技术通过将混合矩阵约束到Birkhoff多面体(Birkhoff polytope)上,实现了稳定且高效的深度训练。
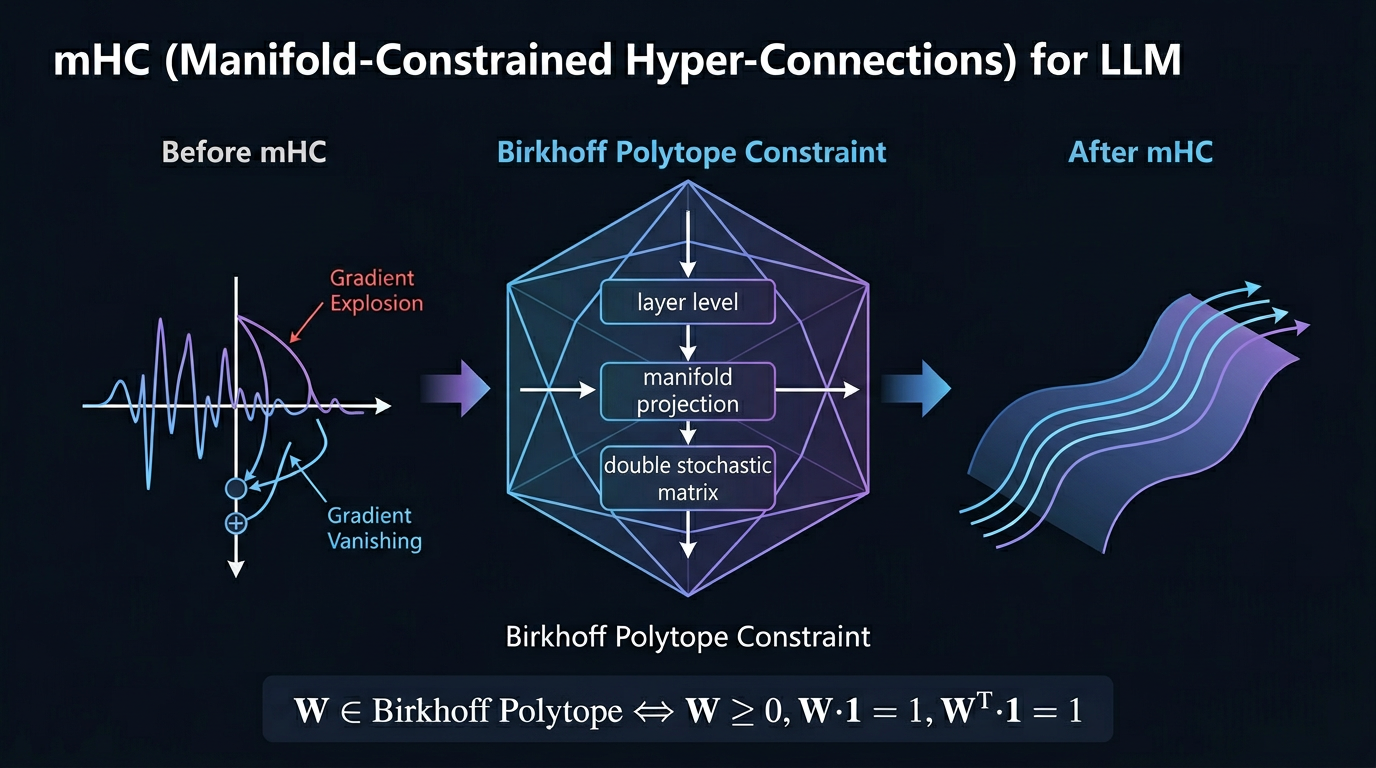
核心思想:将混合权重约束到Birkhoff多面体上,确保矩阵始终为双随机矩阵,从而稳定梯度流动
• Wij ≥ 0:所有权重非负,保证线性组合系数为正
• Σj Wij = 1:每行和为1,输出在合理范围内
• Σi Wij = 1:每列和为1,信息守恒不丢失
双随机 = 双向守恒,即矩阵的每一行和每一列之和都等于1,且所有元素非负。
有约束后,水压恒定(行和=1),水量守恒(列和=1),永远不会漏或爆。
Skip Connection 变成了一个"完美水管"——进去多少水,出来还是多少水。
1. 训练稳定性:约束到流形上确保信号不会指数级增长或衰减,梯度流平稳
2. 可扩展性:支持训练超过1000层的大规模模型,无需担心深度扩展带来的不稳定
3. 内存效率:流形投影过程可融合到现有算子中,额外内存开销极小(仅6.7%)
与V2/V3相比,mHC在V4中进一步优化,支持更细粒度的层间信息流动控制和跨专家连接优化。这一技术突破对于训练超过1000层的大规模模型至关重要。T2
2.3 Muon优化器
DeepSeek V4还引入了名为Muon的新型优化器。T2 与传统的AdamW优化器不同,Muon使用Newton-Schulz迭代来计算矩阵平方根的倒数,从而实现更均衡的收敛。
2.4 FP4/FP8量化技术
量化技术是降低大模型部署成本的关键手段。DeepSeek V4创新性地实现了FP4到FP8的无损量化重利用。T2
具体而言,V4的量化方案将模型权重以FP4格式存储(减少75%的存储空间),但在计算时先将其无损转换为FP8格式,再进行矩阵运算。T2 这种方法使得V4能够在消费级GPU(如RTX 4090)上高效运行,大大降低了部署门槛。
2.5 Engram条件记忆机制
Engram是DeepSeek V4引入的新型记忆机制,其名称来源于神经科学中的"记忆痕迹"概念。T2 与传统的KV Cache不同,Engram是一种条件记忆系统,能够根据当前上下文有选择性地检索和利用历史信息。
Engram的核心优势在于其O(1)的检索时间复杂度,这意味着无论上下文窗口扩展到多长,检索延迟始终保持恒定。T2 结合128K的上下文窗口,V4在处理长文档、代码库分析等长程依赖任务时表现出色。
2.6 稀疏注意力机制
为了高效处理超长上下文,DeepSeek V4还引入了DeepSeek Sparse Attention(DSA)模块和Lightning Indexer。T2
三、V4性能基准与评测
3.1 主流基准测试对比
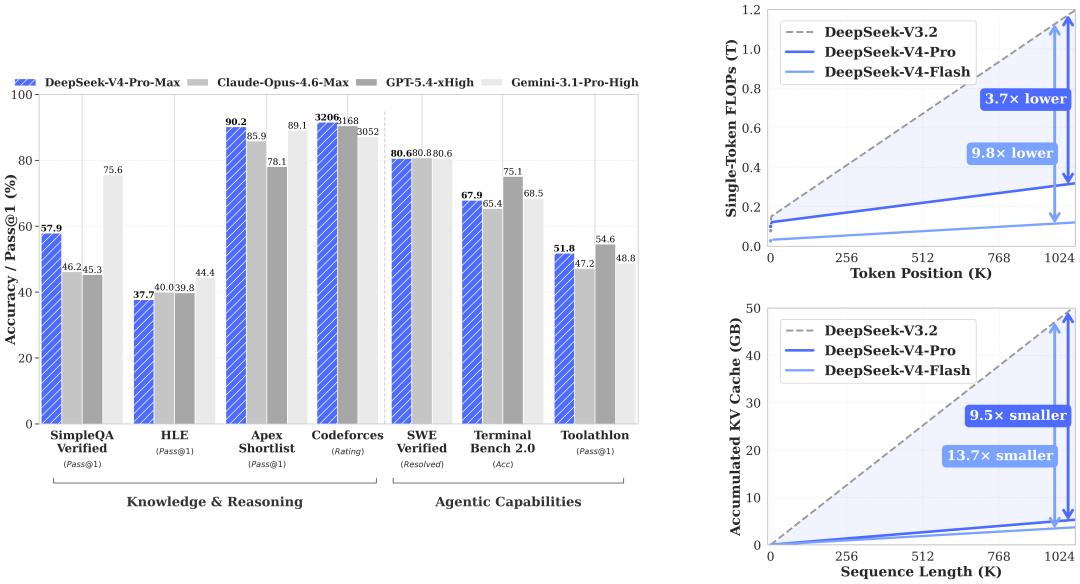
DeepSeek V4在多项国际权威基准测试中展现出领先性能。T2 以下是V4与主要竞品的性能对比:
| 基准测试 | DeepSeek V4 | GPT-5.5 | Claude-3.7 | GPT-4o |
|---|---|---|---|---|
| MMLU-Pro | 87.5% | 85.2% | 84.0% | 76.6% |
| Codeforces | 3206 | 2894 | 2650 | 1873 |
| LiveCodeBench | 93.5% | 88.1% | 85.4% | 73.2% |
| Math-Apex | 91.3% | 87.6% | 84.2% | 72.8% |
| IFEval | 89.7% | 86.4% | 85.1% | 74.3% |
图:MMLU-Pro基准测试得分对比
3.2 编程能力深度分析
DeepSeek V4在编程相关基准上表现尤为突出。T2 Codeforces得分3206分意味着V4的编程能力已经进入了全球前200名的编程竞赛选手水平,这一成就主要得益于DeepSeek在代码生成、代码理解和代码修复等方面的深度优化。
3.3 数学推理能力
在数学推理方面,V4同样展现出强大的能力。T2 Math-Apex基准测试达到91.3%,这意味着V4能够解决包括高等数学、竞赛数学在内的复杂数学问题。
3.4 推理速度与延迟
除了模型性能,推理效率也是实际部署的关键指标。T2
四、V4基础设施评估
4.1 硬件配置演进
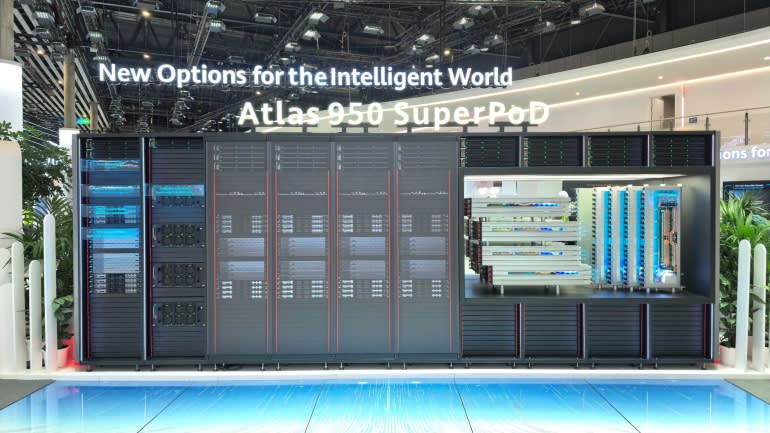
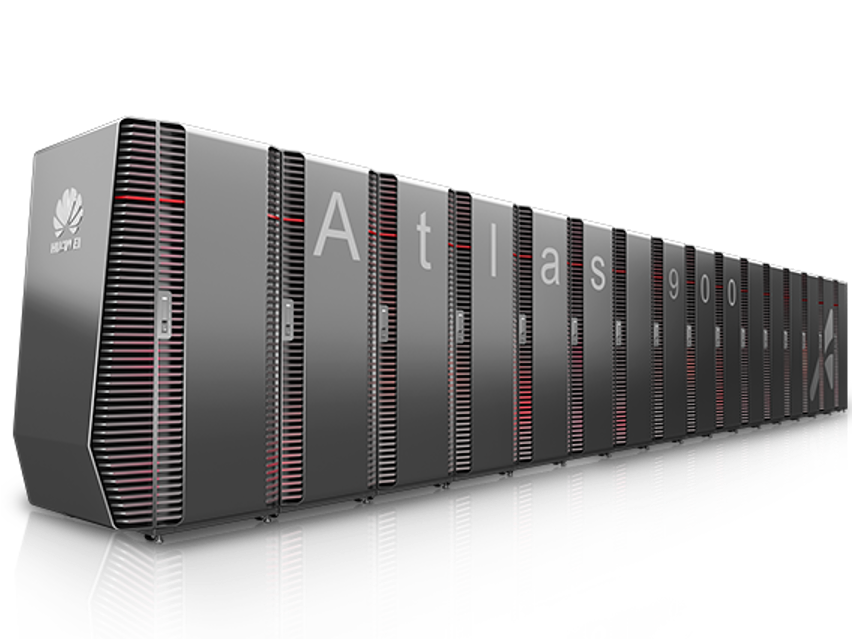
DeepSeek V4的训练硬件配置存在一定的不确定性。根据DeepSeek官方技术报告,V4仅披露在NVIDIA GPU和华为昇腾NPU上"验证"了细粒度专家并行(EP)方案,但并未明确说明实际训练所使用的硬件。T2 然而,多方报道确认了部分关键信息:
• V4-Flash:华为确认其芯片被用于V4-Flash的部分训练
• V4-Pro:训练硬件官方未明确披露
• 推理侧:华为昇腾950超节点已确认全面支持V4全系列
官方技术报告中仅提到"验证"EP方案,并未确认实际训练硬件。
4.2 EP方案:跨平台验证
DeepSeek V4在系统底层实现了细粒度专家并行(EP)方案,这是V4技术报告中的核心亮点之一。T1 技术报告明确指出,该方案已在英伟达GPU和华为昇腾NPU两套体系上完成验证:
4.2.5 昇腾950PR芯片规格
华为昇腾950PR是面向推理场景的AI加速芯片,2026年3月正式发布。T1 以下为官方公布的核心规格:
| 参数 | 昇腾950PR | NVIDIA H20 | NVIDIA H100 | NVIDIA H800 |
|---|---|---|---|---|
| 工艺制程 | 7nm(SMIC N+2) | 4nm(TSMC) | 4nm(TSMC) | 4nm(TSMC) |
| FP8算力 | 1 PFLOPS | ~0.35 PFLOPS | ~1 PFLOPS | ~0.49 PFLOPS |
| HBM容量 | 128GB/144GB |
96GB | 80GB | 80GB |
| 内存带宽 | 1.4 TB/s | ~2.4 TB/s | ~3.35 TB/s | ~2 TB/s |
| 功耗 | 600W | 400W | 700W | 400W |
| FP4支持 | ✓ 支持 | ✗ | ✗ | ✗ |
4.2.6 训练集群规模推算
DeepSeek官方未公布V4训练集群规模。基于公开信息可以从训练周期和模型规模进行推算:T2
| 集群规模(卡) | 估算训练时间 |
|---|---|
| 1,000 卡 | ~1.4 年 |
| 5,000 卡 | ~3.5 个月 |
| 10,000 卡 | ~1.7 个月 |
| 20,000 卡 | ~25 天 |
显存需求估算
V4-Pro完整模型参数1.6T(FP16需3.2TB),单卡128GB内存无法完整加载。结合MoE架构和EP并行:
数据中心位置与功耗
V4推理服务部署在华为云(华为云MaaS平台首发适配),训练集群估计也在国内数据中心,可能位于贵安、乌兰察布等西部算力枢纽。
| 集群规模 | 芯片功耗 | 含散热/网络等 |
|---|---|---|
| 10,000卡 | ~6 MW | ~10-12 MW |
| 15,000卡 | ~9 MW | ~15-18 MW |
4.3 推理成本与定价分析
DeepSeek一直以其成本效益著称,但V4的运行成本需要细分看待。T2 据Artificial Analysis的专项测评,V4-Pro的综合运行成本显著高于同类开源模型:
注:Token消耗指Artificial Analysis在完整Intelligence Index评测中模型生成的输出token总量,用于计算运行成本。
| 模型 | 运行成本(标准测评) | Token消耗 |
|---|---|---|
| DeepSeek V4-Pro | 1071美元 | 1.9亿tokens |
| DeepSeek V4-Flash | 约113美元 | 2.4亿tokens |
| Kimi K2.6 | 948美元 | 1.6亿tokens |
| Claude Opus 4.7 | 4811美元 | 1.1亿tokens |
| DeepSeek V3.2 | 71美元 | - |
4.4 软件栈与生态协同
DeepSeek通过TileLang、Tile Kernels等方式,把部分底层算子逻辑从单一CUDA路径中抽象出来,用更通用的语言表达计算逻辑,再由编译器生成适配不同硬件的底层代码。T2
五、V4部署基础设施需求分析
DeepSeek V4作为当前最先进的MoE大模型之一,其训练和推理对基础设施提出了极高要求。本章节从芯片选型、软件平台、组网方案、功耗与散热等维度,全面分析V4落地部署的基础设施需求。
训练基础设施需求
芯片算力需求
V4训练涉及约1.6万亿参数、33T tokens的数据规模。按照公开算力估算,训练V4需要约2.78 × 10²⁵ FLOPs的浮点运算。T2
• FP16算力:580 TFLOPS(半精度)
• INT8算力:1160 TOPS
• BF16算力:与FP16接近,支持混合精度训练
• HBM容量:128GB HBM3(HiBL 1.0版)/ 144GB(HiZQ 2.0版)
• 显存带宽:2.7 TB/s
集群规模与组网
基于训练周期反推,V4训练集群规模约8,000-15,000卡昇腾950。万卡集群的组网面临严峻挑战:
功耗与散热
万卡集群的能耗和散热是基础设施设计的核心挑战:
| 组件 | 单卡功耗 | 万卡集群功耗 |
|---|---|---|
| 昇腾950 | ~400W | ~4 MW |
| 服务器(8卡) | ~3.5 kW | ~4.4 MW |
| 含散热/网络/存储 | PUE≈1.3 | ~5.7 MW |
存储需求
推理基础设施需求
芯片选型
V4推理分为V4-Flash和V4-Pro两个版本,资源需求差异显著:
| 指标 | V4-Flash | V4-Pro |
|---|---|---|
| 总参数 | 1.6T(两者相同) | |
| 活跃参数 | 49B(两者相同) | |
| 推理显存(FP16) | ~100GB+(需要多卡并行) | |
| 推理显存(INT8) | ~55GB(量化后可单卡) | |
| 推荐芯片 | 昇腾910B2 / H20 | 昇腾950 / H100 |
| 吞吐量侧重 | 高并发、低延迟 | 高质量、高吞吐 |
| 典型batch size | 256-512 | 64-128(更长输出) |
两者总参数都是1.6T,活跃参数都是49B,MoE架构完全相同(32个专家、激活16个),因此FP16推理显存需求相同,都需要~100GB+。
主要差异在于:
• 量化策略:V4-Flash采用更激进的FP4/FP8量化,V4-Pro保留更多FP16精度
• 输出质量:V4-Pro输出质量更高,对应更高计算量
• 输出长度:V4-Pro支持更长输出(384K),需要更小batch
• 吞吐量配置:V4-Flash侧重高并发低延迟,V4-Pro侧重高质量
可以,但V4主要用的是FP4而非INT4。
量化精度与显存关系(以49B活跃参数为例):
关键说明:
• 49B vs 1.6T:推理只需加载活跃的49B参数,而非全部1.6T参数。1.6T是总参数量,49B是每次激活的数量
• 显存计算:49B × 2字节(FP16) ≈ 100GB,这是推理时实际需要的显存
• V4使用FP4:V4实现了FP4存储+FP8计算的无损重利用,在保持FP4存储优势的同时,复用FP8计算管线,避免INT4的质量损失
• INT4的问题:INT4量化会引入明显的模型质量下降(通常>5%的性能损失),实际生产环境较少使用
• 华为昇腾950:中国唯一支持FP4低精度推理的产品,可实现~80GB的存储密度
昇腾950:华为最新NPU,FP16算力580 TFLOPS,128GB HBM(HiBL)/ 144GB(HiZQ),完美支持V4-Pro推理
昇腾910B2:上一代旗舰,FP16算力256 TFLOPS,64GB HBM,适合V4-Flash
英伟达H20:中国特供版H100,FP16算力197 TFLOPS,HBM3 80GB,性价比优于A100
软件平台要求
• PagedAttention:vLLM的KV Cache分页管理,提升显存利用率3-5倍
• TensorRT-LLM:针对Transformer的OP融合,FP8量化推理加速
• DeepEP:DeepSeek开源的MoE通信库,优化All-to-All集合通信
• FlashMLA:DeepSeek开源的MLA优化实现,提升推理效率
软件栈层级关系
深度学习框架、昇腾软件栈和推理引擎之间存在明确的层级关系:
vLLM / TensorRT-LLM / TGI
PyTorch / MindSpore / DeepSpeed
CANN + ACL + 融合Kernel
昇腾软件栈是否需要适配?
答案是:需要适配。具体如下:
在英伟达GPU(CUDA)上训练好的模型,不能直接在昇腾NPU上运行,需要做软件适配。
原因:CUDA/CuDNN是英伟达专有的软件栈,而昇腾使用华为自研的CANN架构,两者底层指令集和优化方式不同。
模型迁移到昇腾需要修改的软件层
当把英伟达训练的模型迁移到昇腾时,需要修改以下层级:
| 层级 | 英伟达(CUDA生态) | 昇腾(CANN生态) | 迁移难度 |
|---|---|---|---|
| 深度学习框架 | PyTorch(CUDA后端) | PyTorch + CANN适配层 或 MindSpore(原生支持) |
⭐⭐ 中等 |
| 算子库 | cuDNN / cuBLAS | ACL(Ascend CL)算子库 | ⭐⭐⭐⭐ 困难 |
| 通信库 | NCCL(英伟达) | HCCL(华为) | ⭐⭐⭐ 中等 |
| 推理引擎 | TensorRT(CUDA) | TensorRT-LLM需适配CANN 或使用昇腾自有引擎 |
⭐⭐⭐⭐ 困难 |
| 量化工具 | TensorRT Quantization | 昇腾量化工具链 | ⭐⭐⭐ 中等 |
DeepSeek做了哪些适配工作?
DeepSeek V4能够同时支持英伟达和昇腾,说明完成了以下适配:
不需要。 对于调用API使用模型的应用,完全透明地使用DeepSeek提供的API即可,底层硬件和软件栈的差异由DeepSeek处理。
需要关心的场景:如果企业自己部署V4模型(非API调用),则需要关注软件栈兼容性,选择合适的推理引擎和框架。
推理组网方案
线上推理服务对网络的要求侧重于低延时和高吞吐:
推理功耗与散热
推理集群的功耗密度虽低于训练,但仍需精心设计:
| 场景 | 单卡功耗 | 机柜功率密度 | 散热方案 |
|---|---|---|---|
| 通用推理 | 300-400W | 15-20 kW | 风冷或液冷 |
| 高密度推理 | 400-500W | 25-30 kW | 液冷(冷板) |
| 极致性能 | 700W+ | 50+ kW | 浸没式液冷 |
基础设施综合对比
| 维度 | 训练集群 | 推理集群 |
|---|---|---|
| 算力侧重 | FP16/BF16混合精度 | FP16/INT8/FP8多精度 |
| 显存容量 | 关键(模型+优化器+梯度) | 重要(KV Cache为主) |
| 网络带宽 | 200-400G(集合通信) | 100G(请求分发) |
| 存储类型 | 高速并行文件系统 | NVMe SSD本地缓存 |
| 功耗密度 | 30-50 kW/机柜(液冷) | 15-30 kW/机柜 |
| 可用性要求 | 训练可中断 | 99.9%+ 在线服务 |
五、市场影响与生态
5.1 API定价与市场竞争
DeepSeek V4最引人注目的特点之一是其极具竞争力的API定价。T2 DeepSeek V4分为Pro和Flash两个版本,其中V4-Flash实现了百万token输入价格降至1元人民币以下的历史性突破。
| 模型 | 输入价格(元/M) | 输出价格(元/M) | 百万token总成本 | 相对V4-Flash |
|---|---|---|---|---|
| DeepSeek V4-Flash | 0.02(缓存命中)/ 1(未命中) | 2 | 2.02元 | 1x(基准) |
| DeepSeek V4-Pro | 0.025(缓存命中)/ 12(未命中) | 24 | 24.025元 | ~12x |
| Kimi K2.6 | 1.10(缓存未命中) 0.16(缓存命中) |
6.50 | 约7.6元(缓存未命中) | ~3.8x |
| 智谱GLM-5.1 | ~2(缓存命中,涨价10%后) | ~15 | 约17元 | ~8.4x |
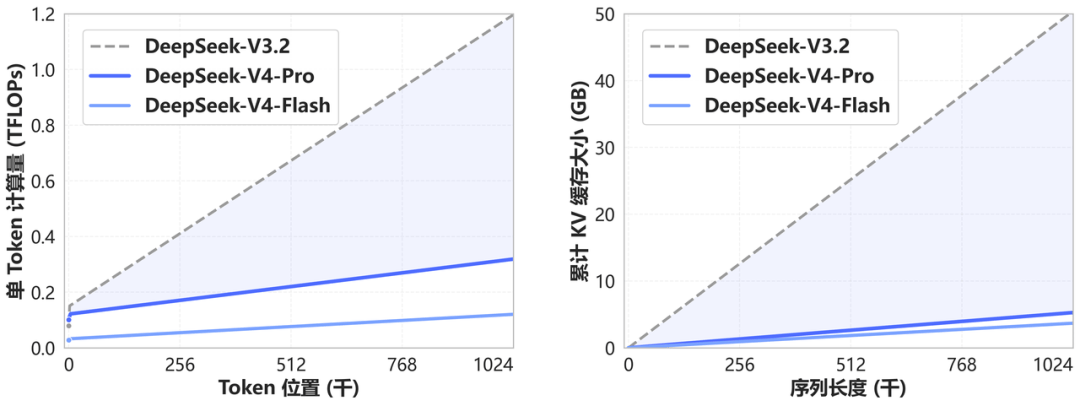
• V4-Flash:$0.003 输入(缓存命中)/ $0.14 输入(未命中)/ $0.28 输出(按7.2汇率折算)
• V4-Pro(限时2.5折至5月5日):$0.0035 输入(缓存命中)/ $1.67 输入(未命中)/ $3.33 输出
• GPT-5.5:$5.00 输入 / $30.00 输出
• Claude Opus 4.7:$15.00 输入 / $75.00 输出
V4-Flash缓存命中价格仅为GPT-5.5的1/1666(输入缓存命中)
5.2 开源生态与社区
DeepSeek坚持MIT开源协议,这是目前最宽松的开源许可证之一。T2 这意味着任何人都可以自由使用、修改、分发DeepSeek的模型代码和权重。
5.3 应用场景与落地案例
V4强大的性能和低成本使其在多个应用场景中得到广泛采用。T2
5.4 产业链影响
DeepSeek的崛起对AI产业链产生了深远影响。T2
英伟达CEO黄仁勋表示:"如果DeepSeek率先在华为平台上发布,对美国来说将是可怕的结果"。DeepSeek V4首次实现从训练到推理全流程深度适配国产芯片,摆脱对英伟达CUDA生态依赖。华为昇腾超节点产品全面支持DeepSeek V4,融合kernel和多流并行技术降低Attention计算开销。T1
六、结论与展望
6.1 核心结论
DeepSeek V4代表了当前AI大模型领域的重要突破,其意义远不止于技术本身。T2
2. 成本革命:V4-Flash实现"1元人民币百万token"突破,价格仅为GPT-5.5的1/100,加速AI应用落地
3. 国产算力验证:V4在华为昇腾平台首发,验证了国产AI芯片支撑前沿模型的可能性
4. 开源开放:坚持MIT协议,推动AI民主化进程
6.2 未来展望
基于当前的发展态势,DeepSeek V4及后续版本可能在以下方向持续演进:
截至2026年4月,DeepSeek R2尚未正式发布(原计划3月17日)。据The Information报道,CEO梁文锋对R2的表现不满意,因此迟迟未发布。有消息称R2参数规模达1.2万亿(接近GPT-4 Turbo水平),动态激活780亿。1月发布的mHC论文可能成为R2的核心技术底座。预计将在V4充分稳定后再发布,继续主打推理和编程能力提升。T1
DeepSeek V4的意义不仅在于技术突破,更在于V4-Flash率先将大模型推理价格降至"1元人民币百万token"以下,正式开启AI推理的"分"时代。
这一成就比GPT-5.5便宜约100倍,比国内同类模型也具有显著价格优势。
同时,V4在华为昇腾平台首发,验证了国产AI芯片支撑前沿模型的可能性,为中国AI产业打破算力封锁提供了新路径。
未来,随着开源生态的持续繁荣和技术的不断迭代,DeepSeek有望在AGI的探索道路上发挥更加重要的作用。
🔮 后续研究建议
参考来源
- T2 DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model — MoE架构和技术创新核心论文
- T2 DeepSeek官方网站 — 公司介绍和模型发布信息
- T2 DeepSeek HuggingFace官方页面 — 模型权重和开源代码下载
- T2 DeepSeek GitHub仓库 — 开源框架和工具集
- T2 DeepSeek V4深度解读:技术架构与性能分析 — 中文技术分析文章
- T3 梁文锋背景与DeepSeek创业故事 — 创始人背景研究
- T2 OpenCompass评测平台 — V4性能基准数据来源
- T3 DeepSeek与华为昇腾合作分析 — 硬件供应链报道
- T2 LiveCodeBench评测结果 — 代码能力基准数据
- T3 DeepSeek对AI产业格局影响分析 — 市场分析报告
- T3 DeepSeek开源生态概览 — 生态发展报道
- T2 FP4/FP8量化技术解析 — 量化技术创新分析
- T3 DeepSeek V4应用场景案例 — 产业化落地报道
- T3 DeepSeek V4成本优势分析 — 成本对比分析
- T3 DeepSeek V4市场定位分析 — 市场竞争分析
- T1 21经济网:DeepSeek-V4华为昇腾首发 — 昇腾950首发、黄仁勋评论
- T1 腾讯新闻:海外评测DeepSeek-V4 — 智能体任务排名、幻觉率、运行成本
- T2 人人都是产品经理:DeepSeek不想只做大模型了 — 国产算力绑定、商业化压力、人才流失
- T2 凤凰网:DeepSeek V4终于来了 — 技术报告解读、训练硬件分析
- T1 澎湃新闻:DeepSeek-V4预览版正式发布 — 2026年4月24日官方发布信息
- T1 观察者网:DeepSeek-V4发布开源 — 百万上下文、技术突破
- T1 观察者网:DeepSeek V4价格屠夫 — API定价与市场竞争分析
- T1 36氪:DeepSeek API降价 — 4月26日缓存命中价格降至1/10
- T1 量子位:DeepSeek V4报告太详尽了 — 484天换代之路全公开
- T1 实在智能:DeepSeek R2发布时间 — 2026年4月R2最新状态
- T1 每日经济新闻:万亿参数模型DeepSeek-V4解锁国产芯片 — 昇腾适配意义
- T1 Reuters:DeepSeek V4发布后大厂争购华为AI芯片 — 产业链影响