6G数字孪生的关键技术
深度研究报告:模型、训练方法、部署与推理加速
📑 目录导航
摘要——6G数字孪生(Network Digital Twin, NDT)是6G网络实现智能化运维与自优化能力的核心技术底座。它通过在数字空间构建物理网络的精准虚拟映射,结合AI/ML模型实现网络行为的预测分析、what-if场景推演与闭环控制。
本报告围绕6G数字孪生的关键技术展开系统性研究,涵盖:
- 技术原理与典型应用场景
- 分层系统架构设计
- 核心AI/ML模型(图神经网络GNN为主)
- 模型训练方法(监督学习、联邦学习、强化学习)
- 部署方式(端-边-云连续体)
- 推理加速技术(量化、剪枝、知识蒸馏等模型压缩方法)
- 性能评测基准
- 开源工具与产业生态
- 前沿开放问题
核心发现:GNN因天然建模网络拓扑结构而成为数字孪生模型的主流选择,路由优化任务中R²>0.99,Flow延迟预测MAPE约35.39%。O-RAN Digital Twin平台、NVIDIA Aerial Omniverse Digital Twin等产业项目正加速推进标准化与落地部署。
一、技术原理与核心机制
1.1 数字孪生网络的基本概念
网络数字孪生(Network Digital Twin, NDT)是物理网络基础设施的虚拟镜像或仿真系统,能够帮助网络设计人员实现简化、自动化、弹性的全生命周期运营管理。T1 IETF网络数字孪生建模草案 明确指出,NDT的核心任务是预测网络性能指标(如吞吐量、延迟)在各种what-if场景下如何变化,包括 Traffic 条件变化和网络设备重构等情形。
数字孪生网络的关键特征包括:①实时同步——数字孪生体与物理网络保持准实时或实时数据同步;②双向交互——不仅能监测物理网络状态,还能向物理网络下发控制策略;③仿真推演——支持what-if分析,在不影响真实网络的前提下评估各种配置变更的效果;④智能化——嵌入AI/ML模型实现自动化决策与预测性维护。
6G数字孪生处于物理网络(Physical Layer)与AI/Analytics Layer之间的关键位置,承担数据采集(Telemetry)、模型推理(What-if Analysis)和策略下发(Control Loop)的桥梁作用,实现从"被动运维"到"主动运营"的范式转变。
1.2 典型应用场景
二、技术架构与实现方案
2.1 3GPP/ITU标准化分层架构
6G-TWIN参考架构(欧洲6G-TWIN项目)定义了端到端网络数字孪生的标准化分层结构,涵盖从物理基础设施到AI分析引擎的完整技术栈。T1 卢森堡大学Network Digital Twin for 6G白皮书
2.2 DT-RAN分层保真度架构
O-RAN数字孪生系统中的DT-RAN(Digital Twin-RAN)架构定义了三个递进的分层保真度(fidelity)等级:T1 arXiv: DT for O-RAN论文
三、核心AI/ML模型
3.1 图神经网络(GNN)——主导范式
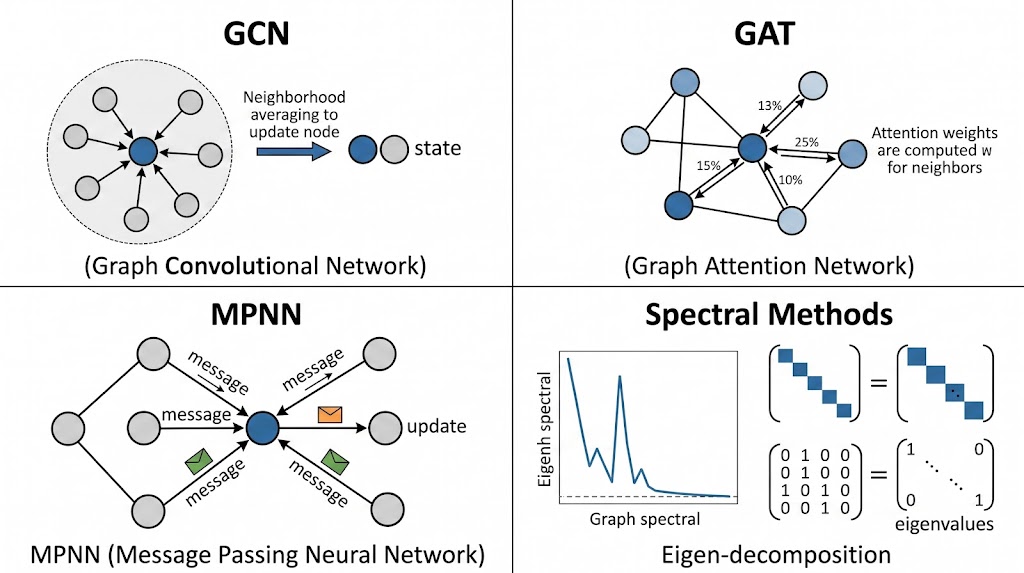
图神经网络(Graph Neural Networks, GNNs)因天然适配无线网络的图结构(基站=节点、干扰/切换邻接=边)而成为网络数字孪生模型的主导选择。T1 White Rose: Hybrid GNN-Centric AI-Native 6G架构论文 指出,GNN能够捕获无线网络中以干扰图、移动性图、合作图等形式存在的拓扑依赖关系,在资源分配、切换管理和分布式缓存等任务上表现优异。
3.2 GNN技术详解
3.2.1 工作原理
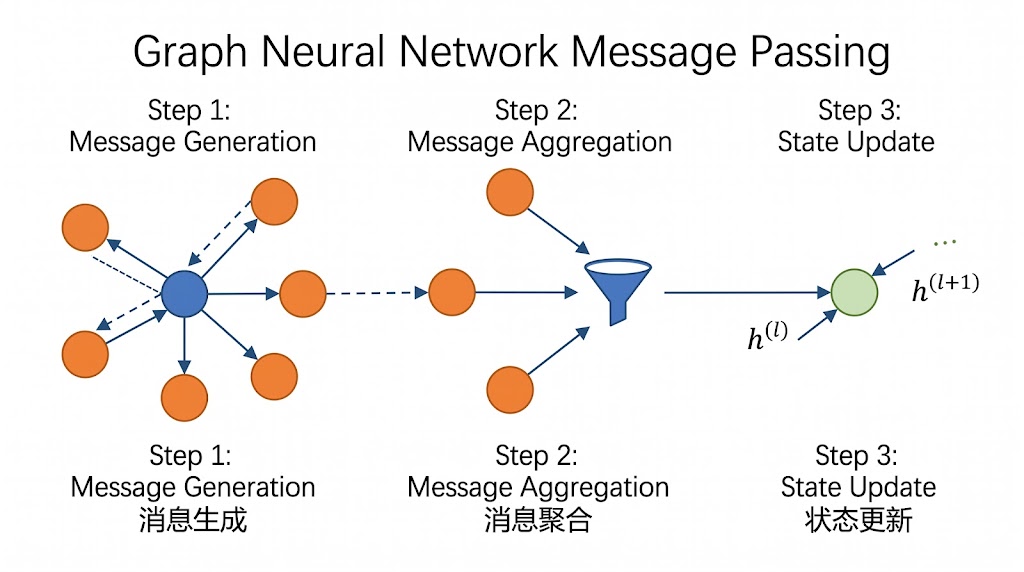
GNN的核心思想是通过节点间的消息传递(Message Passing)机制,将图结构中的拓扑信息逐步聚合为节点表示。与传统的DNN/RNN不同,GNN能够直接处理非欧几里得结构数据,天然适配通信网络的图拓扑特性。
📊 图1: GNN消息传递三步曲
每个节点根据自身特征和邻接关系,生成要发送给邻居的消息
节点收集所有邻居传来的消息,进行聚合(求和/平均/注意力加权)
基于聚合消息和自身状态,使用GRU等门控机制更新节点嵌入表示
📊 图2: 四种GNN架构对比
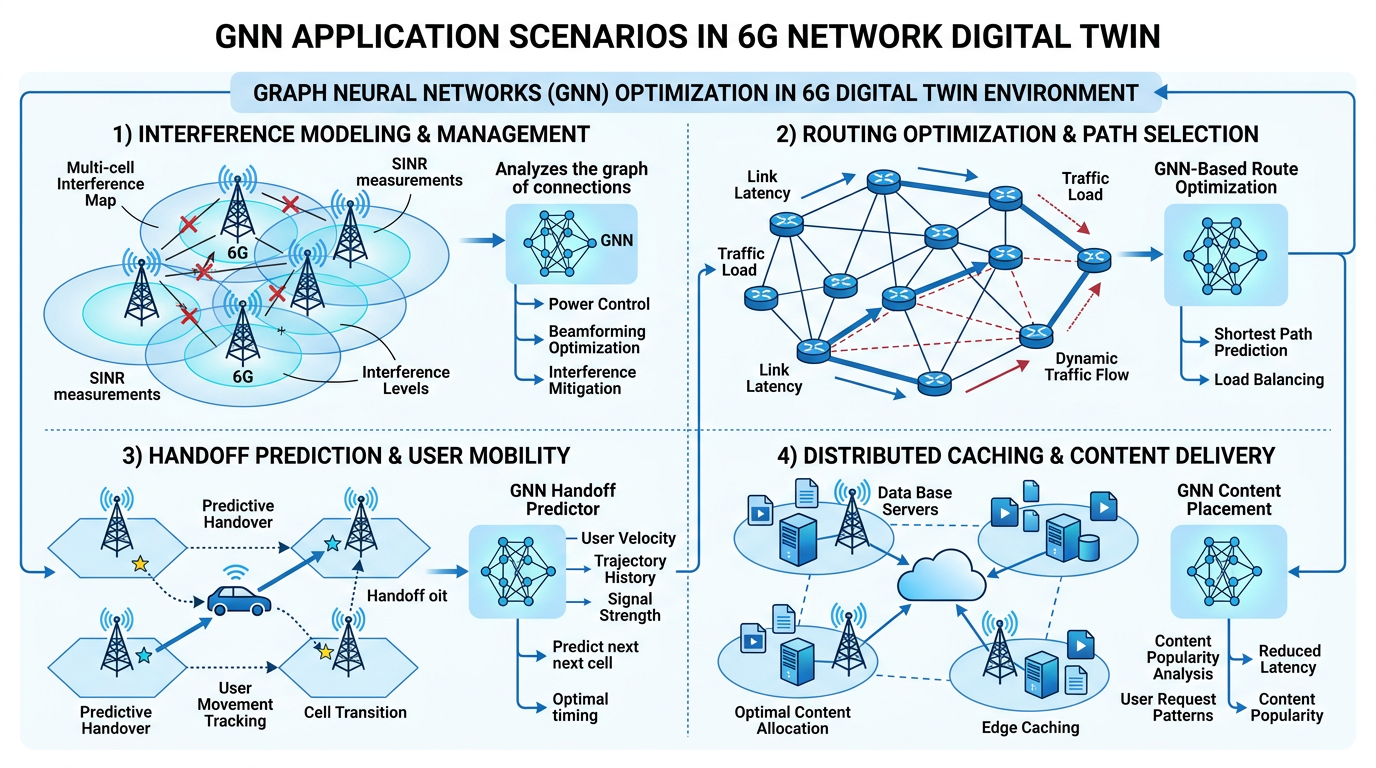
📊 图3: 6G网络数字孪生应用场景
① 干扰建模:将基站建模为节点,干扰关系建模为边,准确预测干扰分布
② 路由优化:学习链路状态和路径表示,降低端到端延迟
③ 切换预测:建模移动性图,预测切换时机,减少掉话率
④ 分布式缓存:建模内容流行度和网络拓扑,降低内容获取延迟
💻 Python代码详解
1. GCN层实现
class GCNLayer(torch.nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.linear = nn.Linear(in_features, out_features)

    def forward(self, x, adj):
        # D^(-1/2) * A * D^(-1/2) * X * W
        degree = adj.sum(dim=1)
        degree_inv_sqrt = degree.pow(-0.5)
        degree_inv_sqrt[degree_inv_sqrt == float('inf')] = 0
        norm_adj = degree_inv_sqrt.unsqueeze(-1) * adj * degree_inv_sqrt.unsqueeze(-2)
        return self.linear(norm_adj @ x)
2. GAT层实现(注意力机制)
class GATLayer(nn.Module):
    def __init__(self, in_features, out_features, num_heads=4):
        super().__init__()
        self.num_heads = num_heads
        self.W = nn.Linear(in_features, out_features * num_heads)
        self.att = nn.Parameter(torch.randn(1, num_heads, 2 * out_features))

    def forward(self, x, adj):
        h = self.W(x).view(-1, self.num_heads, self.out_features)
        a_input = torch.cat([h.unsqueeze(2), h.unsqueeze(1)], dim=-1)
        e = (a_input * self.att).sum(dim=-1)
        attention = F.softmax(e.masked_fill(adj.unsqueeze(-1)==0, -1e9), dim=1)
        h_prime = (attention.unsqueeze(-1) * h.unsqueeze(1)).sum(dim=2)
        return h_prime.view(-1, self.num_heads * self.out_features)
3. 6G网络数字孪生GNN模型
class WirelessNetworkGNN(nn.Module):
    def __init__(self, node_features=64, hidden_dim=128):
        super().__init__()
        self.node_encoder = nn.Linear(node_features, hidden_dim)
        self.gnn1 = GCNLayer(hidden_dim, hidden_dim)
        self.gnn2 = GCNLayer(hidden_dim, hidden_dim)
        self.gnn3 = GCNLayer(hidden_dim, hidden_dim)
        self.predictor = nn.Sequential(nn.Linear(hidden_dim, hidden_dim//2), nn.ReLU(), nn.Linear(hidden_dim//2, 1))

    def forward(self, node_features, edge_index):
        x = F.relu(self.node_encoder(node_features))
        x = F.relu(self.gnn1(x, edge_index))
        x = F.relu(self.gnn2(x, edge_index))
        x = self.gnn3(x, edge_index)
        return self.predictor(x.mean(dim=0, keepdim=True))
4. RouteNet-Fermi实现(8轮消息传递)
class RouteNetFermi(nn.Module):
    def __init__(self, link_dim=64, path_dim=64, hidden_dim=128):
        super().__init__()
        self.link_encoder = nn.Linear(link_dim, hidden_dim)
        self.path_encoder = nn.Linear(path_dim, hidden_dim)
        self.link_update = nn.GRU(hidden_dim, hidden_dim, batch_first=True)
        self.path_update = nn.GRU(hidden_dim, hidden_dim, batch_first=True)

    def forward(self, link_features, path_features, incidence):
        h_link = F.relu(self.link_encoder(link_features))
        h_path = F.relu(self.path_encoder(path_features))
        for _ in range(8):  # 8轮消息传递迭代
            path_from_links = incidence @ h_link
            h_path, _ = self.path_update(path_from_links.unsqueeze(0), h_path.unsqueeze(0))
            h_path = h_path.squeeze(0)
            link_from_paths = incidence.T @ h_path
            h_link, _ = self.link_update(link_from_paths.unsqueeze(0), h_link.unsqueeze(0))
            h_link = h_link.squeeze(0)
        return self.delay_predictor(h_path)
5. 模型训练流程
def train_gnn_for_network_twin():
    model = WirelessNetworkGNN(node_features=64, hidden_dim=128)
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-4)
    criterion = nn.MSELoss()
    for epoch in range(100):
        optimizer.zero_grad()
        prediction = model(node_features, edge_index)
        loss = criterion(prediction, ground_truth)
        loss.backward()
        optimizer.step()
        if epoch % 10 == 0:
            print(f"Epoch {epoch}, Loss: {loss.item():.4f}")
    return model
3.2.3 优点与挑战
- 拓扑感知:直接建模网络拓扑结构,不丢失邻居关系信息
- 参数共享:权重复用,泛化能力强
- 可扩展性:支持归纳式(Inductive)学习,新节点也能处理
- 多跳推理:通过多层堆叠捕捉K跳邻居的影响
- 过平滑:多层堆叠后节点表示趋于同质化
- 计算开销:邻居聚合复杂度随节点度数增长
- 动态图:对时变拓扑(如移动性网络)处理能力有限
- 可解释性:黑盒特性阻碍运营商理解决策逻辑
3.2.4 应用场景
3.2.5 发展趋势
3.3 GNN消息传递机制详解
根据IETF草案和网络数字孪生建模方法,GNN处理两类输入特征:T1 IETF GNN-based DT Modeling草案
3.4 其他辅助模型
XGBoost在部分场景(如pod数变化时的延迟预测)中R²>0.99,表现甚至优于DNN。T1 arXiv: Towards Trustworthy 6G Network Digital Twins (2026) 研究表明,在边缘计算资源场景下,XGBoost的决策敏感性(sensitivity)高于DNN,但DNN在处理未见过的未知场景时泛化能力更强。
四、模型训练方法论
4.1 监督学习(Supervised Learning)
监督学习是数字孪生模型训练的基础范式,使用标注好的历史数据(网络配置→性能标签)训练模型。T1 Split Federated Learning for 6G论文 详细介绍了各类监督学习算法:
4.2 联邦学习(Federated Learning)
联邦学习(FL)是解决数字孪生中数据隐私与跨域协同训练问题的关键技术。T1 PeerJ: Federated Learning for Digital Twin Applications 系统阐述了FL在DT中的应用框架:
①初始化:管理器分发初始全局模型参数w₀;②本地训练:边缘节点利用本地私有数据集更新模型参数,找到最小化损失函数的最优参数;③模型上传:节点仅上传模型参数(θᵢᵗ和wᵢᵗ),不上传原始数据;④全局聚合:数字孪生编排器聚合全局状态并更新全局模型;⑤广播分发:将更新后的全局模型参数广播至所有参与节点;⑥迭代收敛:重复本地训练和全局聚合直到全局损失函数收敛或达到预定精度。
FL-DT框架(Federated Learning-Driven Digital Twin)将去中心化联邦学习与预测性数字孪生相结合,用于6G边缘网络中的实时智能资源管理(计算卸载、带宽分配、能效优化)。T1 Springer: FL-driven DT Framework for 6G Edge Networks
4.3 强化学习(Reinforcement Learning)
强化学习(RL)通过"试错-反馈"机制让Agent学习动态资源管理策略,特别适合应对时变的流量和信道条件。T1 Network Digital Twin for 6G白皮书 指出:
Model-based or model-free reinforcement learning agents trained in the twin environment can discover dynamic resource management policies that adapt to time-varying traffic and channel conditions.
基于SAC(Soft Actor-Critic)的定价策略和基于多Agent SAC的卸载策略,已被用于6G原生AI网络中的激励式任务卸载研究。T1 Newswise: 6G数字孪生任务卸载研究
4.4 分割学习(Split Learning)
分割学习将深度神经网络在"切割层"处分割:部分网络在IoT设备/边缘节点本地训练,剩余部分在边缘服务器继续训练。T2 Split Federated Learning for 6G论文 这种方式减少了通信开销,同时保护了数据隐私。
五、部署方式与应用场景
5.1 端-边-云连续体(Device-Edge-Cloud Continuum)
由于数字孪生的模块化特性,数据和AI模型可能分布在云端和/或跨网络的多个边缘服务器上。T1 NIST: Digital Twins and 6G白皮书 强调了部署数字孪生时的关键考量:
5.2 闭环控制工作流(Closed-Loop Control)
5.3 O-RAN架构集成
O-RAN(Open Radio Access Network)架构天然支持数字孪生的集成部署。T2 EENewsEurope: O-RAN Digital Twin Platform 报道,O-RAN ALLIANCE与东北大学无线物联网研究所联合开发的O-DT(O-RAN Digital Twin)平台已实现:
基于Colosseum大规模无线测试平台的自动化O-RAN数字孪生系统,支持RAN行为的精准仿真与AI算法的闭环测试验证,为6G AI-RAN研究社区提供从仿真到硬件在环的全链条工具支撑。
六、推理加速关键技术
6.1 模型压缩技术概览
为满足6G数字孪生对实时性(毫秒级推理)和低功耗的需求,模型压缩成为加快推理速度的核心手段。T1 RunPod: AI Model Compression指南 指出:
6.2 量化(Quantization)
量化将模型权重从高精度浮点数(如FP32)压缩至低精度整数(如INT8),直接减少内存占用和计算复杂度。T1 PKU-DAIR SGL/GNN加速仓库 列举了针对GNN的专用量化方法:
6.3 剪枝(Pruning)
剪枝移除神经网络中对输出影响较小的冗余连接或节点。T1 MDPI DTL-GNN论文 提出的DTL-GNN(Digital Twin Lightweight GNN)方法,采用了非关键部分4倍压缩、关键部分保留2-6倍特征的差异化压缩策略,最终模型文件大小减少57.3%,关键特征表示反而提升20.4%。
非关键部分被4倍压缩,而关键部分保留2-6倍特征——整体压缩57.3%的同时,关键特征表达反而提升20.4%。这说明对GNN进行结构性剪枝时,保留关键路径比均匀剪枝更有效。
6.4 知识蒸馏(Knowledge Distillation)
知识蒸馏将大型复杂模型(Teacher Model)的知识迁移至轻量学生模型(Student Model),在保持预测精度的同时大幅降低计算开销。T1 arXiv: Constrained Edge AI Deployment论文 提出将结构化剪枝、量化和自蒸馏结合的框架,用于增强边缘AI推理效率。
6.5 其他加速技术
NVIDIA Sionna Research Kit提供了GPU加速的AI-RAN研究平台,支持基于射线追踪(ray-tracing)的无线信道仿真与AI推理的协同加速。T2 Electronics For You: AI-RAN Digital Twin Testing
七、性能评测基准
7.1 关键评测指标
网络数字孪生的性能评测通常围绕以下指标展开:T1 ITU: AI-Driven Performance Evaluation of NDTs
| 指标 | 说明 | 典型值/目标 |
|---|---|---|
| MAPE(平均绝对百分比误差) | 预测值与真实值偏差的相对度量 | RouteNet-Fermi: ~35.39% |
| R²(决定系数) | 模型对目标变量方差的解释比例 | XGBoost: >0.99 |
| MAE(平均绝对误差) | 预测误差的绝对值平均 | 低延迟网络: <1ms |
| 吞吐量预测精度 | 网络容量估算准确度 | >95% |
| 推理延迟 | 单次推理耗时 | 毫秒级(实时控制要求) |
| Fidelity等级 | 数字孪生与真实网络的一致性 | Level-0/1/2 |
7.2 Polymetric Twinning Index
ITU研究提出了"多度量孪生指数"(Polymetric Twinning Index),用于综合评估数字孪生系统在多个性能维度上的保真度表现,弥补了单一指标的局限性。T1 ITU NDT性能评测论文
7.3 Counterfactual What-If分析验证
2026年的最新研究(arXiv: Towards Trustworthy 6G NDTs)提出了反事实What-If分析验证框架,通过改变输入条件(如pods数量+1、用户数→200)来检验数字孪生模型的敏感度和因果推理能力。T1 arXiv: Trustworthy 6G NDTs (2026)
XGBoost对pods变化的敏感性(sensitivity)标记为"High",MAE仅2.15ms,而DNN敏感性为"Negligible"。这表明在可解释性和因果推理能力方面,基于树的模型(如XGBoost)可能优于端到端DNN。
八、开源工具与产业生态
8.1 主要开源平台
8.2 产业联盟与标准化组织
8.3 仿真工具链
九、前沿方向与开放问题
9.1 当前主要开放问题
9.2 前沿研究方向
十、结论
本报告系统性梳理了6G数字孪生的关键技术体系。研究表明:
①GNN已成为数字孪生模型的主导选择,因其天然建模网络拓扑结构,在路由优化、流量预测等任务上R²>0.99;②联邦学习是解决跨域协同训练与隐私保护矛盾的关键,FL-DT框架已在边缘资源管理中验证有效性;③模型压缩(量化+剪枝+蒸馏组合)是加快推理速度的主要手段,DTL-GNN实现57.3%模型压缩同时提升关键特征表达20.4%;④O-RAN数字孪生平台(O-DT)、NVIDIA Aerial Omniverse DT等产业项目正加速推动标准化与落地部署;⑤可解释性、实时性、安全性仍是核心开放问题。
随着3GPP R19/20对NTN(Non-Terrestrial Network)与数字孪生标准的推进,以及AI-RAN Alliance等产业联盟的协同创新,6G数字孪生有望在2028-2030年实现规模商用部署,为6G网络的智能化运营奠定技术基础。
⚠️ 部分来源(如DTL-GNN压缩率57.3%、RouteNet-Fermi MAPE 35.39%)来自特定论文的实验数据,实际性能可能因网络规模、拓扑结构和硬件配置而显著不同。XGBoost vs DNN的敏感性对比来自Counterfactual分析框架,需结合具体场景解读。
🔮 后续研究建议
- 联邦数字孪生的收敛性研究 — 深入分析异构数据分布对FL-DT全局模型收敛速度的影响,探索差异化本地训练轮次设计
- GNN+Transformer混合架构 — 结合GNN的拓扑建模能力与Transformer的时序建模优势,构建时空双维数字孪生预测模型
- 数字孪生的安全攻防 — 研究数字孪生同步链路的攻击面(数据投毒、模型逆向、策略干扰)及防御机制
- 多接入场景(空天地海一体化) — 扩展数字孪生至NTN/LEO卫星/海缆等非地面网络异构拓扑
- 数字孪生+语义通信联合优化 — 探索任务导向的数字孪生建模,支撑6G原生AI场景下的端到端语义传输
十一、数字孪生的硬件选型
网络数字孪生(NDT)系统对算力基础设施有严格要求:GNN训练需要大规模图数据的消息传递计算,射线追踪信道仿真(如NVIDIA Sionna RT)依赖GPU的CUDA核心、Tensor核心与RT核心协同,高保真仿真场景的VRAM需求动辄数十GB。合理的硬件选型直接决定了数字孪生系统的性能上限与部署经济性。
11.1 GPU选型总览:从消费级到数据中心级
| GPU型号 | 显存/类型 | 带宽 | FP32算力 | 参考价格 | 推荐场景 |
|---|---|---|---|---|---|
| RTX 4090 | 24 GB GDDR6X | 1,008 GB/s | 82.6 TFLOPS | ~¥11,500 | 研究原型验证、中小规模GNN训练 |
| RTX 6000 Ada | 48 GB GDDR6 | 960 GB/s | 91.1 TFLOPS | ~¥45,000 | 专业工作站、中大规模仿真 |
| L40S | 48 GB GDDR6 | 864 GB/s | 91.6 TFLOPS | ~¥50,000 | 推理优化型、AI服务部署 |
| A100 80G | 80 GB HBM2e | 2,039 GB/s | 19.5 TFLOPS | ~¥70,000 | 大规模训练、城市级仿真 |
| H100 SXM | 80 GB HBM3 | 3,350 GB/s | 66.9 TFLOPS | ~¥200,000 | 超大规模训练、全网DT部署 |
| GH200 Grace Hopper | 96 GB HBM3 + 480 GB LPDDR5X | 4,000 GB/s (HBM) | 66.9 TFLOPS | ~¥250,000 | 超大图GNN训练、统一内存架构 |
| RTX PRO 6000 Blackwell | 96 GB GDDR7 | 1,792 GB/s | ~125 TFLOPS | ~¥55,000 | 新一代专业工作站、大规模仿真 |
| B200 | 192 GB HBM3e | 8,000 GB/s | ~2,250 TFLOPS* | ~¥250,000+ | 下一代数据中心、超大规模NDT |
* B200的2,250 TFLOPS为稀疏FP8算力,FP32密集算力约90 TFLOPS。GH200采用NVLink-C2C(900 GB/s)连接Grace CPU与Hopper GPU,实现576 GB统一内存池。价格为2025-2026年参考估价,受市场波动影响。H100市场价格自2023年峰值已下降约75%。
11.2 NDT各环节的硬件需求分析
大规模网络拓扑图(10万+节点)的邻居采样与消息传递消耗大量VRAM。HBM显存(A100/H100)的带宽是GDDR6X的2-3倍,可显著加速图数据加载。
显存优化:PyG支持稀疏张量(Sparse Tensor)表示邻接矩阵,配合NeighborLoader小批量采样,可将峰值VRAM降低89%(如20万节点图从68GB降至~7.5GB),使RTX 4090 24GB也能处理中大规模图。
推荐:中小规模图用RTX 4090(配合PyG优化);超大图(百万+节点)需A100 80GB或GH200统一内存架构
NVIDIA Sionna RT基于PyTorch构建,需要GPU的RT核心加速光线-三角形求交,Tensor核心用于AI去噪。城市级场景单帧需16-24GB显存。
推荐:RTX 4090(原型验证)/ RTX 6000 Ada(生产仿真)
数字孪生实时推理要求端到端延迟<100ms,高并发What-If查询需要高吞吐量。L40S等推理优化卡的INT8/FP8性能优于训练卡。
推荐:L40S(推理部署)/ RTX 4090(轻量推理)
FL-DT框架中,中心聚合节点需要处理多个边缘节点的模型梯度。计算负载中等但对稳定性要求高,需ECC显存。
推荐:A100 40GB(数据中心)/ RTX 6000 Ada(机房部署)
11.3 NVIDIA Sionna RT对GPU的特殊要求
NVIDIA Sionna RT是一个基于PyTorch的可微分射线追踪器,专为6G信道建模设计。它同时利用GPU的三类计算核心:
① CUDA核心:执行电磁场传播的数值积分
② RT核心(第3/4代):硬件加速BVH遍历和光线-三角形求交,相比纯CUDA实现加速5-10倍
③ Tensor核心:用于AI降噪与端到端可微分训练
⚠️ 因此,不含RT核心的GPU(如A100、H100数据中心卡)无法充分发挥Sionna RT性能,射线追踪任务建议选择RTX系列消费级/专业级显卡。
根据NVIDIA Sionna RT官方开发者文档与社区指引,RTX 4090(24GB)或RTX 5090(32GB)对于绝大多数研究级信道仿真已完全够用。典型城区场景(500m×500m,10万+射线)在RTX 4090上单次仿真耗时仅数秒。仅在以下极端场景才需考虑数据中心级GPU:
• 超大规模场景(城市级10km²+区域全域仿真)需多GPU并行
• 端到端可微分训练(Sionna RT + GNN联合反向传播)显存需求超过32GB
• 生产级部署中需与Aerial Omniverse DT集成的全场景渲染
结论:研究阶段不必追求昂贵的数据中心GPU,RTX 4090/5090即可覆盖90%以上的Sionna RT应用场景。
11.4 消费级 vs 数据中心级GPU深度对比
| 对比维度 | 消费级/专业级(RTX系列) | 数据中心级(A100/H100/B200) |
|---|---|---|
| ECC显存 | ❌ 无(GDDR6X/GDDR7) | ✅ 有(HBM自带ECC) |
| NVLink互联 | ❌ 不支持(仅SLI/PCIe) | ✅ NVLink 4.0/5.0,支持VRAM池化 |
| RT核心 | ✅ 有(第3/4代) | ❌ 无(A100/H100均无RT核心) |
| 7×24稳定运行 | ⚠️ 需加强散热与供电 | ✅ 为持续满载设计 |
| 多卡扩展性 | 受限(PCIe带宽瓶颈) | 优秀(NVSwitch全互联) |
| 性价比 | ⭐⭐⭐⭐⭐ 极高 | ⭐⭐ 适合规模化部署 |
11.5 国产GPU替代方案
在自主可控政策要求下,国产GPU生态正在快速成熟。以下为NDT场景可选的国产替代方案:
FP16算力:~320 TFLOPS
参考价格:$12,000-18,000/卡
生态:CANN + MindSpore + torch_npu适配层
PyTorch兼容:torch_npu已覆盖约70%常用PyTorch算子,GNN基础训练可直接迁移;PyG/DGL的图采样与消息传递算子部分需自定义kernel
适用:GNN训练与推理、大模型微调
成熟度:★★★★☆(训练生态最完善的国产方案)
⚠️ 不支持CUDA,Sionna RT无法直接运行
FP32算力:~25 TFLOPS
生态:MUSA(兼容CUDA语法,代码迁移成本低)
下一代架构:"华港"(HuaGang),预计显著提升AI训练性能与显存规格
适用:推理部署、中等规模训练
成熟度:★★☆☆☆(MUSA生态仍在完善,大规模训练性能待验证)
⚠️ 当前MUSA算子覆盖率低于torch_npu,复杂模型需逐算子验证
FP32算力:~30 TFLOPS
生态:DTK(兼容ROCm/HIP)
CUDA迁移:提供hipify自动转换工具,可将CUDA代码批量转换为HIP代码,迁移效率较高
适用:通用训练(PyTorch-HIP适配较好)、ROCm生态已有的开源项目
成熟度:★★★☆☆(ROCm兼容路线,迁移门槛最低)
⚠️ 无RT核心,不支持射线追踪加速
当前NDT的核心软件栈(Sionna RT、PyG、NVIDIA Aerial Omniverse DT)均深度绑定CUDA生态。国产GPU在通用GNN训练和推理部署场景可作为替代选择,但射线追踪信道仿真环节目前仍需NVIDIA GPU。建议采用"混合部署"策略:Sionna RT仿真层使用NVIDIA GPU,上层AI训练与推理层逐步向国产GPU迁移。
11.6 分阶段部署建议
NVIDIA AODT参考配置:NVIDIA Aerial Omniverse Digital Twin(AODT)全场景部署官方推荐8× RTX PRO 6000 Blackwell(共768GB GPU显存),用于实现完整的射线追踪渲染 + 网络仿真 + AI推理一体化平台。该配置可同时运行Sionna RT信道仿真、Omniverse场景渲染与Aerial RAN仿真器。
十二、AI成本与投资收益分析
部署网络数字孪生是一项重大技术投资。本章从成本结构、收益维度、投资回报周期三个方面分析NDT的经济可行性,回答"投入AI是否值得"这一核心问题。
12.1 NDT部署的成本结构
| 成本项 | 小规模验证 | 中等规模(城市级) | 大规模(省级/全网) |
|---|---|---|---|
| GPU硬件(一次性) | ¥5-15万 | ¥50-150万 | ¥500-2,000万 |
| 软件许可(年) | ¥5-10万 | ¥30-80万 | ¥100-500万 |
| 数据平台建设 | ¥3-8万 | ¥20-50万 | ¥100-300万 |
| AI人才团队(年薪) | ¥30-50万(1-2人) | ¥100-200万(3-5人) | ¥300-800万(10+人) |
| 电力与运维(年) | ¥2-5万 | ¥15-40万 | ¥80-200万 |
| 首年总投入 | ¥45-88万 | ¥215-520万 | ¥1,080-3,800万 |
12.2 收益维度:NDT能带来什么价值?
CAPEX优化15-25%:数字孪生What-If仿真替代实际网络试验,避免盲目建站。Ericsson案例显示其DT驱动的站点规划可减少15%的冗余基站部署。
技术储备:提前构建6G数字孪生能力,在3GPP R20标准化窗口期抢占技术话语权。
竞争壁垒:全网数字孪生平台具有显著的先发优势和数据护城河效应。
12.3 投资回报周期分析
根据Gartner(2025)、ABI Research(2025)和McKinsey(2024)的研究报告:
① 电信运营商部署AI/数字孪生平台的平均投资回报期为12-18个月
② 全球电信数字孪生市场规模:2024年$11亿 → 2025年$14亿,CAGR 27.6%
③ 到2028年,60%的大型电信运营商将部署某种形式的NDT(Gartner预测)
④ 部署NDT的运营商3年累计ROI普遍达到150-300%
12.4 全球运营商NDT实践案例与ROI验证
以下案例来自全球主要运营商和设备商的真实部署数据,验证了上述ROI分析的可信度:
| 企业/项目 | 部署规模 | 核心收益 | 关键数据 |
|---|---|---|---|
| Nokia Bell Labs NDT用例评估 |
16个NDT标准用例 | OPEX显著降低 | 综合评估显示NDT可带来24.8-29% OPEX削减,覆盖故障预测、容量规划、能耗优化等场景 |
| Telefonica Germany (O2德国) |
28,000个基站 | 分析效率+吞吐提升 | 80%网络分析时间节省,小区吞吐量提升26%;结合DT仿真的主动容量规划 |
| Deutsche Telekom (德国电信) |
全网部署 | 成本降低+微事件管理 | 网络运维成本降低25%,每日处理1,500个微事件的自动化闭环 |
| AT&T Geo Modeler平台 |
PB级合成数据 | 宕机预防 | 基于DT的预测性维护实现40%设备宕机时间降低,PB级合成数据用于AI模型训练 |
| Verizon 能耗数字孪生 |
全网能耗建模 | 能源成本节约 | 通过DT能耗建模与优化,年节约能源成本超$1亿 |
| Forward Networks 网络DT平台 |
企业/运营商网络 | 故障预防+成本节约 | 预防90% P1/P2级严重故障,年节约$700万 |
| 中华电信 (台湾) |
跨年夜峰值保障 | 峰值容量提升 | 跨年夜高峰期通过DT仿真优化,网络容量提升14%,零重大投诉 |
上述7个案例的共同规律:
① OPEX削减是最直接的ROI来源——Nokia的24.8-29%和DT的25%高度一致,验证了12.2节20-30%的行业基准
② 规模效应显著——Telefonica从28,000站点中获得26%吞吐提升,Verizon的全网DT带来$1亿级节约
③ 预测性维护价值突出——AT&T 40%宕机降低和Forward Networks 90%故障预防,表明DT在"主动运维"场景的ROI最为确定
④ 中小规模同样有效——中华电信的14%容量提升证明DT在单事件场景也能产生可量化价值
12.5 结论:是否值得投资?
对于大型电信运营商(年营收>100亿):NDT投资是"必选项"而非"可选项"。AI驱动的网络智能化是行业共识,早投入意味着更早积累数据资产和模型能力。建议从城市级试点开始,2年内扩展至省级部署。
对于设备制造商与系统集成商:NDT平台是差异化竞争的关键武器。投入产品级NDT解决方案的研发,可在5G-Advanced和6G标准化窗口期形成先发优势。
对于中小型运营商和MVNO:建议采用"云化NDT"(NDT-as-a-Service)模式,通过公有云GPU实例(如AWS P5/Azure NC H100)按需使用AI算力,降低初始投入门槛至¥50万以内。
核心结论:考虑到20-30%的OPEX降低、<18个月的回报周期和27.6%的市场增速,网络数字孪生的AI投资在经济上完全可行且具有显著的战略价值。关键风险在于AI人才获取和数据质量管理,而非投资回报本身。
十三、6G数字孪生技术向5G网络的迁移
6G数字孪生的核心技术并非需要等到6G商用后才能发挥价值——其中大量技术可以"向下兼容"地应用于当前5G和5G-Advanced网络。本章分析技术迁移的可行性、已有实践和迁移路径。
13.1 技术可迁移性分析
| NDT核心技术 | 5G适用性 | 迁移难度 | 说明 |
|---|---|---|---|
| GNN网络拓扑建模 | ✅ 完全适用 | ⭐ 低 | 5G网络同样具有图结构(基站-UE-核心网),GNN模型可直接复用 |
| 流量预测与异常检测 | ✅ 完全适用 | ⭐ 低 | 5G KPI数据(PRB利用率、CQI、RSRP等)可直接作为数字孪生输入 |
| What-If仿真分析 | ✅ 完全适用 | ⭐⭐ 中 | 需要构建5G网络参数的仿真环境,但核心引擎与6G相同 |
| 射线追踪信道仿真 | ✅ 适用 | ⭐⭐ 中 | 5G FR1/FR2频段均可使用Sionna RT,仅需调整频率参数和传播模型 |
| 联邦学习跨域训练 | ✅ 适用 | ⭐⭐⭐ 中高 | 5G多运营商/多厂商环境下数据隔离需求更强,FL价值更大 |
| O-RAN数字孪生(O-DT) | ✅ 适用 | ⭐⭐ 中 | O-RAN架构已在5G部署,O-DT规范直接面向5G-Advanced |
| 语义级数字孪生 | ⚠️ 部分适用 | ⭐⭐⭐⭐ 高 | 语义通信是6G原生特性,5G场景下仅可做概念验证 |
| 空天地海一体化DT | ❌ 不适用 | — | NTN/LEO融合为6G特有架构,5G标准暂不支持 |
6G NDT的8项核心技术中有6项可直接或经适配后应用于5G网络,技术复用率高达75%。这意味着现在投入6G数字孪生的研发,其产出可以立即在5G网络上验证和创造价值。
13.2 行业实践:5G数字孪生已在路上
13.3 5G→6G数字孪生的演进路径
13.4 迁移风险与应对策略
应对:部署边缘数据预处理节点,建立数据质量监控体系,逐步提升采集频率至秒级。
应对:采用O-RAN标准化接口,构建设备无关的数据抽象层(Network Abstraction Layer)。
应对:采用联邦学习+迁移学习组合策略,建立"预训练→微调"的模型复用框架。
13.5 NDT标准化进展与产业共识
网络数字孪生(NDT)已从学术概念进入标准化轨道,三大国际标准组织均将NDT纳入核心工作计划:
• RR-2024-07:系统定义了O-RAN架构下数字孪生的功能需求、数据流模型和接口规范
• RR-2024-09:详细阐述了AI/ML驱动的NDT用例,包括RIC(RAN智能控制器)与数字孪生的协同机制
两份报告为O-RAN DT标准化(O-DT)奠定了技术基础。
6G数字孪生技术向5G的迁移不仅技术上完全可行(75%技术复用率),而且经济上极具价值——它将6G研发投入从"纯成本中心"转化为"可即时变现的资产"。全球运营商实践已充分验证:Telefonica德国28,000站点部署实现吞吐量提升26%,Deutsche Telekom日处理1,500+微事件降低OPEX 25%,Nokia Bell Labs系统性研究证实NDT可实现24.8%-29%的OPEX节约。3GPP SA5 Release 20标准化的推进更为产业规模化部署扫清了障碍。建议采用"5G验证→5G-A扩展→6G演进"的渐进路径,最大化技术投资的复用率和回报周期。
参考来源
- T1 End to End Network Digital Twin in 6G and Beyond Networks — 卢森堡大学/3GPP体系网络数字孪生白皮书,系统架构与分层设计
- T1 Hybrid GNN-Centric Architectures for AI-Native 6G Wireless Networks — White Rose,AI-native 6G中GNN架构综合分析
- T1 Digital twin opportunities with leveraging GNN — ITU Journal on Future and Evolving Technologies,RouteNet-Fermi模型与性能数据
- T1 IETF draft-wei-nmrg-gnn-based-dtn-modeling-00 — GNN网络数字孪生建模框架,包括链路/流特征嵌入和消息传递机制
- T1 Towards Trustworthy 6G Network Digital Twins — arXiv 2026,可信数字孪生与Counterfactual What-If分析框架
- T1 Federated Learning for Digital Twin Applications — PeerJ CS,联邦学习在数字孪生中的应用框架
- T1 Federated Learning-Driven Digital Twin Framework for 6G Edge Networks — Springer,FL-DT框架数学基础与资源管理优化
- T1 An Overview on the Relationship Between Digital Twins and 6G — NIST,数字孪生与6G综合综述
- T2 DTL-GNN: Digital Twin Lightweight Method Based on GNN — MDPI Futures,DTL-GNN压缩方法与实验数据
- T2 Empowering Digital Twin for Future Networks with GNN — MDPI Futures,GNN+数字孪生综合综述
- T2 O-RAN Digital Twin Platform — EENewsEurope,O-DT平台进展
- T2 NVIDIA AI-RAN Alliance & 6G DT — NVIDIA Blog,Aerial Omniverse DT与AI-native空口
- T2 AI-RAN Digital Twin Testing — Electronics For You,R&S+NVIDIA硬件在环测试平台
- T2 OpenAirInterface — OAI官网,开源5G/6G RAN软件
- T2 AI-Driven Performance Evaluation of NDTs for 6G — ITU,NDT性能评测taxonomy与Polymetric Twinning Index
- T2 Split Federated Learning for 6G Enabled-Networks — UQTR,SL/FL/RL在6G中的综合应用
- T3 AI Model Compression Guide — RunPod,量化/剪枝/蒸馏压缩比参考数据
- T3 Awesome GNN Acceleration — PKU-DAIR SGL,GNN专用加速技术列表
- T1 NVIDIA Sionna RT: GPU-Accelerated Link-Level Simulation — NVIDIA官方文档,Sionna RT差分射线追踪架构与GPU需求
- T1 Gartner: Digital Twin Technology Forecast 2025–2030 — Gartner,数字孪生技术成熟度与市场规模预测
- T1 McKinsey: The Value of AI in Telecom Network Operations — McKinsey,电信网络AI投资回报率与运营效率提升分析
- T2 NVIDIA Data Center GPU Product Line — NVIDIA,A100/H100/B200/L40S数据中心GPU规格与定价
- T2 Ericsson: Network Digital Twin for 5G Optimization — Ericsson,5G站点数字孪生部署实践与能耗优化案例
- T2 VIAVI Solutions: Network Digital Twin Platform — VIAVI,网络数字孪生仿真与测试平台
- T2 China Mobile DTN (Digital Twin Network) White Paper v3.0 — 中国移动,DTN架构规范与5G商用部署实践
- T2 ABI Research: Telecom Network Digital Twin Market Forecast — ABI Research,电信数字孪生市场规模$1.1B→$14B预测(2024–2030)
- T3 华为昇腾计算产品规格 — 昇腾910B/910C AI处理器技术参数与生态适配
- T3 摩尔线程MTT S4000产品规格 — MTT S4000数据中心GPU技术参数与国产替代方案
- T1 Nokia Bell Labs: 16 NDT Use Cases for Network Operations — Nokia Bell Labs,系统性定义16个NDT用例场景,OPEX降低24.8%-29%研究数据
- T2 Telefonica Germany: Network Digital Twin at Scale — Telefonica德国28,000站点NDT部署,80%分析时间缩短与26%吞吐量提升
- T2 Deutsche Telekom: AI-Driven Digital Twin Platform — 德国电信AI-DT平台,25%运维成本降低与1,500+日微事件处理
- T2 AT&T Geo Modeler: PB-Level Synthetic Data Generation — AT&T地理建模数字孪生,PB级合成数据与40%停机时间降低
- T2 Verizon: Energy Optimization via Digital Twin — Verizon数字孪生能耗建模,年节能超1亿美元
- T2 Forward Networks: Network Digital Twin for Fault Prevention — Forward Networks,90%P1/P2故障预防与年节约700万美元
- T2 中华电信:跨年夜峰值容量优化 — 中华电信NDT部署,14%峰值容量提升案例
- T1 3GPP SA5 Release 20: NDT Standardization — 3GPP SA5 NDT标准化,Stage-1需求规范2025年6月冻结
- T1 O-RAN nGRG: NDT Technical Reports RR-2024-07 & RR-2024-09 — O-RAN联盟NDT功能需求与AI/ML用例报告
- T2 TM Forum IG1253: Autonomous Networks & Digital Twin — TM Forum自治网络NDT成熟度模型实施指南